Excel mostra "We found a problem with some content" su un XLSX che LibreOffice e qualunque reader fatto in casa aprono senza lamentarsi, perché Excel fa rispettare due cose che quegli altri ignorano: gli attributi richiesti dallo schema e le regole di unicità degli Open Packaging Conventions. Tre di quelle regole sono facili da violare in qualsiasi writer che combina parti generate con parti conservate: un <phoneticPr> ha bisogno del suo fontId, ogni nome di parte ottiene esattamente un Override in [Content_Types].xml, e due relazioni radice non devono mai condividere un identificatore come rId4. Questo articolo percorre ognuna e come HotXLS, il componente nativo per fogli di calcolo Excel per Delphi e C++Builder, scrive il pacchetto per rispettarla
Perché Excel rifiuta un pacchetto che tutti gli altri reader accettano?
Perché l'avviso di riparazione è un validatore di schema e di pacchetto, non un fallimento del parser. Un workbook può fare round trip attraverso la vostra libreria, attraverso LibreOffice e attraverso validatori XML, ed essere strutturalmente solido nel senso OPC usato nell'articolo sulla risoluzione delle relazioni OPC in XLSX: ogni parte raggiungibile, ogni target risolvibile. Apritelo tramite Workbooks.Open in un'istanza COM isolata con DisplayAlerts disattivato e la chiamata può comunque fallire di netto. In modo interattivo lo stesso file produce la solita finestra che propone di riparare, e il log di riparazione, quando Excel si degna di scriverlo, nomina la parte ma non la regola. Diverse violazioni indipendenti possono nascondersi dietro quell'unico avviso, ed Excel non le segnala una alla volta; rifiuta il workbook e lascia a voi trovarle e analizzarle. Quello che segue è ogni regola, il modo naturale di violarla e come HotXLS scrive invece il pacchetto, perché ognuna è una regola su cui qualsiasi writer XLSX in Delphi può inciampare
Regola 1: phoneticPr richiede fontId, anche quando è zero
L'elemento <phoneticPr> porta un attributo fontId dichiarato use="required" in ECMA-376 Part 1 §18.4.3, e un valore di 0 è un indice di font legittimo, non un'assenza. Un writer che tratta lo zero come "non impostato" ed emette l'attributo solo quando Sheet.PhoneticFontId > 0 segue un riflesso naturale in Delphi, dato che i campi interi valgono zero per default, ma produce <phoneticPr type="noConversion"/> per qualsiasi workbook il cui font fonetico sia il primo font in styles.xml, facile da incontrare perché l'indice 0 è semplicemente il primo font. Excel poi rifiuta al ritorno un valore che aveva scritto lui stesso
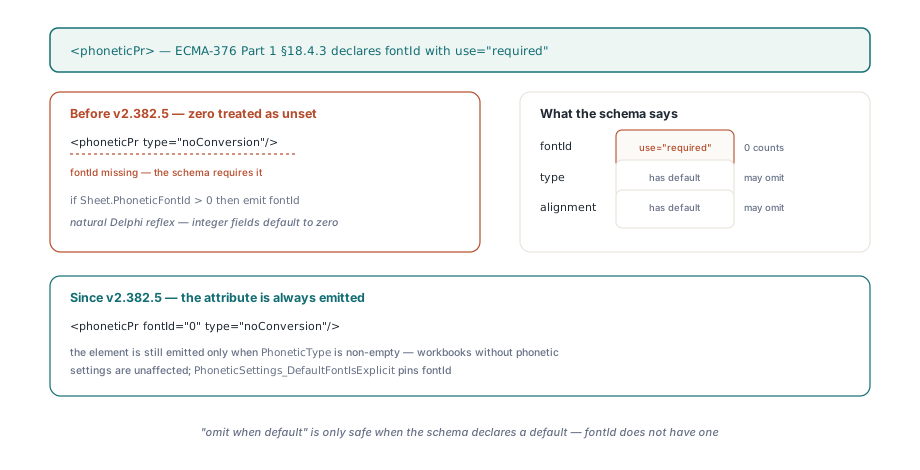
// Il riflesso naturale: zero trattato come non impostato, fontId omesso
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas, writer del foglio di lavoro — l'attributo è obbligatorio, zero compreso
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS emette l'elemento solo quando TXLSXWorksheet.PhoneticType non è vuoto, quindi i workbook che non hanno mai avuto impostazioni fonetiche restano intatti. Impostate PhoneticFontId a zero su un foglio nuovo, salvate, e xl/worksheets/sheet1.xml porta <phoneticPr fontId="0". La lezione più ampia è che "ometti quando è il default" è sicuro solo quando lo schema dichiara quel default; type e alignment hanno un default in quell'elemento, fontId no
Regola 2: un solo Override per nome di parte in [Content_Types].xml
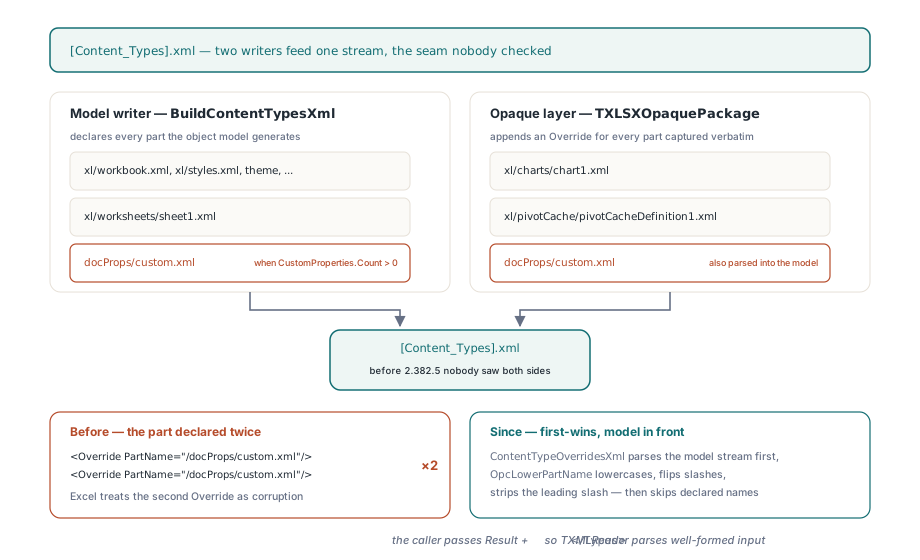
Lo stream dei content type può dichiarare ogni nome di parte al massimo una volta, ed Excel tratta un secondo Override per lo stesso PartName come corruzione anche quando entrambe le voci portano lo stesso ContentType. HotXLS ha due writer che alimentano quello stream. BuildContentTypesXml dichiara ogni parte generata dal modello a oggetti: workbook, styles, shared strings, theme, fogli di lavoro e, quando TXLSXWorkbook.CustomProperties.Count > 0, /docProps/custom.xml. Con PreserveUnsupportedParts attivo, TXLSXOpaquePackage aggiunge poi un Override per ogni parte che ha catturato alla lettera dal pacchetto sorgente, così quei byte restano dichiarati in uscita. La collisione è una parte che vive da entrambe le parti. Le proprietà personalizzate del documento vengono analizzate nel modello, ma il docProps/custom.xml del pacchetto sorgente viene catturato anche in modo opaco, quindi un merge ingenuo lo dichiara due volte, e le parti chart e pivot cache possono finire nello stesso punto quando il modello rigenera una parte che anche il livello opaco aveva conservato. Un writer opaco senza visibilità su ciò che il modello ha già scritto non può saperlo, ed è per questo che ContentTypeOverridesXml riceve quella visibilità
<!-- Cosa produce un merge ingenuo -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS passa l'XML generato dentro ContentTypeOverridesXml e lascia che il writer opaco lo analizzi prima di emettere qualsiasi cosa. Due dettagli reggono la correttezza. OpcLowerPartName converte in minuscolo, trasforma le barre rovesciate in barre normali e rimuove le barre iniziali prima del confronto, perché i nomi di parte OPC si confrontano senza distinguere maiuscole e minuscole e il modello li scrive con una barra iniziale mentre il livello opaco memorizza i nomi delle voci ZIP senza. E il chiamante in BuildContentTypesXml passa Result + '</Types>', chiudendo il documento parzialmente costruito così che TXMLReader veda un input ben formato invece di uno stream troncato. La regola che ne esce è che vince il primo, con il modello davanti: quello che il modello a oggetti dichiara è autorevole, e la riproduzione opaca si limita a riempire i vuoti
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Analizza lo stream generato dal modello e raccogli ogni PartName dichiarato.
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // già dichiarata, oppure è una parte rels
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Regola 3: gli Id di relazione sono univoci dentro una parte relationships
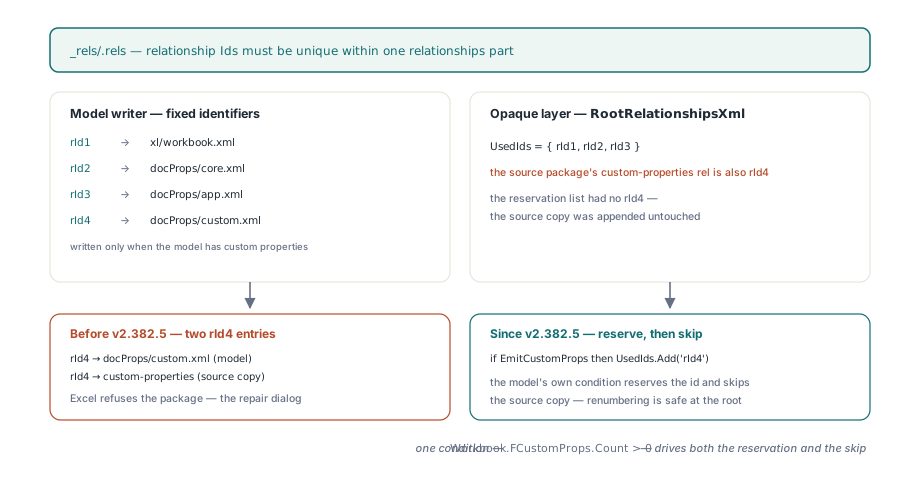
Ogni Relationship in una parte .rels ha bisogno di un Id univoco all'interno di quella parte, ed Excel rifiuta il pacchetto quando due ne condividono uno. HotXLS scrive il _rels/.rels a livello di pacchetto con identificatori fissi: rId1 per il workbook, rId2 e rId3 per le proprietà del documento core ed extended, e rId4 per le proprietà personalizzate quando il modello ne ha. Il pacchetto opaco aggiunge poi tutte le relazioni radice che ha conservato dalla sorgente, rinumerando ogni identificatore già presente in una lista UsedIds. Se quella lista conosce solo rId1 fino a rId3, e non sa che il modello sta per emettere la propria relazione delle proprietà personalizzate, un pacchetto sorgente la cui relazione delle proprietà personalizzate è anch'essa rId4, che è quello che Excel scrive per default, esce con due voci rId4 che puntano allo stesso target. RootRelationshipsXml quindi prenota rId4 e salta la copia della sorgente ogni volta che il modello emette proprietà personalizzate. Il chiamante, BuildRootRelsXml, passa Workbook.FCustomProps.Count > 0 come secondo argomento, così la prenotazione e il salto sono guidati dalla stessa condizione che decide se il modello emette rId4 o no. Rinumerare è sicuro alla radice del pacchetto perché nulla dentro il workbook referenzia gli identificatori delle relazioni radice per nome; lo stesso trucco sarebbe sbagliato un livello più sotto, dove gli attributi r:id in workbook.xml si legano agli identificatori nella parte delle relazioni del workbook, ed è per questo che MergeWorkbookRelationshipsXml mantiene una mappa di identificatori separata
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // riservato dal writer del modello
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // Le proprietà personalizzate sono del modello; non riprodurre la copia sorgente.
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // rIdN libero più basso
  UsedIds.Add(String(Id));
  ...
end;
Cosa hanno in comune le tre regole?
Tutte e tre proteggono contro un writer con due sorgenti e nessun unico proprietario degli invarianti del pacchetto. Il modello a oggetti genera le parti che capisce; il livello opaco riproduce quelle che non capisce, così che un round trip conservi grafici, pivot cache, XML personalizzato e tutto il resto descritto nelle note sul round trip senza perdite di theme, extLst e calcChain. Ogni lato può essere coerente per conto proprio. I vincoli che OPC impone all'intero pacchetto, nomi di parte Override univoci e identificatori di relazione univoci per parte, esistono solo nella giuntura dove i due vengono concatenati, quindi qualcosa deve possedere la giuntura. Il bug del fontId ha la stessa forma un livello più sotto: un writer può sapere cosa vuole omettere e non consultare mai lo schema che dice che non può. HotXLS risolve con una precedenza fissa invece di un'euristica di merge. Il modello scrive per primo, e il livello opaco vede cosa è stato scritto e cede su qualsiasi collisione. Gli invarianti sono anche economici da controllare dall'esterno: leggete [Content_Types].xml e ogni voce .rels di un pacchetto salvato e fallite su qualsiasi PartName, Extension o Id duplicato. Quel controllo non richiede Excel e copre le due regole di unicità; la regola del fontId ha ancora bisogno di un validatore di schema
Aree di stampa che sono formule, non intervalli
L'area di stampa è l'altra cosa che Excel confronta su una copia salvata: un template la cui _xlnm.Print_Area Excel riporta come $A$1:$J$29 deve riportarla identica dopo un round trip. Dietro ci sono due trappole. In importazione, uno strip del prefisso che taglia tutto fino al primo ! non quotato trasforma un'area di stampa dinamica come OFFSET('Print Data'!$A$1,0,0,2,2) in $A$1,0,0,2,2), e fa perdere il prefisso solo al primo segmento di un'unione qualificata come 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2. In esportazione, anteporre il nome del foglio una volta sola all'intera PrintArea memorizzata dà a un'unione semplice $A$1:$B$2,$D$1:$E$2 un primo segmento qualificato e uno nudo, cosa che Excel non accetta come definizione di _xlnm.Print_Area secondo ECMA-376 Part 1 §18.2.5
// Importazione: togli il prefisso solo quando ciò che resta è uno sqref semplice
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) viene restituito intatto

// Esportazione: qualifica ogni segmento separato da virgola, o nessuno
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // una formula: emetti alla lettera
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
La regola di abbinamento è la stessa da entrambi i lati: un'area di stampa è un intervallo nudo solo se ogni segmento si analizza come tale, altrimenti è una formula e viaggia alla lettera. Con quella regola, la base con nome, la base qualificata dal foglio e l'unione sopravvivono a ripetuti cicli di salvataggio e riapertura. Come le aree di stampa interagiscono con l'impostazione di pagina e il resto del modello di stampa è trattato nell'articolo su protezione del foglio, impostazione di pagina e stampa
Come si trova la regola a cui Excel sta obiettando?
Partite dal presupposto che il vostro validatore abbia torto, visto che è passato. Il validatore dell'Open XML SDK nominerà una violazione di schema come il fontId mancante, con la parte e l'XPath, e il livello di packaging che gli sta sotto si rifiuta del tutto di aprire un pacchetto con voci content type duplicate, quindi eseguitelo prima di qualsiasi altra cosa. Quando tace e Excel ripara comunque, fate una bisezione del pacchetto: scompattate, cancellate una parte, la sua relazione e il suo Override, ricompattate e riaprite, dimezzando ogni volta l'insieme dei candidati finché l'avviso non sparisce. Le tre violazioni qui sopra saltano fuori in quell'ordine, e nessuna sarebbe visibile nel file riparato che Excel offre di salvare, dato che la riparazione elimina o rinumera in silenzio le voci incriminate. Due scelte di progetto nel writer di HotXLS vale la pena conoscere. La deduplicazione è a favore del primo, con il modello davanti, quindi se il pacchetto sorgente dichiarava un content type diverso per una parte che anche il modello genera, vince la dichiarazione del modello e quella della sorgente viene scartata, il che è corretto per le parti che HotXLS rigenera e non è un merge generale. E il passaggio extra di TXMLReader sullo stream dei content type generato gira a ogni salvataggio con PreserveUnsupportedParts attivo, un costo piccolo su uno stream che raramente supera qualche kilobyte. Con queste regole in piedi, un template di prestito da 4805 formule salvato sia dalle build Win32 che Win64 si apre in Excel senza avvisi, ricalcola con zero mancate corrispondenze e riporta la stessa area di stampa dell'originale
Se scrivi XLSX da Delphi per conto tuo, la checklist è breve: emetti ogni attributo che lo schema segna come obbligatorio indipendentemente dal suo valore, dichiara ogni nome di parte una volta sola e tieni un'unica lista di identificatori usati per parte relationships attraverso tutti i writer che la toccano. Se preferisci che quella lista esista già e sia testata contro Excel invece che solo contro il tuo reader, il writer di pacchetti descritto qui è distribuito nel componente spreadsheet per Delphi di HotXLS, insieme al round trip delle parti opache che ha reso la giuntura degna di essere sorvegliata fin dall'inizio