Un timeout di riconoscimento di 5.000 ms su una chiamata Tesseract in-process non significa che la chiamata torni dopo cinque secondi. Con un grande set di modelli multilingua, il thread chiamante può restare dentro la libreria nativa ben oltre quella soglia, perché il monitor di avanzamento che impone la scadenza viene interrogato mentre le parole vengono riconosciute, e sia il caricamento dei modelli sia l'analisi del layout di pagina avvengono prima della prima interrogazione. Quello scarto, un callback di cancel il cui tipo di ritorno C è un singolo byte, e un iteratore che consegna memoria che non dovete mai liberare sono il lavoro vero di legare la C API di Tesseract a Delphi. Il resto è cablaggio
Collegare la DLL Tesseract a un livello di testo HotPDF
HotPDF espone il percorso in-process come HPDFCreateTesseractDLLOCREngine nell'unità HPDFTesseractRecognition. La factory carica una DLL Tesseract che esporta la C API, pilota TessBaseAPIInit2, TessBaseAPIRecognize e l'iteratore dei risultati, e restituisce un IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer prende quel motore e aggiunge un livello di testo Unicode invisibile e ricercabile alle pagine scansionate, la stessa chiamata che attraversa ogni motore OCR di HotPDF
La factory valida per tempo. Il file DLL e la directory tessdata devono esistere. L'identificatore di lingua può contenere solo lettere ASCII, cifre, _ e +, e ogni modello in una combinazione come chi_sim+eng richiede un file .traineddata corrispondente. Tutti i 21 export richiesti devono risolversi prima che vi venga restituito un motore. Gli errori di configurazione sollevano EArgumentException, con export o modello mancante riportato per nome; una DLL che non si carica solleva EOSError con il codice di errore Windows e un suggerimento di controllare architettura e dipendenze
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Un'applicazione Win64 richiede una DLL a 64 bit; il nome del file dipende dalla vostra build,
  // e le DLL di dipendenza stanno nella stessa cartella
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // usa THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Una lista pagine vuota significa tutte; le pagine che portano già testo vengono saltate
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default imposta PageSegMode a tpsAuto, EngineMode a temDefault, TimeoutMilliseconds a 60.000 e MaxPixels a 16.777.216. Quel budget di pixel morde prima di quanto ci si aspetti. Una pagina US Letter alla default di 300 DPI si renderizza in 2.550 × 3.300 pixel, circa 8,4 milioni, e ci sta. Immaginate di alzare la stessa pagina a 600 DPI: diventa 5.100 × 6.600, circa 33,7 milioni di pixel, e il motore la rifiuta con Invalid Tesseract DLL OCR request or pixel budget prima che Tesseract veda mai l'immagine. O alzate MaxPixels (il tetto è 67.108.864) o restate a 300 DPI, che per il corpo del testo è abbondante; ogni lato è limitato anche a 32.767 pixel
La DLL viene caricata con LoadLibraryEx e i flag di ricerca per la cartella della DLL stessa più le directory sicure di default. Le librerie immagini da cui Tesseract dipende possono quindi stare accanto a lei, e non dovete mai toccare PATH né fidarvi della directory corrente. HotPDF non include né scarica alcun runtime OCR o modello linguistico; a fornirli pensate voi
Cosa cambia la via DLL rispetto a tesseract.exe
Lo stesso recognizer è raggiungibile anche attraverso l'adapter esterno tesseract.exe che scrive una BMP e analizza il TSV. Entrambi gli adapter alimentano una sola pipeline del livello di testo, quindi mappatura delle coordinate, filtro di confidenza e la scrittura tutto-o-nulla si comportano allo stesso modo. Ciò che differisce è come entrano i pixel, come escono le parole, e cosa succede quando il recognizer si comporta male
| Aspetto | Adapter tesseract.exe | Adapter DLL Tesseract |
|---|---|---|
| Factory | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Pixel in ingresso | File BMP in una directory temporanea privata | Buffer grayscale a 8 bit in memoria |
| Parole in uscita | TSV a livello parola, limitato a 64 MiB | Iteratore dei risultati, UTF-8 per parola |
| Baseline | Non nel TSV; le stima la pipeline | Trasmesse da TessPageIteratorBaseline |
| Segmentazione di pagina e modalità motore | Overload di THPDFTesseractOptions, inviati come --psm e --oem | THPDFTesseractOptions, inviati a TessBaseAPISetPageSegMode e TessBaseAPIInit2 |
| Budget di pixel | MaxPixels quando le opzioni vengono passate | MaxPixels sempre, più 32.767 pixel per lato |
| Timeout | Duro: il processo figlio viene terminato | Cooperativo: Tesseract deve accorgersene |
| Isolamento di crash e memoria | Processo separato | Nessuno, condivide il vostro spazio di indirizzi |
Un costo resta in mano alla DLL. Ogni chiamata Recognize crea la propria istanza API ed esegue TessBaseAPIInit2, quindi i modelli linguistici vengono inizializzati per ogni pagina. La cache dei file attutisce il ricaricamento, eppure con un grande set di modelli multilingua resta il costo fisso più grande per pagina, e va a carico della scadenza di riconoscimento. Il motore della DLL RapidOCR in-process prende la scelta opposta e tiene i propri modelli ONNX residenti per tutta la vita del motore, mentre i problemi di confine (C ABI, buffer in prestito, lavoro nativo che non potete interrompere) appartengono alla stessa famiglia
E allora quale va in produzione? Per uno strumento desktop o un job a lotti che lavora qualche centinaio di scansioni, la DLL è la scelta migliore: niente avvio di processo per pagina, niente bitmap temporanea su disco, e baseline vere per le righe storte. Un server a lunga permanenza che accetta PDF da sconosciuti dovrebbe restare su tesseract.exe, perché un crash nativo o un'allocazione fuori controllo lì abbatte un processo figlio invece del vostro servizio
Perché Delphi non può copiare la struct monitor di Tesseract?
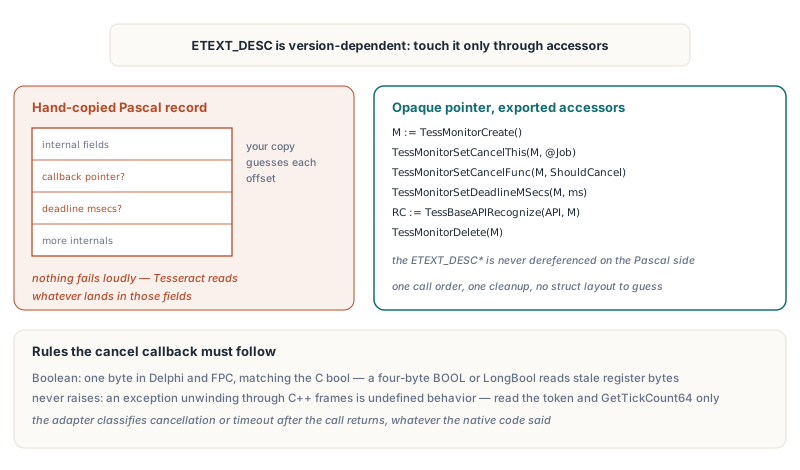
Delphi non può replicare in sicurezza il monitor di avanzamento di Tesseract, perché ETEXT_DESC porta campi interni che variano tra build di Tesseract. Un record tradotto a mano da un header mette il callback di cancel e la scadenza agli offset che quel header usava. Eseguetelo contro una build diversa e Tesseract legge il vostro puntatore al callback da un campo che ora significa altro, o non trova mai la scadenza, e il riconoscimento semplicemente gira fino in fondo
L'adapter di HotPDF quindi tratta il monitor come un puntatore opaco e lo tocca solo attraverso funzioni esportate: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs e TessMonitorDelete. Lo schizzo qui sotto è codice di binding vostro anziché API HotPDF; le sue dichiarazioni rispecchiano quelle che l'adapter risolve con GetProcAddress
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, mai dereferenziato
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // Stato del job vostro, non un tipo HotPDF
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Gira sullo stack di Tesseract: leggete un flag e l'orologio, non sollevate mai
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Uso, con i puntatori a funzione risolti da GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Lo schizzo dichiara il callback come Boolean, un byte sia in Delphi sia in Free Pascal, che corrisponde al bool C in TessCancelFunc. Il BOOL Windows a quattro byte e il LongBool Delphi sembrano intercambiabili e sono un tipo diverso: quando un lato scrive un singolo byte e l'altro ne legge quattro, i tre byte alti sono ciò che il registro conteneva prima, e un false può arrivare come true. TessPageIteratorBoundingBox restituisce un int, dichiarato come Integer sul lato Pascal, quindi leggete il tipo C di ogni valore di ritorno invece di presumere una regola sola per tutta l'API
Il callback inoltre non solleva mai. Un'eccezione Delphi che fa unwinding attraverso i frame C++ di Tesseract è comportamento indefinito. Il callback di HotPDF legge solo il token di cancellazione e un valore monotono GetTickCount64, e l'adapter trasforma l'esito in una diagnostica di cancellazione o timeout dopo che TessBaseAPIRecognize torna. Esegue quel controllo sia che il codice di ritorno nativo sia stato 0 sia che non lo sia stato
Quali puntatori nativi possiede il lato Delphi?
L'adapter DLL Tesseract di HotPDF possiede tre oggetti nativi per richiesta (l'istanza API, il monitor e l'iteratore dei risultati) e prende in prestito tutto il resto. Ogni chiamata Recognize crea il proprio insieme e lo rilascia in un blocco finally in un ordine fisso: TessResultIteratorDelete, poi TessMonitorDelete, poi TessBaseAPIDelete. Rilasciare l'interfaccia del motore chiama FreeLibrary sulla DLL
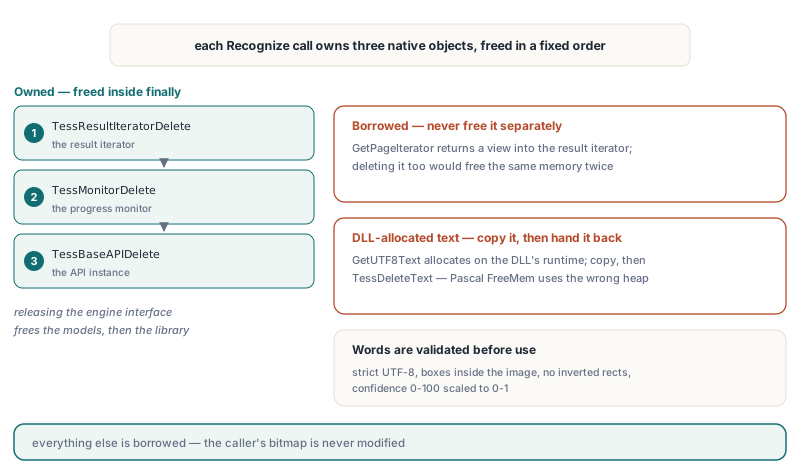
TessResultIteratorGetPageIteratorrestituisce una vista dentro l'iteratore dei risultati anziché un nuovo oggetto. L'adapter la usa perTessPageIteratorBoundingBoxeTessPageIteratorBaselinee non la libera mai; cancellarla anche lei rilascerebbe la stessa memoria due volteTessResultIteratorGetUTF8Textrestituisce una stringa allocata dal runtime della DLL stessa. L'adapter la decodifica e la restituisce attraversoTessDeleteTextin un bloccofinally, perché unaFreeMemPascal la rilascerebbe sull'heap sbagliato- Il testo delle parole passa per una decodifica UTF-8 strict con prima un controllo di lunghezza. Una parola con caratteri di controllo, UTF-8 malformato, una box fuori dall'immagine, un rettangolo invertito o una confidenza fuori da 0–100 fa fallire la richiesta; l'adapter non la sistema
- Il testo per richiesta è limitato a 1.048.576 code unit UTF-16, e il conteggio di parole deve stare nel budget che
ApplyLoadedOCRTextLayerconsegna con ogni pagina
La confidenza arriva come 0–100 e viene scalata a 0–1, quindi THPDFOCRTextLayerOptions.MinimumConfidence significa la stessa cosa per ogni motore. Quando Tesseract riporta una baseline, entrambi gli estremi vengono trasmessi, e per una parola prevalentemente verticale la larghezza della box viene usata come altezza del testo. Senza baseline la pipeline del livello di testo ripiega sulla propria stima geometrica, esattamente come fa per l'input TSV
Controllare l'intervallo delle opzioni enum prima che raggiungano la DLL
La factory copia i byte grezzi di PageSegMode e EngineMode in una Integer prima di controllarne l'intervallo. Un compilatore è autorizzato a presumere che una variabile enum tenga sempre un valore dichiarato, quindi un test come Ord(X) > Ord(High(T)) scritto direttamente sull'enum può venire piegato a una costante false. Quegli ordinali raggiungono la DLL come interi semplici: THPDFTesseractPageSegMode segue la numerazione di segmentazione pagina di Tesseract da 0 a 13 e THPDFTesseractEngineMode la numerazione delle modalità motore da 0 a 3. Un record di opzioni azzerato con FillChar, letto da uno stream, o riempito da C++Builder attraverso un cast a intero può portare un byte come 200, e validare la copia trasforma quello in una EArgumentException al tempo della factory. La factory rifiuta anche tpsOSDOnly e tpsAutoOnly, che non restituiscono parole, e richiede osd.traineddata per tpsAutoOSD e tpsSparseTextOSD
Che cosa garantisce davvero il timeout di riconoscimento?
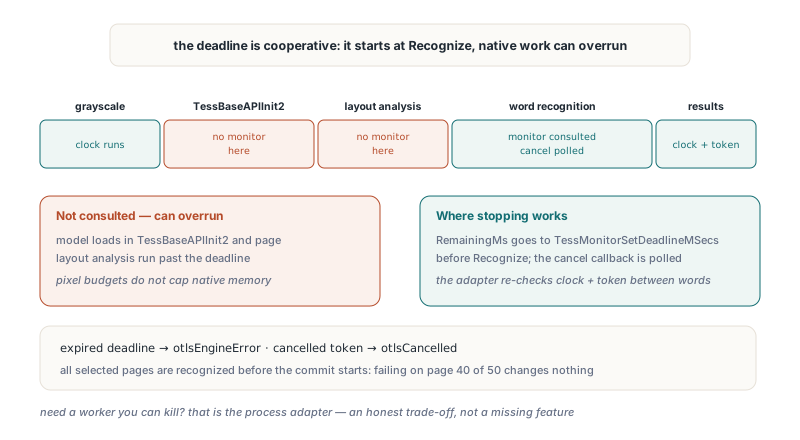
Il timeout della DLL Tesseract è cooperativo: HotPDF può fermare il proprio lavoro e chiedere a Tesseract di fermarsi, ma non può forzare il codice nativo a tornare. L'orologio parte quando Recognize comincia, quindi la conversione in grayscale e l'inizializzazione dei modelli attingono allo stesso budget del riconoscimento. L'adapter controlla il tempo trascorso e il token di cancellazione ogni 64 righe durante la conversione in grayscale, dopo l'inizializzazione, e prima di ogni parola mentre percorre i risultati. Subito prima di TessBaseAPIRecognize passa i millisecondi rimanenti a TessMonitorSetDeadlineMSecs
Lo scarto siede dentro le chiamate native. Tesseract consulta il proprio monitor solo durante il riconoscimento delle parole, quindi dentro TessBaseAPIInit2 o l'analisi del layout un caricamento lento di modello o un layout patologico può superare la scadenza prima che il timeout venga riportato. I budget di pixel e output non limitano nemmeno l'uso di memoria della libreria nativa stessa. Quando vi serve un worker che potete uccidere sul posto, l'adapter di processo è lo strumento giusto
La segmentazione di pagina è dove l'adapter DLL dà i suoi frutti sull'input ostico. Moduli, etichette e tabelle scansionate con campi sparsi spesso riconoscono meglio con tpsSparseText che con la segmentazione automatica, che prova ad assemblare colonne e paragrafi che non ci sono. Il timeout qui sotto è corto per una pagina di modulo e deve comunque coprire l'inizializzazione dei modelli
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // campi sparsi, nessun assemblaggio colonne
  TessOptions.EngineMode := temLSTMOnly;     // richiede modelli LSTM in tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // include l'inizializzazione dei modelli
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Un timeout emerge come otlsEngineError con Tesseract DLL OCR timed out nella diagnostica. Un token impostato attraverso THPDFOCRTextLayerOptions.CancellationToken emerge come otlsCancelled. In entrambi i casi ApplyLoadedOCRTextLayer riconosce ogni pagina selezionata prima di iniziare la scrittura, così un fallimento alla pagina 40 di 50 lascia il documento caricato esattamente com'era. tpsSingleLine, tpsSingleBlock e tpsSparseText cambiano solo la segmentazione; nessuna di esse raddrizza una scansione storta
Free Pascal e Lazarus: pixel obsoleti e cinese perduto
Entrambe le factory Tesseract funzionano nelle build Windows Free Pascal e Lazarus Win32 e Win64 una volta che il pacchetto Lazarus viene ricompilato per l'architettura bersaglio; il porting generale è coperto in HotPDF su Free Pascal e Lazarus Win64. La gestione dell'input è dove FPC si comporta diversamente
Una TBitmap LCL scritta attraverso scanline può aggiornare la propria immagine grezza senza rinfrescare l'handle bitmap Windows, così GetDIBits su quell'handle restituisce i vecchi pixel. Il sintomo sconcerta: il testo disegnato direttamente su una bitmap viene riconosciuto, una pagina renderizzata attraverso scanline non produce parole. Sotto FPC l'adapter DLL legge uno snapshot consapevole del formato attraverso CreateIntfImage, che rispetta il formato pixel e l'ordine delle righe dell'immagine grezza. La build Delphi conserva la via GetDIBits su una copia privata a 24 bit, e nessuna delle due build modifica la bitmap del chiamante
L'adapter tesseract.exe incontra un problema diverso. La TStringList di FPC conserva stringhe ANSI, quindi assegnare il testo TSV decodificato UTF-8 a Lines.Text scarta ogni carattere cinese o del piano supplementare che la code page ANSI di sistema non può rappresentare. La via FPC tiene il TSV come byte UTF-8, toglie il BOM a livello di byte e decodifica ogni parola a UnicodeString per conto suo. L'adapter DLL non incontra mai il problema, dato che decodifica ogni parola direttamente dall'iteratore
L'adapter DLL Tesseract viene spedito accanto agli adapter di processo e al motore OCR integrato in HotPDF per Delphi, C++Builder e Free Pascal. Edizioni e download sono elencati nella pagina HotPDF Delphi PDF Component