Una pipe che non riporta mai end-of-file è un difetto strano da cacciare in una funzionalità OCR. Un thread della vostra applicazione legge lo standard output di un programma ausiliario e aspetta che ReadFile fallisca con ERROR_BROKEN_PIPE. Un altro thread avvia tesseract.exe attraverso CreateProcess con bInheritHandles impostato a True, perché è così che si consegna a un processo figlio un file per il suo standard error. Il lato scrittura della pipe del programma ausiliario era ereditabile, quindi Tesseract ora possiede una copia, e il thread in lettura resta appeso finché Tesseract finisce la sua pagina — che, su una scansione a 300 DPI con due modelli linguistici caricati, non è affatto immediato
Un recognizer esterno porta più del solo appendimento: cosa può vedere il figlio, cosa fare con output parzialmente valido, come trasformare box in pixel in testo PDF ricercabile. Il motore OCR integrato a template matching copre apposta lettere e cifre ASCII a stampa. Nomi accentati, contratti cinesi e archivi multilingua richiedono modelli linguistici addestrati, e Tesseract è il candidato abituale perché è un programma da riga di comando che potete installare accanto al vostro eseguibile
Innestare Tesseract nel text layer OCR di HotPDF
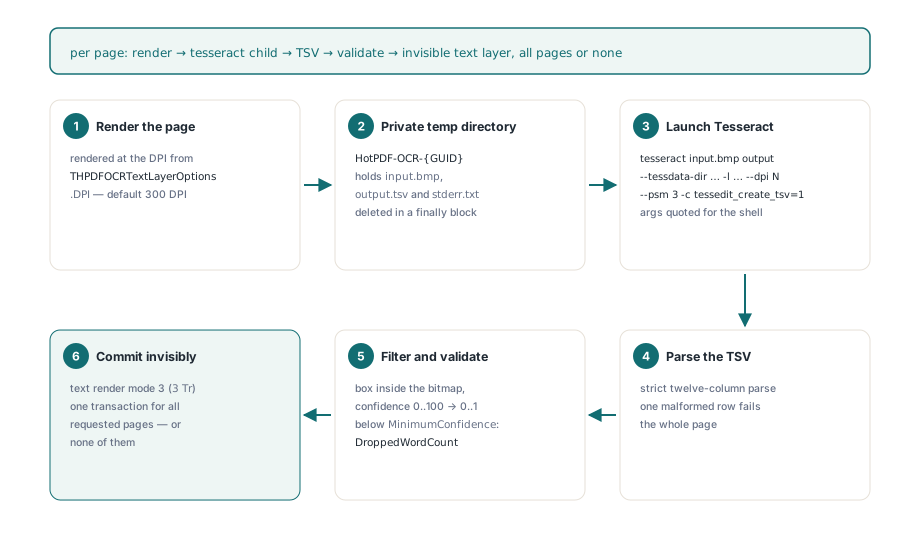
HotPDF avvolge un eseguibile Tesseract installato localmente in un IHPDFOCREngine attraverso HPDFCreateTesseractOCREngine nell'unità HPDFTesseractRecognition. Passate quel motore a THotPDF.ApplyLoadedOCRTextLayer, che renderizza ogni pagina richiesta, esegue Tesseract una volta per pagina, filtra le parole e scrive un layer di testo Unicode invisibile per tutte le pagine richieste in una transazione sola, o per nessuna di loro. Mappatura delle coordinate, rotazione, filtro di confidenza e la scrittura sono la pipeline che il motore integrato usa già; cambia solo il riconoscimento
La factory solleva EArgumentException prima che qualsiasi pagina venga toccata. L'eseguibile e la directory tessdata devono esistere, il timeout deve stare tra 1 e 3.600.000 millisecondi, e la lingua può contenere solo lettere ASCII, cifre, _ e +, perché finisce su una riga di comando: eng+chi_sim è legittimo, un valore con virgolette o spazi è un'iniezione in attesa di accadere. Un secondo overload prende un record THPDFTesseractOptions. Il suo Default dà --psm 3, --oem 3, 60 secondi per pagina e un tetto di 16.777.216 pixel, e rifiuta tpsOSDOnly e tpsAutoOnly, le due modalità che non restituiscono parole
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16.777.216 px
  TessOptions.TimeoutMilliseconds := 120000;    // vale per ogni pagina
  // alza EArgumentException per un eseguibile o una cartella tessdata mancanti,
  // un identificatore di lingua sbagliato, o opzioni fuori dai loro intervalli
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // modelli uniti con '+'
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // una lista pagine vuota significa tutte; le pagine che hanno già testo vengono saltate
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Fate l'aritmetica dei pixel una volta. Una pagina A4 a 300 DPI è circa 2.481 per 3.508 pixel, circa 8,7 milioni, e ci sta. Una pagina A3 alla stessa risoluzione è circa 3.508 per 4.961, vicino a 17,4 milioni, quindi fallisce con una diagnostica di budget pixel e l'esecuzione finisce come otlsEngineError. L'overload che prende solo un timeout non applica nessun tetto di pixel. Per un servizio che accetta file dall'esterno, tenete l'overload con opzioni e alzate MaxPixels (fino a 67.108.864) o abbassate THPDFOCRTextLayerOptions.DPI deliberatamente quando i formati grandi sono previsti
Per pagina, il motore crea una directory privata HotPDF-OCR-{GUID} sotto il percorso temp, salva la bitmap come input.bmp ed esegue tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, aggiungendo --oem quando una modalità motore è impostata. I percorsi vengono virgolettati con le regole Windows per backslash e virgolette interne, e --dpi porta la risoluzione di rendering così Tesseract non la indovina mai. Tesseract e i suoi file .traineddata non vengono distribuiti insieme; fornirli è compito dell'applicazione. Sulle nostre macchine di test Linux il recognizer gira da un pacchetto a livello utente del binario, della sua chiusura di librerie condivise e della cartella tessdata, perché contare su /usr/bin/tesseract funziona solo dove qualcuno ha installato il pacchetto di sistema
Perché una riga TSV rotta svuota l'intera pagina?
L'adapter Tesseract fa fallire l'intera pagina alla prima riga malformata, perché una lista di parole parzialmente parsificata produce un layer di testo in disaccordo con l'immagine, e niente nel PDF salvato dice quali parole sono andate perse. L'output deve decodificarsi come UTF-8 strict senza NUL incorporati. La prima riga deve eguagliare l'header a dodici colonne di Tesseract, da level a text, una volta tolto un eventuale byte order mark. Ogni riga deve spezzarsi in esattamente dodici campi, e lo split si ferma dopo l'undicesimo tab, così un tab dentro il testo riconosciuto atterra nel campo del testo invece di creare una tredicesima colonna, dove il controllo dei caratteri di controllo qui sotto la rifiuta poi
Solo le righe di livello 5 sono parole; le righe di pagina, blocco, paragrafo e riga vengono saltate, come le parole vuote o di puro whitespace. Una parola che contiene un carattere di controllo (sotto U+0020, o da U+007F a U+009F) fa fallire la pagina. Il resto richiede geometria intera, una confidence parsificata con formato invariante così un'applicazione con locale tedesco legge comunque 93.5, una box interamente dentro la bitmap, e una confidence da 0 a 100. Una parola valida seguita da una riga rotta produce zero parole
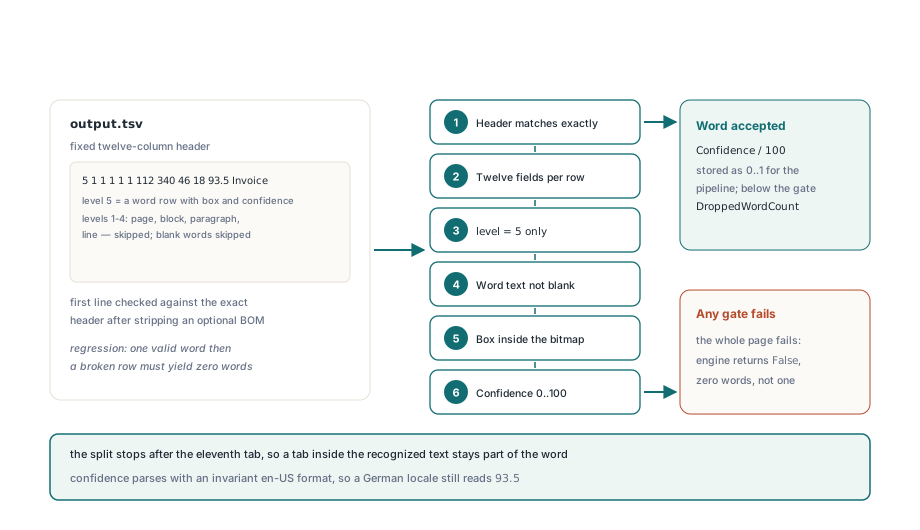
Una riga strana fa quindi fallire l'intera esecuzione e lascia ogni pagina intatta. È il compromesso giusto. Rieseguire costa poco; un PDF ricercabile dove una ricerca per numero fattura manca dell'unica pagina che conta tende a emergere mesi dopo, nelle mani di qualcun altro
L'ultimo passaggio incontra anche un default che potreste non aspettarvi. Tesseract riporta la confidence da 0 a 100, la pipeline divide per 100, e THPDFOCRTextLayerOptions.MinimumConfidence fa default a 0,5, quindi qualsiasi parola sotto 50 atterra in Info.DroppedWordCount invece che sulla pagina. Su una scansione pulita quel piano minimo è sensato. Su un fax rumoroso può togliere una gran quota del testo, quindi confrontate Info.ReceivedWordCount con Info.AcceptedWordCount prima di abbassarlo
Eseguire di nuovo OCR su un file che ha già testo
SkipPagesWithText è True per default, e quella cosa prende in contropiede la gente alla seconda passata. Supponete che un lotto sia stato elaborato con eng e ora richieda eng+deu: ogni pagina porta già testo invisibile, quindi Info.SkippedPageCount eguaglia il conteggio delle pagine. HotPDF marca il content stream che scrive come proprio layer OCR, e ReplaceExistingOCRTextLayer usa quella marca per riconoscere di nuovo quelle pagine, scartando il vecchio layer e conservando il contenuto originale della pagina
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // sostituisce il nostro layer precedente
Options.UseOptionalContentGroup := True;      // layer chiamato 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Un file su cui un driver di scanner ha già girato OCR non porta una marca simile, quindi le sue pagine contano ancora come pagine con testo. Spegnere SkipPagesWithText impilerebbe un secondo layer invisibile sul primo, e ogni hit di ricerca comparirebbe due volte. Lasciate stare quei file
Quali handle eredita il processo Tesseract?
Il processo figlio Tesseract eredita da HotPDF esattamente due handle: uno aperto su NUL per standard input e output, e uno per stderr.txt nella directory privata. Quell'appendimento viene da CreateProcess in sé: bInheritHandles = True è richiesto per passare gli handle standard, e da solo passa ogni handle ereditabile dell'ospite, comprese pipe, file ed eventi aperti da codice non correlato. HotPDF usa STARTUPINFOEX con una lista di attributi che porta PROC_THREAD_ATTRIBUTE_HANDLE_LIST e il flag EXTENDED_STARTUPINFO_PRESENT. bInheritHandles resta True, eppure attraversano solo gli handle elencati
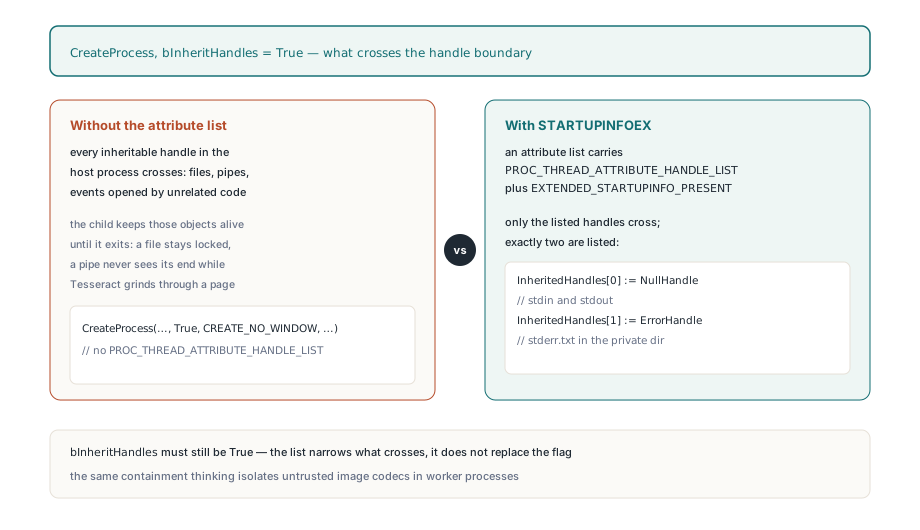
Lo stesso pattern appartiene a ogni altro processo figlio che la vostra applicazione avvia, dato che un solo launcher che eredita tutto basta per appendere ogni lettore di pipe nel processo:
// Pattern per le vostre chiamate CreateProcess (frammento: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir e ProcessInfo sono dichiarati altrove).
// Le RTL Delphi più vecchie non dichiarano le funzioni della lista di attributi; aggiungete
// le vostre dichiarazioni external da kernel32 se il compilatore non le trova
// Controllate ogni risultato BOOL in codice di produzione
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // creato con bInheritHandle = True
  HandleList[1] := ErrorHandle;        // idem
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... impostate dwFlags e hStdInput / hStdOutput / hStdError come al solito ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // richiesto comunque con una lista di handle
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // dopo l'uscita del figlio: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Gli script bridge aggiungono un altro dettaglio Windows. Un launcher Python può avviare un secondo processo interprete, e terminare il processo che avete creato lascia quello in vita. Quando al motore viene dato un percorso di script, come fa l'adapter RapidOCR qui sotto, HotPDF avvia il figlio sospeso, lo assegna a un job object con JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE e poi lo riprende, così chiudere il job termina l'intero albero. La stessa idea di contenimento guida isolare i codec di immagini PDF in processi worker, dove il figlio è codice non fidato; qui il figlio è fidato, ma il vostro processo non è l'unico codice che tiene handle dentro di lui
Cancellazione, timeout e la scrittura tutto-o-nulla
IHPDFOCREngine.Recognize restituisce un Boolean solo, e False copre sia "Tesseract è fallito" sia "l'utente ha premuto Cancel". L'adapter polla il token e il proprio timeout ogni 25 millisecondi mentre Tesseract gira, e alla cancellazione pulisce e restituisce False. Preso alla lettera, ciò si leggerebbe come otlsEngineError, quindi ApplyLoadedOCRTextLayer controlla prima il token ogni volta che Recognize restituisce False. Riconoscimento e costruzione del contenuto finiscono per ogni pagina richiesta prima che la transazione del documento si apra, così una cancellazione a pagina 40 di 50 riporta otlsCancelled e lascia tutte le 50 pagine come caricate. Gli altri limiti seguono lo stesso stile:
- Il timeout parte dall'inizio di ogni chiamata
Recognize, quindi il default di 60.000 ms è un limite per pagina - Un figlio ancora in esecuzione al timeout o alla cancellazione viene terminato e atteso fino a 5 secondi; la directory privata viene rimossa in un blocco
finally, con la cancellazione ritentata fino a un secondo perché i file di output possono restare bloccati per breve tempo dopo la fine del processo output.tsvha un tetto a 64 MiB estderr.txta 1 MiB, controllati mentre il figlio gira e dopo la sua uscita- Parole e code unit UTF-16 per pagina hanno un tetto dato da ciò che resta di
MaxWordsPerPage,MaxTotalWordseMaxTextCodeUnits; superare i limiti fa fallire l'esecuzione invece di troncare la lista - Un exit code non nullo torna con fino a 4.096 caratteri di
stderr.txt, il modo più rapido di scoprire che manca un file.traineddata
Come appare dentro la pagina il layer di testo invisibile
HotPDF scrive le parole con la modalità di rendering del testo 3 (né fill né stroke, ISO 32000-1 §9.3.6), così la scansione resta visibile mentre ricerca e copia lavorano sulle parole. Il content stream apre BT con 3 Tr; ogni parola riceve una matrice Tm alla propria baseline, una dimensione del font pari all'altezza della box in pixel per 72 fratto il DPI di rendering, e una scala Tz che stira il run fino alla larghezza della box. Quello stiramento tiene l'evidenziazione di ricerca sulla parola nell'immagine
Il TSV ha box ma nessuna baseline, quindi ogni baseline viene collocata a un quinto dell'altezza della box sopra il bordo inferiore. Tra parole vicine su una riga da sinistra a destra in scritture con spazi come latino o cirillico, uno spazio stirato riempie il varco, così il testo copiato conserva i propri spezzaparole; il cinese non li riceve. I glifi passano per un font Type0 condiviso e non incorporato con codifica Identity-H e una CMap ToUnicode generata, un CID per ogni scalare Unicode distinto, che è come cinese, latino accentato e caratteri del piano supplementare sopravvivono a copia e ricerca. Un run tiene fino a 65.535 scalari distinti, e dato che ISO 19005 richiede font incorporati, l'output PDF/A richiede un font conforme incorporato separatamente. Per controllare un risultato, salvate, ricaricate ed eseguite il percorso ordinario da estrarre testo da un PDF caricato in Delphi; se le parole attese tornano sulle pagine attese, il layer è vero
RapidOCR e la DLL nativa sullo stesso contratto
Per le scansioni in cinese semplificato, HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) riusa lo stesso runner di processo e parser TSV. Il percorso dello script bridge segue l'eseguibile Python e la lingua è fissata a chi_sim. HotPDF spedisce il bridge come tools/OCR/rapidocr_tsv.py; richiede i pacchetti rapidocr e onnxruntime, modelli ONNX locali e un file di font, rifiuta i download automatici, e scrive TSV a forma Tesseract; un overload THPDFRapidOCROptions imposta file di modello, conteggi di thread e un tetto di pixel. La factory generica dietro entrambi gli adapter, HPDFCreateLocalTSVOCREngine in HPDFLocalTSVRecognition, accetta qualsiasi programma che prende gli argomenti in stile Tesseract e scrive il TSV a dodici colonne, ed eredita la lista di handle, il timeout, la cancellazione e i budget
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) carica invece la C API di Tesseract in-process, si dichiara Tesseract (native DLL), controlla in anticipo che ogni .traineddata richiesto esista, e mappa cancellazione e timeout sul monitor di avanzamento di Tesseract stesso. Risparmia un avvio di processo e un giro di andata e ritorno BMP per pagina; l'eseguibile tiene fuori dal vostro spazio di indirizzi i crash e la crescita di memoria del recognizer. Per uno strumento desktop che lavora sulle scansioni dell'utente la DLL va bene. Per un servizio che ingurgita documenti da sconosciuti, il motore da riga di comando è la scelta più sicura. In entrambi i casi il riconoscimento gira su Windows, una pagina alla volta, sulla bitmap renderizzata, quindi raddrizzate e pulite le scansioni ostiche prima che raggiungano il motore
Gli adapter OCR, il writer del text layer, il renderer che li alimenta e l'estrazione che controlla l'output vivono tutti in un unico componente VCL nativo per Delphi e C++Builder. Se la vostra applicazione di acquisizione o archiviazione richiede output PDF ricercabile, l'HotPDF Delphi PDF component copre tutto tranne il motore OCR che installate voi