In un font TrueType che conserva l'ordine standard dei glifi Macintosh, la parola "Total" può trovarsi in un flusso di contenuti PDF come <0037005200570044004F> Tj. Quei cinque valori a due byte sono numeri di glifo all'interno del font incorporato, e nulla nella stringa dice che disegnano T, o, t, a e l. Letti quei byte come UTF-16 si ottiene la stringa 7RWDO, mentre la pagina mostra Total sullo schermo, perché disegnare un glifo richiede solo la mappatura codice-glifo, mentre recuperare il testo richiede una mappatura codice-Unicode che il file può anche non avere mai contenuto
Perché il testo estratto esce come caratteri privi di senso?
Un flusso di contenuti registra codici di carattere, e il loro significato vive interamente nel font. Gli operatori Tj e TJ (ISO 32000-1 §9.4.3) trasportano stringhe di byte che vengono interpretate attraverso il font selezionato dal Tf precedente: il byte 0x41 è la lettera A in WinAnsi, un glifo arbitrario in un font subset, o metà di un CID a due byte in un font CJK composito. L'ISO 32000-1 §9.10 tratta l'estrazione del testo esattamente come questo problema di decodifica, rimappando ogni codice a Unicode a partire da ciò che il dizionario del font fornisce, e dichiara chiaramente che a un file conforme non è richiesto di fornire informazioni sufficienti per farlo
Dietro ogni segnalazione del tipo "copia-incolla da questo PDF produce spazzatura" c'è proprio quella clausola. Un producer che incorpora un font subset senza tabella /ToUnicode ha scritto un file valido che si renderizza correttamente. I glifi ci sono tutti. Manca la mappa inversa, che un estrattore deve ricostruire da indizi secondari: la codifica dichiarata dal font, i nomi dei glifi, le raccolte di caratteri pubblicate da Adobe, la tabella cmap dentro il programma del font incorporato. Quanti di questi indizi un'API prova, e cosa ti conseigna quando tutti falliscono, è ciò che in pratica distingue le librerie di estrazione
Testo in ordine di lettura con ExtractLoadedPageText
HotPDF Delphi Component restituisce il testo in ordine di lettura di una pagina caricata attraverso function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Gli indici di pagina partono da zero, il risultato è una UnicodeString nativa di Delphi, e la funzione restituisce False quando la pagina non ha un flusso di contenuti leggibile, invece di sollevare un'eccezione. Funziona con qualsiasi PDF caricate: la fattura che un cliente ha spedito per e-mail, il rapporto consegnato da uno studio di scansione, il contratto prodotto da un software che nessuno sa più nominare
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // restituisce il numero di pagine
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Per l'intero documento in un'unica stringa, ExtractLoadedPagesText(PageRange, PageSeparator) accetta un intervallo a base uno come '1,3-5,7-' (una stringa vuota significa tutte le pagine) e inserisce PageSeparator, un form feed #12 per impostazione predefinita, tra le pagine. I documenti grandi fanno meglio a passare da ExtractLoadedPagesTextToStream, che scrive UTF-8 pagina per pagina su un TStream e restituisce quante pagine ha elaborato
Il testo contiene ciò che la pagina mostra. I glifi il cui centro di box cade fuori dall'area visibile (il crop box dentro il media box) vengono lasciati fuori, così le marche di stampa di una pagina rifilata non finiscono nel vostro indice. Il testo dentro i Form XObjects dipinti dalla pagina è incluso, ritagliato al /BBox di ciascun form. Un carattere dipinto due volte nello stesso punto, il vecchio trucco per fingere il grassetto, viene letto una volta sola; fake bold e glifi duplicati nell'estrazione del testo ricostruisce come viene individuato quel caso
Le interruzioni di riga seguono una regola geometrica semplice. Una nuova riga inizia quando l'origine del glifo si sposta nella direzione di scrittura di più della metà dell'altezza del testo, prendendo la maggiore tra l'altezza ascent-to-descent di questo glifo e quella del glifo precedente, in unità di pagina. Misurare il box del glifo invece dell'operando dimensione di Tf è la parte che conta: parecchi producer dimensionano il testo attraverso la matrice del testo e passano 1 a Tf, e una soglia costruita su quell'operando si romperebbe a ogni apice rialzato mettendo ogni carattere del testo ruotato su una riga propria. Gli spazi tra le parole funzionano allo stesso modo. Dove un producer separa le parole spostando la posizione del testo con una regolazione TJ o un Td invece di mostrare uno spazio, lo spazio viene aggiunto una volta che il gap dopo la larghezza propria del glifo precedente supera 0,15 dell'altezza del glifo, e mai tra due caratteri cinesi, giapponesi o coreani. I codici che il decodificatore non riesce a risolvere diventano spazi, così i confini delle parole sopravvivono anche quando i singoli glifi no. Il testo orizzontale esce nell'ordine del flusso di contenuti; le sequenze CJK verticali vengono raggruppate di nuovo in colonne lette da destra a sinistra, dall'alto in basso. Spazi tra le parole e interruzioni di riga nel testo di pagina copre quelle soglie
Griglia, colonne o ordine di struttura
Quando la posizione ha un significato (tabelle, moduli, listati di codice, qualsiasi cosa dobbiate mettere in diff, greppare o analizzare per colonna), ExtractLoadedPageTextLayout è la chiamata migliore. Raggruppa i glifi in linee di base, ordina ogni linea di base per X, e riproduce gli spazi orizzontali e verticali su una griglia di caratteri monospazio dimensionata a partire dall'avanzamento mediano dei glifi della pagina e dalla dimensione del font. I gap larghi su una linea di base diventano sequenze di spazi, i gap grandi tra le linee di base diventano righe vuote
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Colonne, rientri e allineamento delle tabelle sopravvivono come
  // spazi e righe vuote su una griglia di caratteri
end;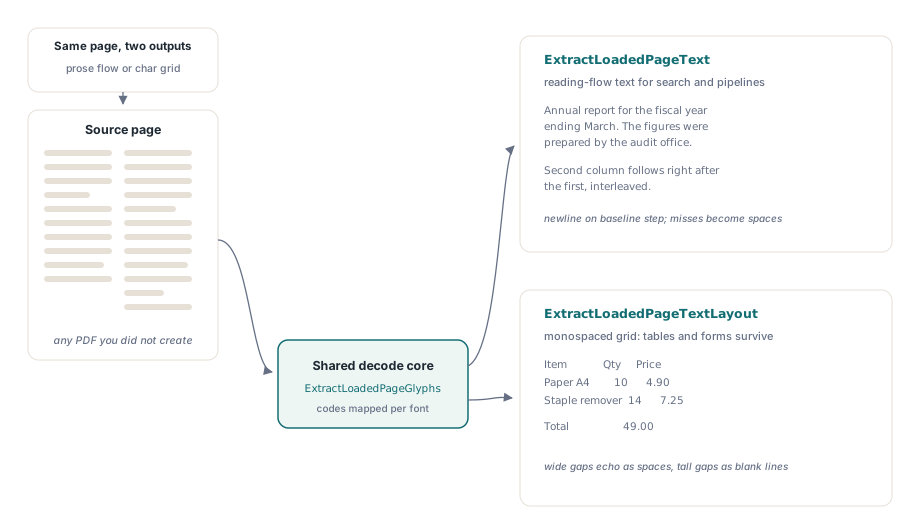
Entrambe le chiamate decodificano con lo stesso meccanismo, quindi scegliere una non costa nulla in fedeltà. Quello che la griglia non fa è riorganizzare la prosa: un articolo a due colonne esce con le due colonne affiancate, fedelmente, che va bene per un diff ed è sbagliato per un sistema di riassunto. Due altre chiamate coprono quel vuoto. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) spezza ogni riga ovunque il gap tra glifi vicini superi il moltiplicatore per l'avanzamento mediano (3.0 per impostazione predefinita) e separa i pezzi con un tab. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) percorre l'albero di struttura di un PDF taggato (ISO 32000-1 §14.8.4) e restituisce le sequenze di marked-content in ordine di composizione; restituisce False quando la pagina non ha un albero di struttura utilizzabile, e UntaggedGlyphCount dice quanti glifi non è riuscito a collocare
Per il testo che dovranno leggere una persona o un modello linguistico, provate prima l'ordine di struttura e ripiegate su ExtractLoadedPageText. L'albero di struttura è l'unico ordinamento che l'autore ha dichiarato di proposito, e ogni metodo geometrico è un'ipotesi al confronto. Tenete la griglia per i lavori in cui le colonne sono dati. L'estrazione del testo in ordine di struttura ha i dettagli di come il marked-content viene abbinato all'albero
Come HotPDF decodifica i codici di carattere in Unicode
HotPDF Delphi Component risolve ogni codice di carattere attraverso una catena di fallback ordinata per priorità, e una strategia che non sa rispondere passa il codice alla successiva. La CMap /ToUnicode del font (ISO 32000-1 §9.10.3) viene per prima, perché è l'unica mappatura che il producer ha scritto apposta per l'estrazione. Di seguito i nomi dei glifi di un array /Differences dell'/Encoding, letti attraverso la Adobe Glyph List; poi la CMap /Encoding stessa, incorporata come stream o nominata, dove un nome Uni…-UTF16 significa che il codice è già UTF-16. I font compositi proseguono attraverso le raccolte di caratteri Adobe (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) da CID a Unicode, poi attraverso /CIDToGIDMap fino alla tabella cmap del programma del font incorporato, letta al contrario da glifo a Unicode. I font semplici ricadono sulle tabelle WinAnsi, MacRoman, Standard e MacExpert e infine su quella stessa cmap incorporata. Un codice che esaurisce la catena si risolve in 0
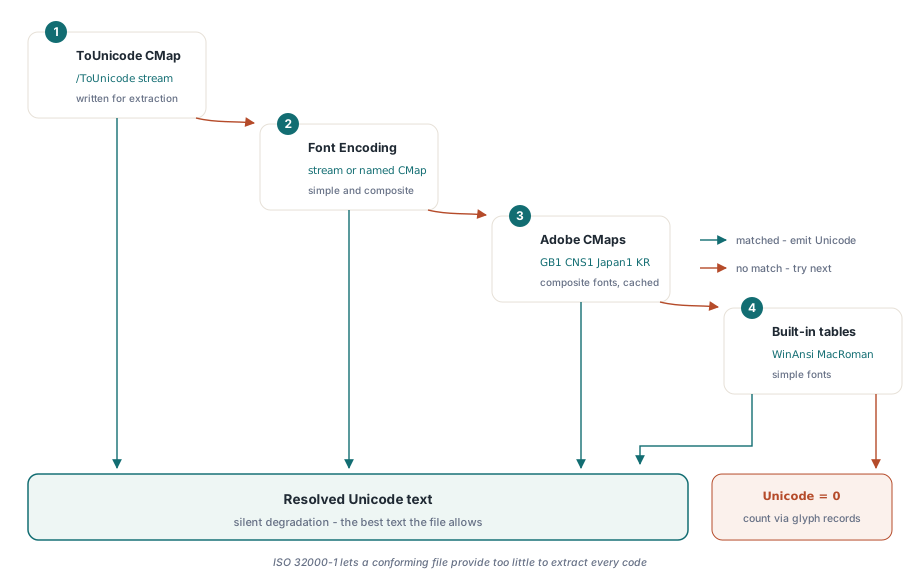
Il passaggio della cmap incorporata è ciò che salva molti font subset che arrivano senza /ToUnicode: il programma del font di solito contiene ancora la sua cmap Unicode, e leggerla al contrario recupera la maggior parte del testo. È una ricostruzione, però. Due caratteri Unicode che condividono lo stesso glifo tornano entrambi come quello che la cmap elenca, quindi trattate il testo recuperato come buono per ricerca e indicizzazione e verificatelo prima di usarlo come registro legale
I dati delle raccolte Adobe vivono su disco. HotPDF distribuisce i file CMap e cid2code.txt sotto la sua cartella resources\CMap, analizza ogni file al massimo una volta per processo e mette in cache il risultato; da solo la mappa Adobe-GB1 sono circa 2 MB di testo che non volete analizzare a ogni pagina. Le CMap predefinite esistono anche come tabelle integrate, quindi un font codificato con una CMap nominata come UniGB-UTF16-H continua a decodificare senza la cartella. Le tabelle CID-to-Unicode per i font CJK Identity-H la richiedono. La proprietà CMapResourcePath nomina la cartella che contiene le sottocartelle delle raccolte; lasciata vuota, HotPDF cerca resources\CMap accanto all'eseguibile e uno o due livelli più in alto
Pdf := THotPDF.Create(nil);
try
  // Cartella che contiene Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Impostate il percorso esplicitamente in qualsiasi servizio, modulo ISAPI o DLL di plugin. In quegli host ParamStr(0) nomina il processo host, che raramente è la cartella dove avete distribuito, e una cartella mancante non solleva eccezioni; le pagine CJK semplicemente tornano con buchi dove le tabelle delle raccolte avrebbero riempito. Lo shaping del testo per script complessi con HotPDF incontra la stessa divisione codice-contro-glifo in fase di scrittura
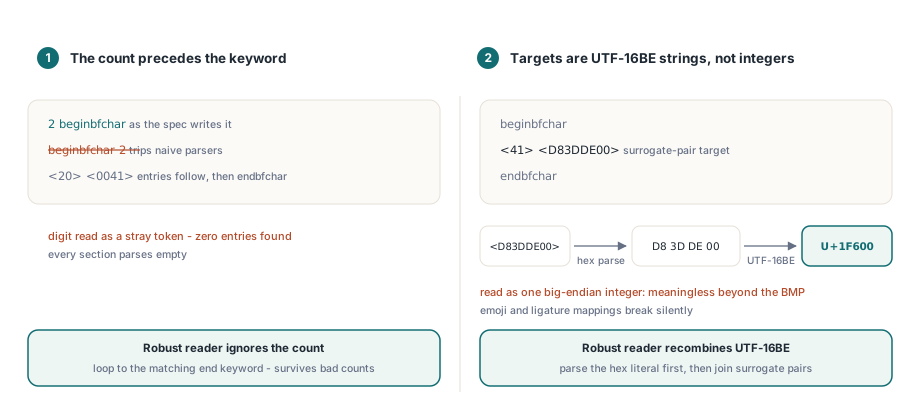
Due trappole di sintassi delle CMap
I file CMap sembrano banali da analizzare, e due dettagli fanno inciampare quasi tutti i primi tentativi. Il conteggio dei record arriva prima della parola chiave di sezione: una sezione legge 2 beginbfchar, mai beginbfchar 2. Un parser che si aspetta il conteggio dopo la parola chiave ingoia il numero come token estraneo e poi trova zero voci in ogni sezione. Il lettore di HotPDF ignora del tutto il conteggio e cicla fino al endbfchar o endbfrange corrispondente, il che regge anche con i file reali i cui conteggi dichiarati sono sbagliati
La seconda trappola è che i target di bfchar e bfrange sono stringhe UTF-16BE. La destinazione <D83DDE00> significa U+1F600, una coppia di surrogati che va ricombinata in un solo code point, e leggere quei quattro byte come un intero big-endian produce un valore privo di senso per ogni carattere fuori dal Basic Multilingual Plane, emoji comprese. HotPDF analizza prima il letterale esadecimale in byte grezzi e poi ricombina le unità di codice UTF-16BE, il che gestisce anche i target a più caratteri che producono le mappature delle legature, come un glifo fi che mappa su due lettere
Contare i glifi non risolti con ExtractLoadedPageGlyphs
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) espone i record di glifo sotto le chiamate testuali come un THPDFGlyphArray. Ogni THPDFGlyphRecord trasporta il Code grezzo, il suo CodeByteWidth (1, 2 o 4, deciso dal codespacerange della CMap), il code point Unicode risolto più un UnicodeSequence per le legature, il FontKey e il FontSize attivi, l'origine X e Y in spazio utente, l'Advance, un quadrilatero del glifo a quattro angoli, e GlyphEndX / GlyphEndY, il fondo della larghezza propria del glifo da cui la regola dello spazio tra parole prende le misure. Basta per un'evidenziazione posizionata o per un algoritmo di layout tutto vostro
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Contare i record con Unicode = 0 è il modo onesto di giudicare un documento prima di fidare il suo testo a valle. Aspettatevi che il conteggio differisca leggermente da ciò che vedono le chiamate testuali. Questa chiamata restituisce ogni glifo del flusso di contenuti della pagina stessa, compresi quelli fuori dal crop box e i duplicati dipinti per il fake bold, e non scende nei Form XObjects. Ogni record conserva anche TokenIndex, ItemIndex e ByteOffset, che ricollegano il carattere al suo operando sorgente; la ricerca e sostituzione in un PDF esistente è costruita su quei tre campi
Alcuni file non hanno testo da dare. Una pagina scansionata è una grande immagine senza operatori di testo, quindi l'estrazione restituisce correttamente una stringa vuota, e la strada da seguire è l'OCR, a partire da l'estrazione delle immagini di pagina dal PDF caricato. I documenti cifrati si estraggono normalmente una volta aperti con LoadFromFile(FileName, Password), perché gli stream vengono decifrati prima che l'interprete li legga. Gli stream dei font e dei contenuti vengono decodificati attraverso la stessa catena di filtri del resto del documento caricato, e uno stream /ToUnicode che non si lascia decodificare passa alla strategia successiva mentre il resto della pagina si estrae lo stesso. Lo stesso lettore di oggetti sostiene la modifica dei metadati nei documenti caricati, quindi un unico passaggio di acquisizione può leggere il testo e sistemare i metadati
L'estrazione in ordine di lettura, a griglia, a colonne e in ordine di struttura, più l'accesso a livello di glifo, viaggia tutti nel HotPDF Delphi Component per Delphi e C++Builder come Object Pascal puro senza DLL esterne né servizi di testo del sistema operativo, così quando un file strano atterra nella vostra coda potete entrare passo passo nel decodificatore e vedere quale strategia ha risposto per ogni codice