Passa la frase araba يوضح ملف PDF a TextOut e apri il risultato. Le lettere scorrono nel verso sbagliato, e ciascuna si trova nella sua forma isolata con uno spazio visibile prima della successiva, come se qualcuno avesse digitato l'inglese al contrario e premuto spazio tra ogni carattere. Nessuna eccezione sollevata. Nessun avviso stampato. L'output è semplicemente sbagliato, ed è sbagliato perché due trasformazioni separate da cui dipende l'arabo non sono mai avvenute. Sapere quali sono queste due trasformazioni e quale chiamata le esegue è, in sostanza, in cosa consiste la stampa PDF di script complessi
HotPDF è un componente nativo PDF VCL per Delphi e C++Builder, e svolge il lavoro da destra a sinistra per te tramite una chiamata distinta. Si ferma anche poco prima in alcuni punti specifici che vuoi conoscere prima di impegnarti in una localizzazione, quindi questo pezzo mappa i concetti e i limiti onesti; la configurazione pratica per la chiamata stessa si trova nell'articolo di riferimento su RtLTextOut
Perché una stringa corretta viene comunque stampata in modo errato
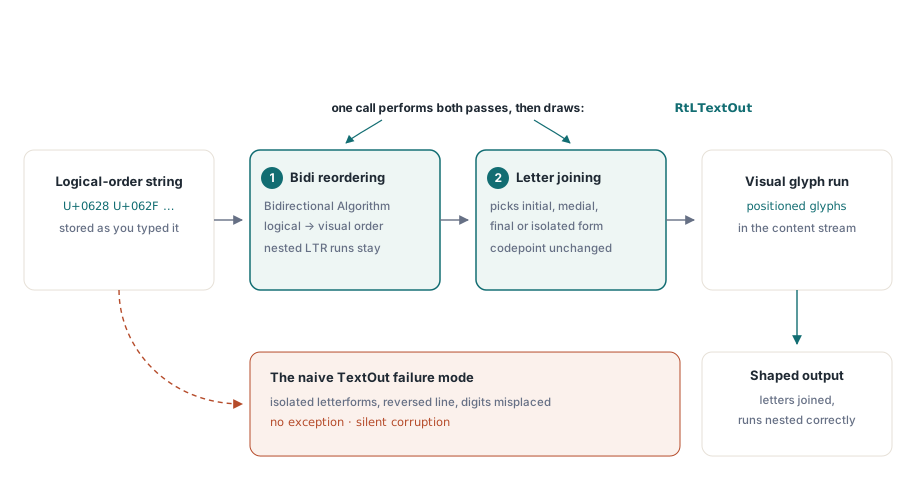
Unicode mantiene il testo in ordine logico, l'ordine in cui lo digiti e lo leggi ad alta voce. Un renderizzatore deve posizionare i glifi in ordine visivo. Per gli script da sinistra a destra questi ordini coincidono e nessuno ci pensa. Per l'arabo e l'ebraico non è così, e quando una singola riga mescola le direzioni, ad esempio una frase araba che contiene il token latino "PDF" o un prezzo scritto in cifre, l'Algoritmo Bidirezionale Unicode (UAX #9) decide esattamente come i frammenti da sinistra a destra si annidano all'interno della riga da destra a sinistra. Questa è la prima trasformazione, il riordinamento, e saltarla è ciò che capovolge la riga
La seconda è la modellazione contestuale. Una lettera araba è disegnata diversamente a seconda di dove si trova in una parola: iniziale, mediale, finale o isolata. Il punto di codice (codepoint) rimane lo stesso in ogni posizione; cambia solo il glifo. Una pipeline che passa ogni punto di codice direttamente al suo glifo predefinito produce esattamente l'output disconnesso e in forma isolata del paragrafo di apertura. L'ebraico salta questo passaggio, poiché le sue lettere non si uniscono, ma ha comunque bisogno del riordinamento. L'arabo ha bisogno di entrambi, ed è per questo che l'arabo, e non l'ebraico, è la stringa con cui testare
Sul desktop niente di tutto questo è un tuo problema. Quando un form VCL disegna l'arabo in un TEdit, lo stack di testo del sistema operativo lo riordina e lo modella silenziosamente, motivo esatto per cui la stringa che appare perfetta sullo schermo esce rotta in un PDF ingenuo. Un flusso di contenuto non memorizza il testo modificabile. Memorizza glifi posizionati, quindi chiunque emetta il flusso eredita il compito di modellazione che il sistema operativo era solito gestire. RtLTextOut è la chiamata che si riprende quel compito
Cosa modella RtLTextOut per te
HotPDF mantiene il percorso latino e il percorso per gli script complessi come due metodi diversi. TextOut stampa ciò che gli dai nell'ordine in cui glielo dai. RtLTextOut esegue prima entrambe le trasformazioni — riordinamento bidirezionale sull'intera riga, analisi contestuale per gli script che si uniscono — e poi stampa. Quali regole dello script si applicano viaggia attraverso il set di caratteri del carattere (charset) piuttosto che attraverso la chiamata stessa, quindi la direzione è una scelta esplicita in ogni punto di chiamata invece di un'ipotesi ricavata dai caratteri. La configurazione parametro per parametro, i valori del set di caratteri, i passaggi di registrazione del font e un esempio compilabile completo si trovano tutti nell'articolo di riferimento su RtLTextOut; questo pezzo rimane concentrato su cosa significano le trasformazioni, dove si fermano e come dimostrare che hanno funzionato
Una regola d'uso è importante anche a questa altitudine: l'input deve essere in ordine logico, perché RtLTextOut esegue l'inversione da sé, e una stringa che hai già capovolto a mano risulta capovolta due volte — l'articolo di riferimento analizza questa trappola e la sua risoluzione. Ciò che fa guadagnare una menzione a questa trappola qui è il motivo per cui sopravvive ai test. Una stringa in arabo puro doppiamente invertita può sembrare perfettamente corretta e cade a pezzi solo quando una riga contiene una parola latina o un numero, perché quelle sequenze incorporate non si annidano più nel modo dettato dallo standard UAX #9. Il bug non è nel rendering; risiede nell'alimentare l'algoritmo con testo che era già stato elaborato a metà
Quello stesso comportamento a direzione mista fa inciampare i revisori più del codice. All'interno di una riga da destra a sinistra, le cifre e le parole latine incorporate si leggono ancora da sinistra a destra. Qualcuno che non ha mai lavorato con un layout bidirezionale guarderà una fattura renderizzata, vedrà il numero di conto letto nel modo "sbagliato" rispetto all'arabo che lo circonda, e lo segnalerà come un bug. Questo è il risultato corretto secondo le specifiche. Una breve nota nei tuoi criteri di accettazione, scritta prima del primo controllo da parte di un madrelingua, fa risparmiare questo passaggio
Quando il riordinamento e l'unione sono sufficienti e quando non lo sono
Per il testo corrente arabo ed ebraico — report, fatture, contratti, lettere — il riordinamento più l'unione contestuale sono l'intero lavoro, e RtLTextOut lo esegue da solo. Il limite appare quando la tipografia richiede più dell'unione. La risposta di HotPDF sul lato arabo è un modellatore lato produttore facoltativo: imposta AutoShapeArabic := True e il componente riscrive la sequenza in ordine logico nei Formati di Presentazione Unicode prima del passaggio bidirezionale, così le forme unificate sono calcolate rispetto ai vicini logici e le legature sono integrate nei punti di codice che il PDF effettivamente trasporta, invece di lasciarne la risoluzione a un visualizzatore. L'interruttore è predefinito su off e l'output è stabile a livello di byte quando rimane su off, quindi l'attivazione è una decisione deliberata per pipeline di documenti, non un aggiornamento globale. Lo stesso modello facoltativo si estende agli altri script da destra a sinistra con unione che HotPDF modella: Siriaco, N'Ko, Adlam e Rohingya Hanifi hanno ciascuno il proprio flag di modellazione automatica che rispecchia quello arabo
Le funzionalità OpenType opzionali sono di nuovo un meccanismo diverso. Le legature discrezionali e funzionalità simili a sostituzione singola passano attraverso GetSingleSubstituteGlyph(GID, 'liga'), che risolve una sostituzione alla volta — prima l'ID del glifo di input, secondo il tag della funzionalità — e restituisce il glifo di input inalterato quando la funzionalità non si applica. Questo è sufficiente per guidare una lista di legature nota e finita che mantieni tu stesso. Non è un motore GSUB completo, e la differenza è esattamente dove i piani ambiziosi di localizzazione vanno storti: una pipeline di modellazione che gestisce l'arabo in modo impeccabile ha dimostrato il riordinamento e l'unione, nient'altro
Copertura attraverso gli script
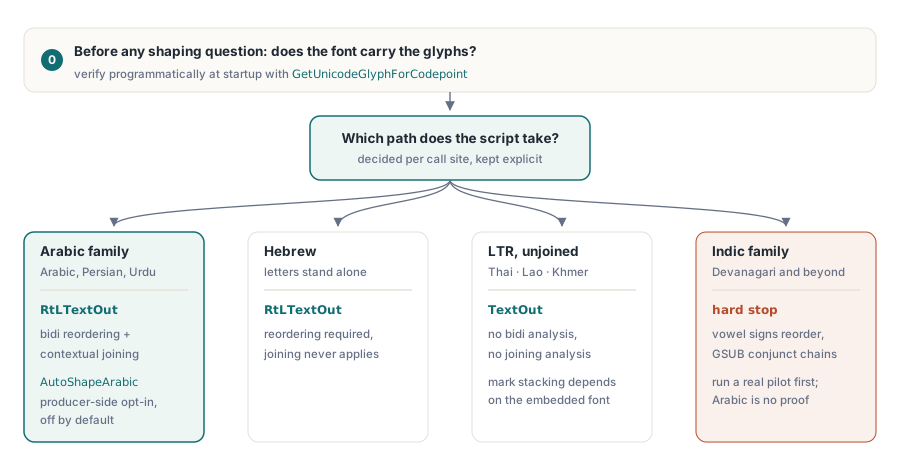
L'arabo esercita entrambe le trasformazioni, motivo per cui è la stringa con cui testare, e perché un test dell'arabo superato è la singola prova più forte che la pipeline funziona. L'ebraico necessita del riordinamento ma non dell'unione, poiché le sue lettere stanno da sole; se l'ebraico viene renderizzato correttamente ma l'arabo esce disconnesso, la metà bidirezionale va bene e la metà contestuale non è mai stata eseguita. Il persiano e l'urdu sfruttano l'alfabeto arabo ed ereditano il suo comportamento, sebbene la preferenza dell'urdu per lo stile Nastaliq sia una decisione legata al font con conseguenze sulla leggibilità che un lettore madrelingua dovrebbe giudicare
Il thailandese si trova completamente dall'altra parte della barricata. Scorre da sinistra a destra, quindi non necessita di lavoro bidirezionale e le sue lettere non si uniscono, quindi non ha bisogno di analisi contestuale; le stringhe thailandesi passano attraverso il normale percorso TextOut come il latino. Ciò che il thailandese ha, tuttavia, sono segni impilati — vocali e segni tonali sopra e sotto la consonante base — e il loro corretto posizionamento dipende dal font che costruisce i suoi segni di combinazione per impilarsi senza l'aiuto del motore di modellazione. La maggior parte dei font dedicati al thailandese lo fa. Prova con il font esatto che intendi incorporare, non un sosia
Il devanagari e il resto della famiglia indiana sono il limite insormontabile. I loro segni vocalici si riordinano attorno a gruppi di consonanti e le loro combinazioni si formano attraverso catene di sostituzioni dipendenti dal contesto, che rientrano appieno nel territorio GSUB, oltre al riordinamento e all'unione. Se una localizzazione in lingua indiana è nei piani, esegui un vero pilota su autentiche stringhe dei clienti prima di prometterlo — il fatto che l'arabo funzioni non è garanzia che il devanagari lo farà. Le stringhe CJK, il vietnamita con i suoi segni diacritici impilati e il testo europeo misto percorrono tutti la via ordinaria senza analisi bidirezionale, e conviene mantenere fisicamente separati i due percorsi nel codice dei report, una routine per le stringhe RTL e una per tutto il resto, così la logica di localizzazione è visibile nel punto di chiamata anziché nascosta dietro un flag che qualcuno si dimentica di impostare
La copertura dei glifi si decide prima ancora dell'esecuzione della modellazione
La modellazione preleva glifi da un font. Se il font non li possiede, non c'è niente da prelevare, ecco perché il classico fallimento del deploy — impeccabile sulla macchina dello sviluppatore, quadratini vuoti sul server del cliente dopo una sostituzione silenziosa del font — è un problema di copertura, non un problema di modellazione. La soluzione pratica, registrare un font che spedisci invece di affidarti a qualunque cosa abbia installato una macchina, è illustrata passo dopo passo nell'articolo di riferimento. Il punto concettuale è che la copertura deve essere stabilita prima ancora che qualsiasi domanda sulla modellazione abbia senso, e che può essere stabilita in modo programmatico invece di analizzare a occhio l'output
// Dopo RegisterUnicodeTTF, verifica la copertura per i
// codepoint effettivamente usati dai tuoi dati
GID := Pdf.GetUnicodeGlyphForCodepoint($0628);  // U+0628 ARABIC LETTER BEH
LogGlyphAudit($0628, GID);
La registrazione stessa comporta due vincoli — un limite minimo a PDF 1.5 per la gestione di Unicode incorporato e i bit di autorizzazione per l'incorporamento del font — entrambi trattati insieme ai passaggi di configurazione nell'articolo di riferimento su RtLTextOut. Ciò che appartiene a questa sezione è l'abitudine alla verifica: GetUnicodeGlyphForCodepoint è il tuo sistema di allerta precoce. Analizza gli intervalli di punti di codice che i tuoi dati usano effettivamente quando il servizio viene avviato e registra quali ID di glifi vengono restituiti. Una lacuna nella copertura si manifesta quindi come una riga in un registro di avvio durante il rilascio, piuttosto che come caratteri mancanti in una fattura che ha già raggiunto un cliente
L'ordine di lettura appartiene al documento, non ai glifi
Riuscire ad azzeccare ogni glifo lascia ancora qualcosa di incompiuto. ISO 32000-1 §12.2 definisce una preferenza di visualizzazione chiamata /Direction che stabilisce l'ordine di lettura complessivo del documento. Non tocca alcun glifo. Quello che fa è dire al visualizzatore come organizzare le doppie pagine affiancate, da che lato dovrebbe iniziare un layout a pagine affiancate e da che parte dovrebbe inclinarsi l'interfaccia utente per la lettura. Nulla di tutto questo si nota su una singola pagina, motivo esatto per cui viene dimenticato
// Dichiara l'ordine di lettura da destra a sinistra a livello di documento
Pdf.Direction := RightToLeft;  // aggiunge vpDirection a ViewerPreferences
Impostare Direction è tutto il lavoro: il setter della proprietà aggiunge vpDirection alle ViewerPreferences del documento, quindi una sola riga porta la preferenza nel file. Se il testo passa per RtLTextOut lo ottieni gratuitamente, perché la chiamata inverte la direzione del documento come effetto collaterale — l'articolo di riferimento spiega quando un documento misto richiede che questo venga annullato. Il caso in cui devi impostarlo tu stesso è un documento da destra a sinistra prodotto in qualsiasi altro modo, ad esempio da un input modellato in precedenza a monte e disegnato attraverso il normale percorso. Omettilo lì e la bozza di una singola pagina che stai osservando sembrerà identica in entrambi i modi; poi qualcuno stampa un libretto fronte-retro, le doppie pagine escono a specchio e la causa è una singola riga di codice dimenticata settimane prima
Verifica dell'output modellato
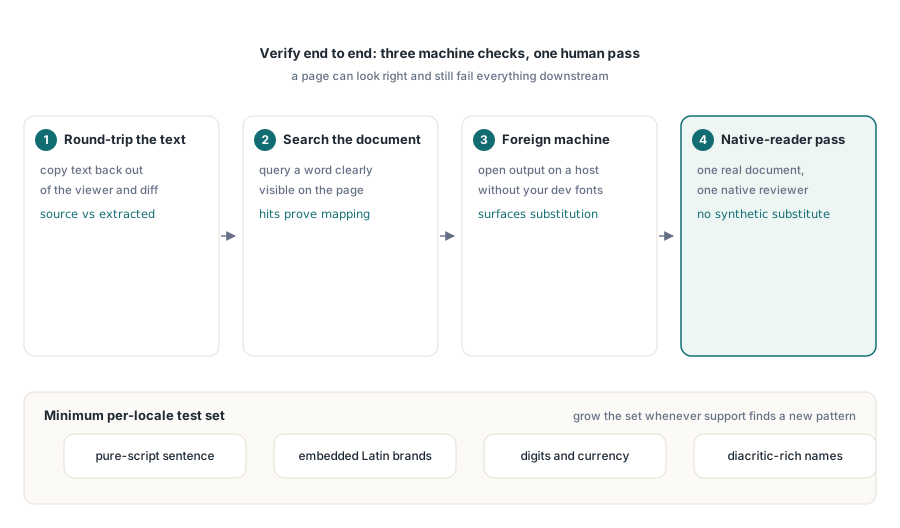
Verifica da cima a fondo, perché una pagina può sembrare corretta ed essere comunque inutile per tutto ciò che si trova a valle. Tre controlli rilevano la maggior parte dei problemi. Copia il testo fuori da Acrobat e confronta i punti di codice (codepoint) con la tua stringa sorgente. Esegui la ricerca nel documento del visualizzatore per una parola che puoi vedere sulla pagina. E apri l'output su una macchina che non ha i tuoi font di sviluppo, quella che con maggiore probabilità espone una sostituzione. Niente di tutto questo sostituisce un madrelingua che osserva un vero documento, il quale nota cose che nessun corpus sintetico noterà. Metti in calendario quella revisione prima della pubblicazione del formato
Scegli stringhe di test di proposito invece di riciclare qualunque cosa un traduttore abbia inviato l'anno scorso. Un minimo funzionale per localizzazione: una frase di puro script, una frase con nomi di brand latini incorporati, una riga contenente cifre e valuta e nomi con segni diacritici o di combinazione. I nomi reali dei clienti invalidano presupposti che il testo riempitivo lascia intatti, quindi lascia che l'insieme di regressione cresca di una stringa ogni volta che un caso di supporto fa emergere un modello che non avevi mai visto
La registrazione del font, la suddivisione (subsetting) e le normali API per disegnare il testo sono trattate nell'articolo sull'output dei report, i font e le immagini con HotPDF. Quando gli stessi documenti devono soddisfare anche i profili di accessibilità, l'etichettatura linguistica e le regole di struttura nell'articolo sulla convalida PDF/A e PDF/UA si appoggiano al lavoro di modellazione descritto qui
Le API per i font da destra a sinistra e Unicode descritte in precedenza sono incluse con il Componente HotPDF per Delphi e C++Builder; la pagina del prodotto offre un collegamento al riferimento completo per l'output di testo