TerminateThread sembra il modo ovvio per fermare una chiamata OCR che macina su una pagina scansionata da più tempo di quanto la tua UI sia disposta ad aspettare. La documentazione Windows spiega perché non lo è: se il thread bersaglio tiene il lock dell'heap del processo, quel lock non viene mai rilasciato, e la prossima allocazione su qualsiasi altro thread può bloccarsi per sempre. Una volta che l'OCR gira dentro il tuo processo, l'unica fermata sicura è cooperativa, ai checkpoint tra gli stadi di inferenza, e questo è il prezzo di caricare i modelli ONNX una volta e tenerli caldi
L'alternativa che la maggior parte dei team Delphi prova per prima è un processo figlio. Un worker Python per pagina può essere ucciso in qualsiasi momento, il che è allettante, ma ogni chiamata avvia un interprete, importa il proprio runtime, e carica i modelli di rilevamento e riconoscimento prima di leggere un pixel. Immagina un job di archivio da 500 pagine: quel lavoro di avvio gira 500 volte, e il deployment ora include un ambiente Python accanto a un eseguibile nativo
PDF ricercabile dalle scansioni con HPDFCreateRapidOCRDLLOCREngine
HotPDF esegue RapidOCR in-process attraverso HPDFCreateRapidOCRDLLOCREngine, dichiarata nell'unità HPDFRapidOCRRecognition. La factory carica HotPDFRapidOCR.dll, inizializza una volta sola i modelli ONNX di rilevamento, classificazione d'angolo opzionale e riconoscimento, e restituisce un IHPDFOCREngine. Quel motore si innesta in THotPDF.ApplyLoadedOCRTextLayer esattamente come gli altri motori OCR: il documento renderizza ogni pagina, la DLL esegue l'inferenza su CPU, e il risultato viene scritto come livello di testo Unicode invisibile. Niente Python, niente processo figlio. L'adapter esiste per build Delphi, C++Builder e FPC/Lazarus su Windows
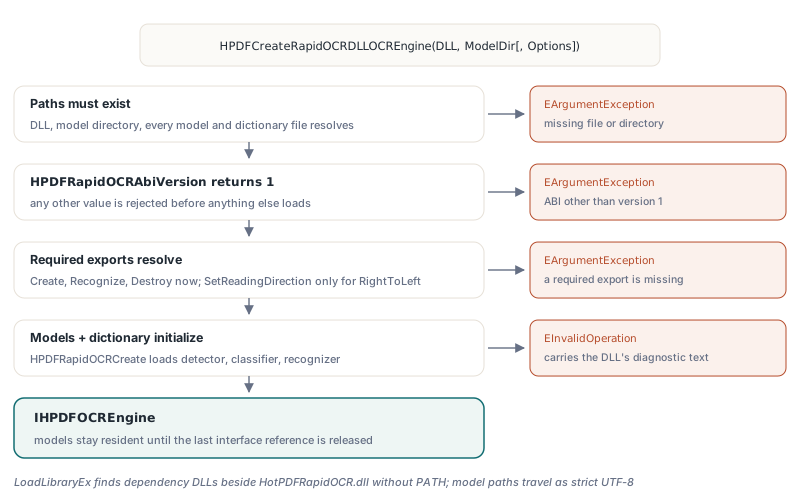
La validazione avviene nella factory, prima che qualsiasi pagina venga toccata. Ogni file di modello e dizionario deve risolversi, HPDFRapidOCRAbiVersion deve restituire 1, e gli export richiesti devono esistere prima che HPDFRapidOCRCreate costruisca i modelli. Gli errori di configurazione sollevano EArgumentException; un modello che si rifiuta di caricare solleva EInvalidOperation con la diagnostica della DLL stessa, per esempio un dizionario che non corrisponde al modello di riconoscimento
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // I modelli si caricano qui, fuori da qualsiasi scadenza di riconoscimento.
  // I nomi relativi in THPDFRapidOCRDLLOptions.Default si risolvono
  // contro la directory dei modelli
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // lista pagine vuota = tutte le pagine; SkipPagesWithText è True per default
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default nomina ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx, e ppocr_keys_v1.txt, con un thread CPU, un limite di ingresso di 16.777.216 pixel, e una scadenza di 60.000 ms per chiamata di riconoscimento. Per le altre scritture, THPDFRapidOCRDLLOptions.ForLanguage conserva quei default e scambia in <profile>/recognition.onnx più <profile>/dictionary.txt per uno dei nove profili, dal cinese tradizionale e cirillico all'arabo e al devanagari. Ogni motore legge una lingua; scegli il profilo per pagina o per documento. Perché modello e dizionario viaggiano sempre in coppia è trattato in modelli multilingua RapidOCR e dizionari CTC in HotPDF
Il motore si dichiara come RapidOCR (native DLL) in Info.EngineName. Scrivi quella stringa nei log. Quando lo stesso servizio esegue anche l'adapter del processo OCR Tesseract esterno o il motore OCR integrato a corrispondenza di template, è il modo più rapido per dire quale recognizer ha prodotto una pagina sbagliata
Perché il C ABI parla solo int32_t e byte UTF-8?
Il confine di HotPDFRapidOCR.dll usa interi a larghezza fissa, puntatori grezzi e lunghezze di byte esplicite perché Delphi, C++Builder e Free Pascal non condividono nulla con MSVC oltre la convenzione di chiamata C. Una std::string, una std::vector o un'eccezione C++ porta con sé un layout di memoria e un modello di unwinding che appartengono a un compilatore e a una libreria di runtime, e far attraversare il codice Pascal a uno qualsiasi di questi finisce in uno stack corrotto o in un blocco heap liberato dall'allocatore sbagliato
La versione ABI 1 è una breve lista di regole. Ogni export è cdecl e restituisce uno stato int32_t: 1 successo, 0 fallimento. Ogni funzione che può fallire prende un buffer diagnostico di proprietà del chiamante e la sua dimensione in byte, e la DLL scrive un messaggio UTF-8 terminato da NUL troncato per stare nello spazio. Dentro la DLL, il corpo di ogni export siede in un try con sia catch (const std::exception &) sia catch (...). Un errore di ONNX Runtime, un'asserzione OpenCV o un dizionario malformato diventa stato 0 più testo
| Export | Ruolo | Quando l'adapter lo risolve |
|---|---|---|
HPDFRapidOCRAbiVersion | Restituisce 1; qualsiasi altro valore viene rifiutato | Subito dopo il caricamento della DLL |
HPDFRapidOCRCreate | Carica rilevamento, classificazione opzionale, modelli di riconoscimento e il dizionario | Nella factory |
HPDFRapidOCRRecognize | Esegue una bitmap ed emette un callback per riga di testo | Nella factory |
HPDFRapidOCRDestroy | Libera l'istanza del modello | Nella factory |
HPDFRapidOCRSetReadingDirection | Ordine delle righe da destra a sinistra opzionale | Solo quando RightToLeft è impostato |
L'export della direzione di lettura viene risolto pigramente di proposito, così una DLL costruita senza di esso serve comunque ogni richiesta da sinistra a destra. L'adapter carica la libreria con LoadLibraryEx e flag di ricerca che coprono la cartella della DLL stessa più le directory sicure di default; le dipendenze ONNX Runtime o OpenCV appoggiate accanto a HotPDFRapidOCR.dll vengono trovate senza toccare PATH. I percorsi di modello e dizionario attraversano il confine come UTF-8, e la DLL li converte con MultiByteToWideChar in modalità strict prima di aprire i file attraverso le API wide-character. Una directory di modelli sotto C:\Users\Łukasz o un nome utente cirillico si apre normalmente
Una regola vive nei file di build anziché nell'header. La DLL collega ONNX Runtime e OpenCV staticamente, e il progetto CMake usa di default la CRT release statica (/MT). Mescola librerie statiche compilate contro /MD e ottieni errori di link se vai fortunato e due heap indipendenti se non vai. Fornisci librerie costruite per la stessa modalità CRT della DLL
Che cosa succede tra una TBitmap e una riga di testo?
HotPDF passa alla DLL una copia BGR top-down indipendente della pagina renderizzata, e la DLL restituisce un callback per ogni riga riconosciuta. Il testo in quel callback è in prestito: il puntatore è valido solo finché il callback non restituisce, quindi l'adapter lo copia sul posto
Su Delphi lo snapshot arriva da una TBitmap privata forzata a pf24bit e letta con GetDIBits usando una biHeight negativa. Questo dà righe top-down con padding all'allineamento a quattro byte, e lo stride viaggia verso la DLL come argomento esplicito. Su FPC l'adapter legge attraverso CreateIntfImage. La bitmap del chiamante non viene mai modificata. I controlli di dimensione girano prima che la copia venga allocata: al massimo 32.767 pixel per lato, e non più di MaxPixels in totale, che per default è 16.777.216 e può essere alzato a 67.108.864
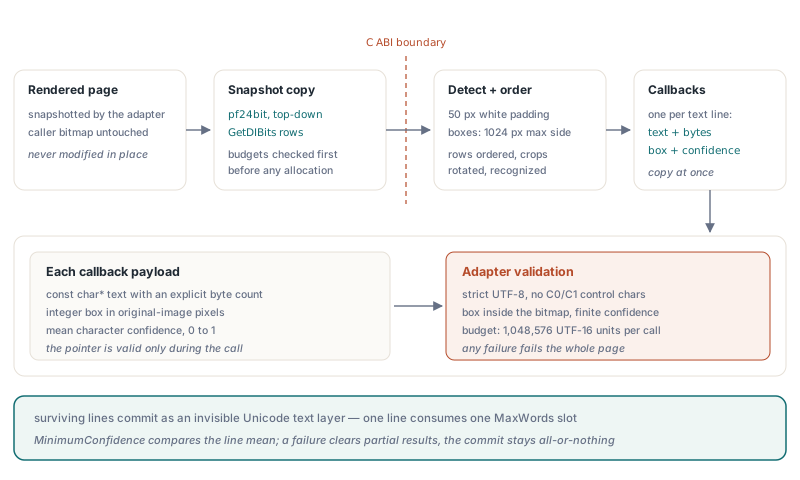
Dentro la DLL l'immagine riceve un bordo bianco di 50 pixel, le regioni di testo vengono rilevate con il lato lungo scalato a non più di 1.024 pixel, e le box vengono ordinate in righe orizzontali. Con il classificatore d'angolo attivo, un ritaglio viene girato di 180 gradi solo quando il punteggio capovolto supera 0,9, il che impedisce a una previsione debole di rovesciare parole corte. Ogni riga poi arriva come const char*, un conteggio di byte, una box intera in pixel dell'immagine originale, e la confidenza media dei caratteri. L'adapter è severo su ciò che accetta:
- L'UTF-8 viene decodificato con
MB_ERR_INVALID_CHARS, così una sequenza di byte malformata fa fallire la pagina invece di piantare caratteri sostitutivi in un livello ricercabile - I caratteri di controllo C0 e C1 vengono rifiutati; le righe di soli spazi vengono saltate
- La box deve giacere dentro la bitmap, e la confidenza deve essere un valore finito da 0 a 1
- Il testo viene contato contro il
MaxTextCodeUnitsdella richiesta, con un tetto duro di 1.048.576 unità UTF-16 per chiamata; i caratteri fuori dal Basic Multilingual Plane costano due unità - Un'eccezione Pascal dentro il callback viene colta lì, conservata, e trasformata in un ritorno 0, il che fa fermare la DLL; il messaggio conservato diventa
Info.Diagnostic
Due di questi dettagli contano quando regoli l'output. L'unità è una riga, non una parola: ogni riga consuma uno slot MaxWords, Info.AcceptedWordCount e Info.DroppedWordCount contano righe, e un hit di ricerca evidenzia l'intera box della riga. E MinimumConfidence viene confrontato con la confidenza media dei caratteri della riga, così un carattere sporco su venti puliti raramente affonda la riga. Alzare la soglia a 0,7 o 0,8 scarta righe intere, mai singoli caratteri. Una pagina vuota riesce con zero righe, e qualsiasi fallimento scarta i risultati parziali così la scrittura multipagina resta tutto-o-nulla
Un motore, una copia dei modelli, un chiamante alla volta
Ogni motore della DLL RapidOCR possiede esattamente una istanza di modello per l'intera propria vita, e le chiamate Recognize su quel motore vengono serializzate da una sezione critica. Tenere il riferimento IHPDFOCREngine è ciò che tiene i modelli in memoria, quindi il lavoro a lotti dovrebbe creare il motore una volta e riutilizzarlo su ogni documento
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // scansioni dritte: nessun modello classificatore caricato
  Models.Threads := 4;                   // 1..64, limitato ai processori attivi
  Models.TimeoutMilliseconds := 120000;  // per chiamata Recognize, cooperativo
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // ultimo riferimento rilasciato: modelli distrutti, poi la DLL viene scaricata
Threads stabilisce sia i conteggi di thread intra-op sia inter-op di ogni sessione ONNX del motore, e la DLL lo limita al numero di processori attivi. Due thread che condividono un motore non eseguono mai inferenza in parallelo; il secondo aspetta. Quell'attesa non è una EnterCriticalSection alla cieca. L'adapter prova il lock con TryEnterCriticalSection, dorme 25 ms tra i tentativi, e controlla il token di cancellazione e la scadenza ogni volta, così una richiesta in coda può ancora essere cancellata
L'orologio della scadenza parte quando si entra in Recognize, prima che il lock venga preso. Il tempo passato in coda dietro un'altra pagina conta contro TimeoutMilliseconds. Con quattro worker thread su un motore e una scadenza di 60 secondi, la quarta pagina può andare in timeout senza mai raggiungere il modello. Dai invece a ogni worker il proprio motore. Costa una copia dei modelli in memoria per motore, e quella memoria compra timeout prevedibili e vero parallelismo; condividere un solo motore ha senso solo quando le richieste sono così rare che quasi non fanno mai coda
Perché una chiamata OCR nativa non può essere uccisa a metà inferenza?
Una chiamata RapidOCR nativa non può essere uccisa a metà inferenza perché gira sul tuo thread, dentro il tuo processo, in mezzo a una sessione ONNX Runtime che non ha alcuna API di interruzione per una Run in corso. La cancellazione nell'adapter DLL è cooperativa. La DLL chiama un callback di aborto prima e dopo il rilevamento, dopo la classificazione di ogni ritaglio, e dopo ogni riga riconosciuta, e si ferma al primo checkpoint dove il callback restituisce 0. Una singola Run già partita finisce prima
Le opzioni violente sono peggio dell'aspettare. TerminateThread lascerebbe il lock dell'heap della CRT, il thread pool di ONNX Runtime e qualsiasi stato OpenCV nella condizione in cui si trovavano. Chiamare FreeLibrary mentre una chiamata è ancora in esecuzione smappa codice che sta sullo stack. Nessuna delle due può essere resa sicura, quindi l'adapter non ci prova mai. Una scadenza scaduta torna come otlsEngineError con una diagnostica di timeout; un token cancellato torna come otlsCancelled:
// Il token è creato dal chiamante e condiviso con il thread UI,
// che chiama Token.Cancel quando l'utente preme Stop
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // fermato al prossimo checkpoint di stadio o riga; documento invariato
        Writeln('Cancelled');
      otlsEngineError:
        // include una scadenza cooperativa scaduta e diagnostiche native
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // un limite pagina, pixel, parole o contenuto in Options è stato raggiunto
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Questo è il vero compromesso tra gli adapter di processo e la DLL in-process, e nessuno dei due vince su ogni riga:
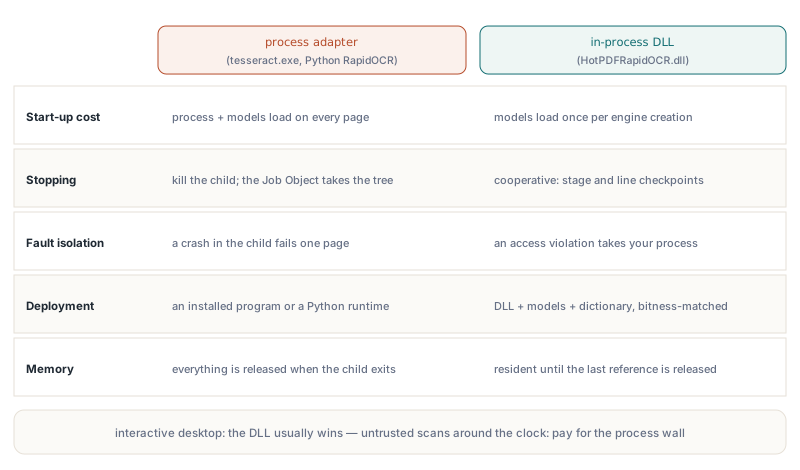
- Costo di avvio: gli adapter Tesseract e Python RapidOCR lanciano un processo e caricano i modelli per ogni pagina; la DLL carica i modelli una volta per motore
- Fermata: un processo figlio può essere terminato sul posto, e il worker Python gira dentro un Job Object kill-on-close così il suo intero albero di processi se ne va con lui; la DLL si ferma ai checkpoint di stadio e riga
- Contenimento dei guasti: un crash in
tesseract.exefa fallire una pagina; una access violation dentro la DLL ti porta giù il processo - Deployment: gli adapter di processo hanno bisogno di un programma installato o di un ambiente Python; la DLL ha bisogno di sé stessa, dei suoi modelli e del suo dizionario, corrispondenti alla bitness dell'applicazione
- Memoria: un adapter di processo rilascia tutto quando il figlio esce; un motore DLL tiene i modelli residenti finché l'ultimo riferimento all'interfaccia non va via
Scegli la DLL per un'applicazione desktop interattiva che fa OCR di una pagina alla volta e ha bisogno di un pulsante Stop reattivo che restituisce entro uno stadio di inferenza. Per un server che ingurgita scansioni non fidate giorno e notte, paga il costo di avvio per pagina e tieni il confine di processo; un'immagine costruita apposta che manda in crash un recognizer deve costare una pagina, e con un processo figlio lo fa
Costruire HotPDFRapidOCR.dll e scegliere i modelli
HotPDFRapidOCR.dll si costruisce dai sorgenti C++ in Native/RapidOCR con MSVC, C++17, una Windows SDK, e CMake 3.20 o successivo. L'helper tools/Build-HotPDFRapidOCR.ps1 prende le directory dei sorgenti nativi, ONNX Runtime, e OpenCV più -Platform Win32 o Win64, e scrive il risultato in Lib/Native/RapidOCR/<Platform>/. Costruisci entrambe se spedisci entrambe. Un'applicazione Delphi a 32 bit non può caricare una DLL a 64 bit, e le librerie statiche che fornisci devono corrispondere all'architettura bersaglio oltre alla modalità CRT
I modelli hanno regole di compatibilità proprie. Il rilevatore è un DB text detector. Il recognizer accetta modelli CTC in layout NCHW con altezza di ingresso fissa di 32 o 48, e usa 48 quando il modello dichiara un'altezza dinamica. Il formato del modello deve essere uno che la ONNX Runtime collegata staticamente capisce; export più recenti come PP-OCRv5 possono richiedere un runtime più nuovo, e un modello illeggibile fallisce all'inizializzazione con una diagnostica. tools/Install-RapidOCRModels.ps1 installa pack PP-OCRv3 e PP-OCRv4 verificati contro hash SHA256 fissati, con rilevatore e classificatore condivisi sotto i nomi di file che Default si aspetta. Resta su quei pack a meno che tu controlli anche la build del runtime
Il dizionario deve essere UTF-8 senza BOM, nell'esatto ordine di caratteri del modello, e il suo numero di voci deve corrispondere alle classi di output del modello. I finali di riga CRLF vanno bene. Quando un modello incorpora la propria lista di caratteri nei metadati, l'inizializzazione confronta ogni voce e la sua posizione con il file del dizionario, così un dizionario che ha solo la lunghezza giusta fallisce comunque. La DLL non scarica mai un modello mancante
HotPDF include l'adapter RapidOCR nativo insieme agli adapter OCR a processo, il renderer di pagina che li alimenta, e lo scrittore del livello di testo Unicode invisibile, tutto dentro un componente VCL nativo per Delphi e C++Builder. Per software di acquisizione e archiviazione che deve produrre PDF ricercabile su macchine senza Python installato, l'HotPDF Delphi PDF Component lascia da distribuire solo la DLL e i suoi file di modello