Una fattura russa passata in un recognizer che carica il modello cirillico ma continua a leggere il dizionario di caratteri cinesi torna come file di caratteri Han perfettamente validi. Ogni riga è UTF-8 ben formato, ogni riga atterra nel livello di testo ricercabile, e una ricerca per qualsiasi parola stampata sulla pagina non trova niente. Il modello ha fatto il suo lavoro. Un recognizer CTC non produce mai caratteri, solo numeri di classe, e il file del dizionario è l'unica cosa che mappa la classe 1.204 a un glifo
Tre fallimenti affini stanno lì accanto, e una demo in scrittura latina non ne mostra nessuno: ogni riga che perde il proprio carattere finale, testo inglese che arriva senza spaziatura tra le parole, e text box arabe che tornano in ordine da sinistra a destra. Ognuno risale a una regola del dizionario, a un confine di ciclo o a un ordinamento che è facile sbagliare di poco. Tutti e quattro partono dallo stesso punto: il passo che trasforma un tag di lingua in un modello e un dizionario
Preset linguistici RapidOCR in HotPDF: un tag, una coppia fissata
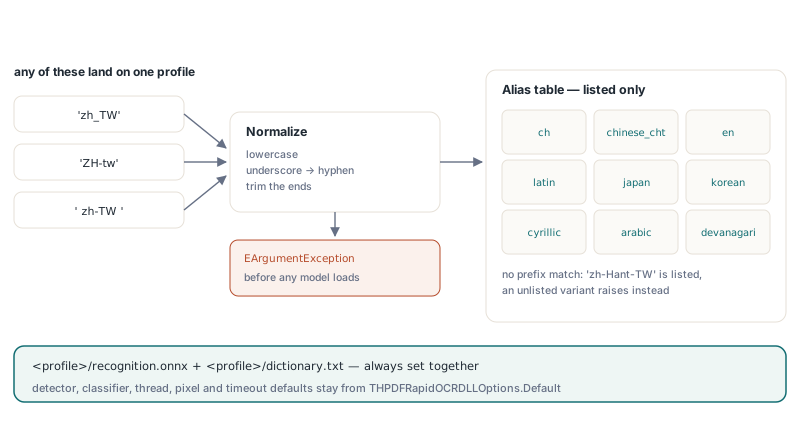
In HotPDF, THPDFRapidOCRDLLOptions.ForLanguage trasforma un tag di lingua in opzioni che puntano a <profile>/recognition.onnx e <profile>/dictionary.txt sotto la tua directory dei modelli. Tutto il resto viene da THPDFRapidOCRDLLOptions.Default: il rilevatore condiviso, il classificatore d'angolo opzionale, un thread, un budget di 16.777.216 pixel per richiesta e un timeout di 60 secondi. Il tag viene messo in minuscolo, i trattini bassi diventano trattini e gli spazi ai bordi vengono tagliati, così 'zh_TW', 'ZH-tw' e ' zh-tw ' risolvono allo stesso profilo
L'abbinamento gira su una lista esplicita di alias, senza confronti per prefisso. 'zh-Hant-TW' e 'zh-MO' vengono accettati perché sono elencati; 'pt-AO' no, e ForLanguage solleva EArgumentException prima che qualsiasi file venga aperto. Quella rigidità è voluta. Una regola per prefisso manderebbe silenziosamente 'zh-Hant-SG' o qualche tag futuro al profilo che condivide le prime due lettere, e con il cinese le prime due lettere non ti dicono quale scrittura sia
| Profilo | Lingue | Tag di esempio | Ordine delle box in una riga |
|---|---|---|---|
ch | Cinese semplificato e inglese | zh, zh-CN, zh-Hans, chi_sim | Da sinistra a destra |
chinese_cht | Cinese tradizionale | zh-TW, zh-HK, zh-Hant, chi_tra | Da sinistra a destra |
en | Inglese | en, en-US, en-GB, eng | Da sinistra a destra |
latin | Francese, tedesco, spagnolo, portoghese, italiano, olandese, turco | fr, de, es-419, pt-BR, tr | Da sinistra a destra |
japan | Giapponese | ja, ja-JP, jpn | Da sinistra a destra |
korean | Coreano | ko, ko-KR, kor | Da sinistra a destra |
cyrillic | Russo, ucraino, bulgaro, bielorusso | ru, ru-RU, uk, bg | Da sinistra a destra |
arabic | Arabo, persiano, urdu | ar, ar-SA, fa, ur | Da destra a sinistra |
devanagari | Hindi, marathi, nepalese | hi, mr, ne | Da sinistra a destra |
L'adapter non scarica mai nulla. I file dei modelli si provisionano una volta con l'helper incluso, per esempio tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, oppure -Language All per tutti e nove i profili. L'helper colloca il rilevatore e il classificatore condivisi ai nomi di file alla radice che Default si aspetta, e ogni profilo nella propria cartella. La creazione del motore, il confine della DLL e il threading sono trattati in l'articolo sulla DLL RapidOCR in-process; con i file al loro posto, una scansione in cinese semplificato diventa ricercabile così
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, detector e classificatore condivisi
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // i modelli si caricano qui; riusa il motore tra i documenti
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // lista pagine vuota = tutte le pagine; SkipPagesWithText lascia stare le pagine con testo
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Due numeri in quell'output vanno letti con attenzione. La pipeline nativa riporta un risultato per riga di testo rilevata, quindi AcceptedWordCount qui conta righe, e MinimumConfidence viene confrontato con la confidenza media dei caratteri dell'intera riga: una riga con media 0,45 viene scartata come unità. UniqueScalarCount è il numero di scalari Unicode distinti che il livello di testo ha dovuto mappare nel proprio font e nella tabella ToUnicode. Una pagina di testo cinese corpo dovrebbe spingere quel numero ben oltre le poche decine di scalari che una pagina latina richiede; un conteggio in territorio latino su una scansione cinese di solito significa che è caricato il profilo sbagliato
Perché cambiare solo il modello di riconoscimento produce spazzatura?
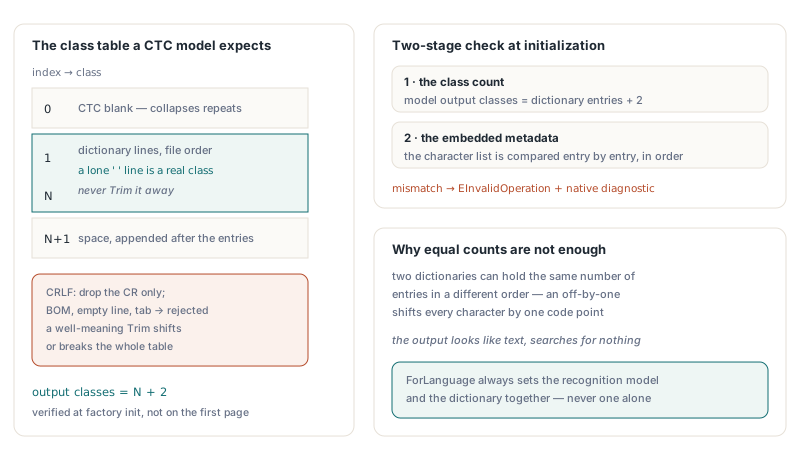
Perché il modello e il dizionario sono due metà di una stessa tabella di lookup, e solo il dizionario sa cosa significano gli indici. Punta RecognitionModel a cyrillic/recognition.onnx mentre CharacterDictionary nomina ancora il file cinese, e il modello emette indici cirillici validi che il vecchio dizionario traduce in caratteri Han casuali. ForLanguage imposta sempre entrambi i campi insieme. Le opzioni costruite a mano seguano la stessa regola: non cambiare mai uno senza l'altro
L'ovvia guardia, confrontare la dimensione del dizionario con la larghezza di output del modello, è necessaria e comunque non basta. Due dizionari possono contenere lo stesso numero di voci in ordine diverso, e uno scarto di uno sposta ogni carattere di una posizione. La DLL RapidOCR di HotPDF quindi controlla due volte mentre la factory inizializza il recognizer. Il conteggio di classi di output del modello deve eguagliare le voci del dizionario più due. Poi, se il file ONNX incorpora una lista di metadati character, ogni riga del dizionario viene confrontata con essa in ordine. Qualsiasi discrepanza fa sollevare a HPDFCreateRapidOCRDLLOCREngine una EInvalidOperation con la diagnostica nativa, così l'errore affiora all'avvio e non nell'archivio di un cliente
Il "più due" viene dal layout delle classi. La classe 0 è il blank CTC, le classi da 1 a N sono le righe del dizionario in ordine di file, e la classe finale è uno spazio. Alcuni dizionari portano anche una propria voce spazio, e quella riga va conservata esattamente com'è. È qui che un Trim ben intenzionato fa danno vero: trasforma la voce spazio in una stringa vuota e sposta o rompe la tabella. La DLL toglie un carriage return finale così i file CRLF si caricano, e rifiuta un byte order mark UTF-8, una riga vuota, o una voce che contiene una tab o un carriage return vagante
Se mantieni dizionari tuoi, un controllo pre-flight nello script di build o di deploy agguanta questi problemi prima del motore. La funzione qui sotto è codice tuo, scritto per rispecchiare le regole qui sopra
// Helper tuo, non un'API HotPDF: costruisce la tabella di classi che un
// recognizer CTC si aspetta e rifiuta i difetti di dizionario che rifiuta la DLL
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // newline a fine file
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // classe 0: CTC blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: togli solo il CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // mai Trim: ' ' è una classe
  end;
  Result[Last + 2] := ' ';                       // classe finale: spazio
  // Length(Result) deve eguagliare il conteggio classi dell'output del modello
end;
Decodifica CTC greedy e le sue tre trappole di confine
La decodifica CTC greedy sceglie la classe col punteggio più alto a ogni time step, collassa i ripetuti consecutivi in un solo carattere e scarta il blank. Il blank è ciò che permette a una lettera davvero raddoppiata di sopravvivere. Un modello di riconoscimento legge una riga di testo come una sequenza di strette fette verticali, e per ogni fetta produce una probabilità per ogni classe. Una riga contenente AA中 potrebbe produrre la sequenza di argmax A A blank A 中 spazio: i primi due step A collassano in uno, il blank li separa dalla successiva A, e l'output è AA中 con lo spazio finale intatto. Senza la regola del blank, book e bok decoderebbero identici
Un decoder che resta corto invita a errori di uno, e ogni errore produce il proprio sintomo riconoscibile. Ferma il ciclo argmax interno una classe prima e la classe spazio non può mai vincere, così ogni riga inglese o latina torna come una lunga parola unica e la ricerca di frasi smette di funzionare. Ferma il ciclo esterno un time step prima e l'ultimo carattere di ogni riga sparisce, che su un'etichetta di due caratteri è metà del testo. Dimentica di far azzerare la guardia dei ripetuti da un blank e i caratteri raddoppiati collassano: la ll di hello, o la reduplicazione 谢谢. Se scrivi un decoder per una pipeline tua, questi tre casi sono un set di test compatto. Il decoder di HotPDF copre l'ultima classe e l'ultimo step, conserva i ripetuti separati da blank, e rifiuta punteggi che non sono finiti o stanno fuori da 0 a 1, più qualsiasi conteggio di classi in disaccordo con il dizionario
// Illustrazione per una pipeline tua, non un'API HotPDF: decodifica CTC
// greedy con confini corretti. Scores tiene Steps * Classes
// probabilità, una riga per time step
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // la classe 0 è il CTC blank
  for Step := 0 to Steps - 1 do             // includi l'ultimo time step
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // includi l'ultima classe (spazio)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // un blank azzera la guardia dei ripetuti
  end;
end;
La beam search con un modello linguistico può risolvere qualche fetta ambigua su cui la decodifica greedy sbaglia, al costo reale di velocità e di un secondo set di file da versionare. Per documenti stampati renderizzati a 300 DPI la decodifica greedy è il default giusto, e il decoder è il posto sbagliato dove compensare ciò che il modello non vede. Vale lo stesso per le tabelle di sostituzione dei caratteri. Se un modello legge una lettera accentata come la sua lettera base, patchare l'output con una tabella di sostituzione sistema una lingua e rompe un'altra. Un carattere sbagliato in un livello ricercabile è peggio di uno mancante, perché la ricerca trova il documento sbagliato invece di nessun documento, quindi il testo riconosciuto entra nel PDF esattamente come il modello l'ha prodotto
Come vengono ordinate le righe di testo per l'arabo da destra a sinistra?
La DLL ordina le text box rilevate dall'alto al basso, raggruppa le box in una riga quando si sovrappongono verticalmente per almeno metà dell'altezza della box più piccola, e ordina ogni riga da sinistra a destra, o da destra a sinistra quando RightToLeft è impostato. I caratteri dentro una riga riconosciuta non vengono mai invertiti. Il raggruppamento in righe conta perché i rilevatori spesso spezzano una riga visiva in più box, per esempio un'etichetta e un valore separati da un ampio varco, e un puro ordinamento per coordinata alta li intreccerebbe con la riga successiva ogni volta che le loro alte differiscono di un pixel o due
Il profilo arabo è l'unico per cui ForLanguage imposta RightToLeft := True, che fa ordinare alla DLL ogni riga per i bordi destri delle box, partendo dal margine destro. È tutto l'effetto. Il testo che il modello restituisce per una riga è già in ordine logico Unicode, l'ordine in cui un lettore arabo legge e digita, ed è anche l'ordine che l'estrazione del testo PDF e la ricerca si aspettano. Invertire la stringa perché "sembri giusta" nel debugger Delphi romperebbe ricerca, copia e incolla, e screen reader. La visualizzazione bidirezionale e la forma dei glifi sono compito del viewer PDF
Un motore serve un profilo lingua, e non c'è rilevamento automatico della scrittura. Un documento che mescola scritture ha bisogno di un motore per profilo, ciascuno applicato alle proprie pagine. ApplyLoadedOCRTextLayer prende una lista pagine esplicita e scrive ogni chiamata come transazione a sé, così un fallimento sulle pagine arabe fa rollback di quella chiamata senza toccare il livello cinese già scritto
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // solleva EArgumentException per un tag non elencato, prima che qualsiasi modello carichi
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // spazio per pagine A3 a 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // profilo chinese_cht
  Arabic := CreateRapidEngine('ar-SA');   // profilo arabic, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
La riga MaxPixels c'è per un motivo. Il budget di default di 16.777.216 pixel per richiesta copre A4 e US Letter a 300 DPI con margine. Un foglio A3 a 300 DPI fa circa 3508 per 4961 pixel, circa 17,4 milioni, quindi quella richiesta viene rifiutata e Info.Diagnostic riporta una richiesta non valida o un budget pixel superato. Alza MaxPixels fino al tetto di 67.108.864, o abbassa THPDFOCRTextLayerOptions.DPI per i formati grandi. L'ordinamento da destra a sinistra passa per l'export della DLL HPDFRapidOCRSetReadingDirection, che l'adapter va a cercare solo quando RightToLeft è impostato; una build della DLL senza quell'export continua a servire i profili da sinistra a destra, e creare un motore arabo con essa solleva una EArgumentException che nomina l'export mancante
Model pack fissati e cosa deve passare una coppia personalizzata
La DLL RapidOCR di HotPDF collega una ONNX Runtime compilata staticamente, quindi legge le versioni del formato file ONNX che quel runtime capisce e niente di più recente. Export di modelli recenti possono puntare a un formato più nuovo; un file del genere viene rifiutato alla creazione del motore con una diagnostica nativa. Quell'abbinamento è il motivo per cui ogni language pack punta a uno specifico recognizer e dizionario che si caricano e passano i controlli di classe sotto il runtime incluso, e perché i pack non sono mai "l'ultimo"
Install-RapidOCRModels.ps1 impone l'abbinamento su disco. Ogni file nel proprio manifest porta un hash SHA256. Un file esistente con hash diverso ferma l'installazione e resta al suo posto, per te da spostare o rimuovere, e ogni download viene scritto sotto un nome temporaneo e mosso in posizione solo dopo che il suo hash torna. Questo blocca la versione silenziosa del problema del dizionario: qualcuno copia a mano un recognition.onnx più recente in una cartella di profilo, il conteggio di classi per caso torna, e il primo segnale di guaio è un cliente che dice che la ricerca non trova parole che si vedono benissimo. Se installi con -SkipClassifier, imposta UseAngleClassifier := False nelle opzioni, perché Default si aspetta il file del classificatore e la creazione del motore controlla che esista
Il recognizer controlla anche la forma di input del modello al caricamento. Accetta input float NCHW con altezza fissa di 32 o 48 pixel, o altezza dinamica, che esegue a 48. Un modello esportato con qualsiasi altra altezza fissa fallisce la creazione del motore con "Unsupported recognition model input or output shape"
Per una scrittura che nessuno dei nove profili copre, RecognitionModel e CharacterDictionary possono puntare ai tuoi file, e ogni controllo qui sopra si applica comunque. Una coppia disabbinata fallisce alla creazione del motore, nella tua esecuzione di test. Per le pagine dove nessun profilo RapidOCR sta, l'adapter Tesseract per PDF ricercabile si innesta nella stessa chiamata ApplyLoadedOCRTextLayer, e per moduli ASCII stampati il motore OCR integrato a corrispondenza di template non ha bisogno di file di modelli affatto
I preset linguistici, l'adapter RapidOCR nativo e il livello di testo OCR sono tutti inclusi nel HotPDF Delphi PDF Component per progetti Delphi, C++Builder e FPC/Lazarus su Windows