La casella di ricerca di un viewer evidenzia "Acme Corp" a pagina 2 di una fattura, eppure una ricerca per byte degli stessi nove caratteri nello stream di pagina decompresso torna vuota. Per la sola prima parola, lo stream può contenere qualcosa come <0024004600500048> Tj: codici di glifo a due byte in un subset di font embedded, con lo spazio tra le due parole prodotto da un offset di posizionamento e non da un carattere spazio. Sostituire quel nome significa decodificare quei codici in Unicode, cercare lì la corrispondenza, risalire ai byte esatti che hanno prodotto il risultato e scrivere nuovi codici che lo stesso font capisca. Quando il subset non ha mai contenuto un glifo di cui il nuovo testo ha bisogno, non ci sono codici da scrivere
Le richieste dietro tutto questo sono ordinaria manutenzione di documenti. Un'azienda cambia nome e tremila fatture archiviate portano ancora quello vecchio. Un template di contratto è uscito con la data di scadenza dell'anno scorso. Un codice ricambio ritirato deve diventare il suo successore in ogni scheda tecnica. In un word processor ognuna di queste cose richiede trenta secondi; in un PDF ognuna si scontra con il modo in cui le pagine sono effettivamente memorizzate
Cosa memorizza una pagina PDF al posto del testo
Una pagina PDF contiene glifi posizionati, non testo modificabile. Secondo ISO 32000-1 §9.4, il content stream pilota operatori di text-showing come Tj e TJ, che dipingono sequenze di codici di carattere a posizioni stabilite dalla matrice testo. Quei codici sono indici in qualunque codifica dichiari il font corrente. La strada di ritorno verso caratteri leggibili può passare per una CMap /ToUnicode (§9.10.3), per un /Encoding con array /Differences, o per una catena di mappatura CID per i font Type0. Non c'è nessun oggetto paragrafo e nessun flusso di testo, e niente obbliga un producer a memorizzare una parola visibile come un'unica stringa: [(Ac) -12 (me)] TJ è un modo perfettamente ordinario di fare il kerning di una parola
La sostituzione aggiunge un secondo requisito sopra la decodifica. Un estrattore di testo può buttare via le posizioni dei byte una volta tirato fuori l'Unicode. Un sostitutore ne ha bisogno, perché deve sapere quali byte di quale operando stringa hanno prodotto ogni glifo, così da riscrivere esattamente quell'intervallo e lasciare in pace tutto il resto. Ecco perché una semplice StringReplace sui byte dello stream è lo strumento sbagliato anche sui file che per caso usano la codifica WinAnsi. Non ha idea di quale ( appartenga a una stringa e di quale Tf selezioni il font che dà a quei byte il loro significato
Cercare nella sequenza di glifi decodificata
HotPDF Delphi Component cerca in un documento caricato con SearchLoadedPageText e SearchLoadedDocumentText, che confrontano il testo cercato con la sequenza di glifi Unicode decodificata di ogni pagina, mai con i byte grezzi dello stream. Una corrispondenza è quindi una corrispondenza comunque il font l'abbia codificata. Durante la decodifica, ogni glifo tiene traccia dell'operando stringa, dell'elemento dell'array TJ e dell'offset in byte da cui proviene, ed è su questo che il passo di sostituzione si appoggia più avanti. Lo stesso interprete di glifi pilota l'API trattata in estrarre testo da un PDF caricato in Delphi; la ricerca si limita a conservare le posizioni sorgente che l'estrazione scarta
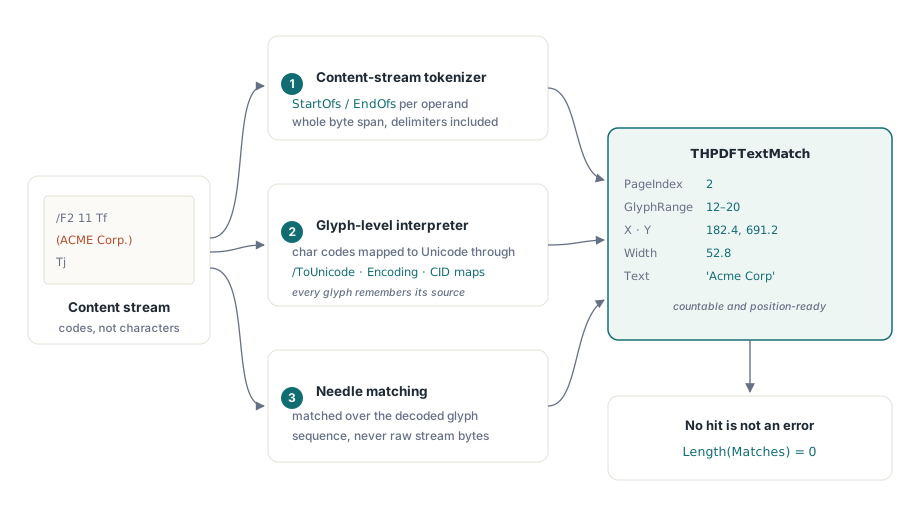
Ogni corrispondenza torna come record THPDFTextMatch: PageIndex, l'intervallo di glifi inclusivo in GlyphStart e GlyphEnd, l'origine in user space in X e Y, la Width della corrispondenza, i TokenIndex e ItemIndex sorgente, e il Text corrispondente. PageIndex parte da zero. Un testo che non compare dà un array vuoto e un risultato True, quindi il codice chiamante non ha bisogno di un caso speciale per "niente trovato"
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
Che quel ciclo stampi qualcosa dipende, prima di ogni altra cosa, dagli spazi. Il testo di ricerca è costruito dai glifi che la pagina dipinge davvero, un carattere per glifo, e un offset TJ che separa visivamente due parole è un numero in un array e non un glifo. Un producer che imposta gli spazi tra le parole con offset invece di un carattere spazio produce "AcmeCorp" nella sequenza di glifi, e il testo "Acme Corp" non lo troverà. Quando una frase visibile rifiuta di corrispondere, cerca prima la sua parola singola più lunga e guarda il Text di quello che torna
Le maiuscole sono l'altra cosa da controllare. Con CaseSensitive impostato a False, le build da Delphi XE2 in poi confrontano i caratteri tramite la mappatura Unicode simple lowercase, che è indipendente dal locale, quindi É corrisponde a é e le maiuscole greche o cirilliche corrispondono alle loro minuscole. Le build con compilatori più vecchi normalizzano solo A–Z. La mappatura è un carattere a un carattere, il che mantiene ogni posizione del testo cercato allineata a esattamente un glifo; la conseguenza è che ß non corrisponde a SS. Per i flussi UI a parola intera, SearchLoadedPageTextWholeWord scarta le corrispondenze che stanno dentro una parola più lunga, e GetLoadedSearchHitRect trasforma una corrispondenza in un singolo rettangolo per disegnare un'evidenziazione
Ricerca e sostituzione lavorano entrambe sugli stream /Contents della pagina stessa. Il testo dipinto dentro un Form XObject, che è dove molti strumenti mettono intestazioni e piè di pagina timbrati, vive in uno stream separato che la pagina invoca con Do, ed è fuori da entrambe le operazioni
Riscrivere i byte corrispondenti con ReplaceLoadedDocumentText
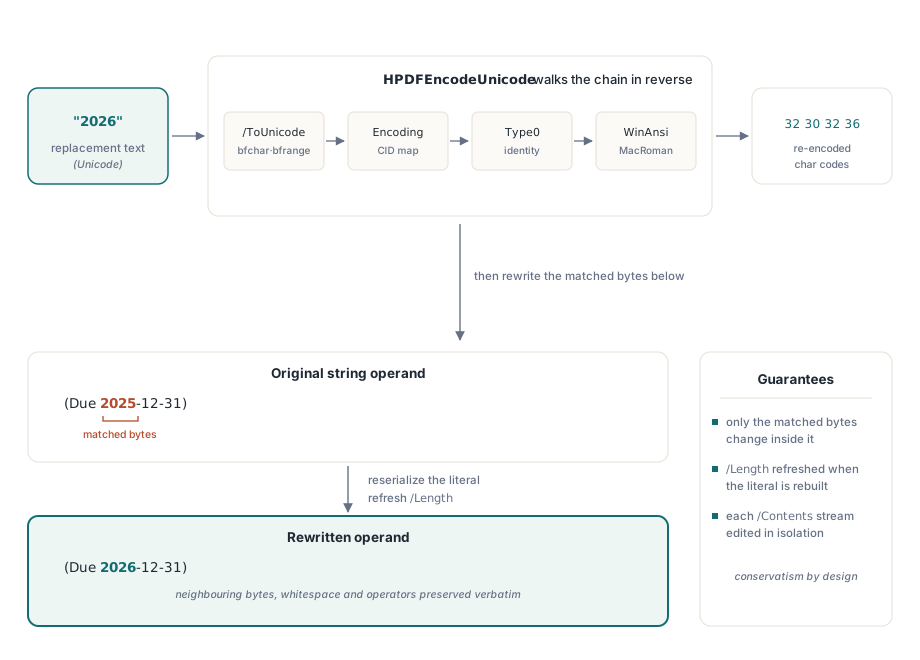
ReplaceLoadedPageText e ReplaceLoadedDocumentText riscrivono ogni occorrenza di un testo facendo girare la decodifica del font al contrario. Ogni carattere di sostituzione viene cercato attraverso la stessa catena usata dal decoder, in senso inverso: voci bfchar e bfrange di /ToUnicode, mappature CID per i font Type0, mappature identity e le tabelle predefinite WinAnsi e MacRoman. I codici carattere risultanti vengono riscritti come stringa letterale, o come stringa hex quando un byte cade fuori dall'ASCII stampabile, seguendo le stesse regole di escaping che il parser del content stream legge
Cambiano solo i byte coperti dalla corrispondenza. I byte non corrispondenti nello stesso operando, gli spazi tra i token, i commenti e ogni operatore circostante passano intatti. Sostituire bca dentro abcabc produce a + sostituzione + bc. La sostituzione può essere più corta o più lunga del testo cercato, e ogni stream nell'array /Contents di una pagina viene elaborato per conto suo così la pagina resta ben formata. Quando una corrispondenza è a cavallo di più operandi stringa, come Hello memorizzato come [(He) -20 (llo)] TJ, la sostituzione viene scritta nell'operando in cui inizia la corrispondenza e i byte corrispondenti vengono rimossi dagli operandi successivi
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
La pagina non viene ricomposta. Il PDF non ha reflow, quindi una sostituzione più larga dell'originale occupa semplicemente più spazio orizzontale e può finire addosso a qualunque cosa fosse dipinta alla sua destra; la posizione del glifo successivo è stata fissata dal producer e non si sposta. Date, stringhe di versione, codici ricambio e correzioni ortografiche di lunghezza simile sono il lavoro per cui questo metodo è fatto. Riformulare un paragrafo richiederebbe di ricomporre tutto ciò che segue, quindi quella modifica va fatta nel documento sorgente
Perché un subset di font non può accettare caratteri che non ha mai contenuto?
Un carattere di sostituzione che il subset embedded non ha mai incluso non ha alcun codice carattere a cui tornare. Quando un producer fa il subset di un font, la sua CMap /ToUnicode e la codifica coprono solo i glifi usati dal documento originale, e i contorni dei glifi di tutto il resto semplicemente non sono nel file. Se il documento non ha mai stampato una E maiuscola in quel font, nessuna sequenza di byte ne seleziona una. Quel limite sta nel file, non nello strumento che fa la sostituzione
ReplaceLoadedDocumentText tratta una sostituzione non codificabile in modo conservativo: se anche un solo carattere non può essere ricodificato, quell'occorrenza viene saltata per intero. Nessuna eccezione e nessuna stringa sostituita a metà, e il testo originale resta leggibile. Nell'esempio della data qui sopra, la cifra 6 deve esistere da qualche parte in quello stesso font perché la riscrittura riesca. Supponi che il font abbia stampato solo "2025" e qualche totale d'ordine senza alcun 6: le date restano come sono
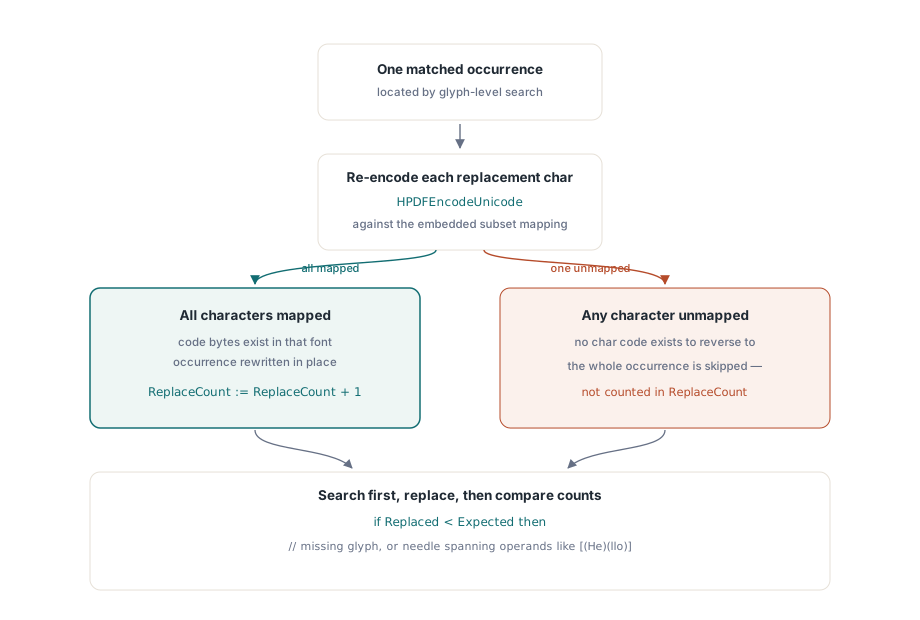
ReplaceCount riporta le riscritture di operandi, e una corrispondenza distribuita su più operandi può valere più di una riscrittura. Un conteggio più basso del numero di corrispondenze significa comunque che qualcosa è stato saltato, ma la risposta esatta arriva cercando di nuovo dopo la sostituzione. Quello che trova la seconda ricerca è ciò che è rimasto, con pagina e posizione allegate
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Ricercare funziona solo quando NewText non contiene a sua volta OldText
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Quando il subset è corto: preview e apply con un nuovo font
Per le occorrenze che il metodo a livello di byte non riesce a codificare, PreviewLoadedPageTextReplacement e ApplyLoadedPageTextReplacement seguono una strada diversa: rimuovono i glifi corrispondenti e disegnano la sostituzione al loro posto con un font scelto da te, alla dimensione originale e sulla baseline originale. Il THPDFLoadedTextReplacementOptions predefinito usa Arial alla dimensione del font del testo corrispondente, dimensiona il box alla larghezza del testo corrispondente e tiene Atomic attivo. Una sola corrispondenza rifiutata sulla pagina fa allora tornare indietro le altre. La preview restituisce un piano con un risultato per corrispondenza, ciascuno con uno Status e, se rifiutato, una Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf è un THotPDF caricato; PageIndex è una pagina a base zero segnalata dall'audit
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
Le ragioni di rifiuto vale la pena stamparle perché mappano direttamente sulla geometria della pagina. Una corrispondenza che passa da una riga di testo alla successiva viene rifiutata, e così il testo verticale. Con la policy di overflow predefinita ltopReject, viene rifiutata anche una sostituzione che non sta nella larghezza corrispondente. ltopShrinkToFit riduce invece la dimensione a passi verso MinFontSize, ed è per questo che l'esempio la imposta per una sostituzione più lunga di cinque caratteri rispetto al testo cercato. Anche una sostituzione contenente caratteri che il font scelto non può mostrare viene rifiutata
Il piano porta un'impronta del contenuto e dei font della pagina. Se qualcosa cambia la pagina tra preview e apply, ApplyLoadedPageTextReplacement solleva EInvalidOpException invece di scrivere su una pagina che la preview non ha mai visto. Le pagine con coppie q/Q o BT/ET sbilanciate, e i documenti che contengono campi firma, sollevano EArgumentException; i documenti firmati richiedono aggiornamenti incrementali così che la revisione firmata resti intatta
La sostituzione a livello di byte va per prima, e il percorso con cambio di font gira solo sulle pagine dove l'audit trova ancora il vecchio testo. La riscrittura a livello di byte mantiene il font originale, le sue metriche e il suo kerning, così il testo modificato si intona ai vicini sulla riga. Il percorso con preview disegna con un carattere diverso, e su una riga composta in un font condensato o con grazie un lettore attento vedrà la differenza. Quando l'obiettivo è far sparire il testo e non riformularlo, la vera rimozione del contenuto è lo strumento migliore; redigere e ristrutturare PDF caricati in Delphi copre quella strada
Cosa cambia nel file salvato
Un content stream modificato da ReplaceLoadedPageText viene salvato non compresso. Lo stream viene decodificato per la modifica, e quando i byte ricostruiti vengono riscritti le sue voci /Filter e /DecodeParms vengono tolte e /Length viene aggiornato. Il PDF è valido e si renderizza normalmente; il costo è un file più grande per ogni stream modificato. Un job batch su migliaia di fatture dovrebbe mettere in conto quella crescita o eseguire dopo un passaggio di compressione
Il percorso preview-e-apply cambia un po' di più. Una pagina a cui è stata applicata la sostituzione riceve un singolo nuovo content stream non compresso al posto del suo /Contents originale, più una copia propria del dizionario delle risorse con il font di sostituzione aggiunto. Tutto il resto del documento viene lasciato stare: gli stream non toccati mantengono la loro compressione, i font e le immagini esistenti non vengono riscritti, e le pagine senza corrispondenze non vengono mai aperte in scrittura. Come gli oggetti riscritti finiscono nella struttura cross-reference al salvataggio è trattato in object stream e aggiornamenti incrementali in HotPDF
Ricerca, sostituzione a livello di byte, sostituzione preview-e-apply, estrazione e redazione girano tutte sullo stesso interprete di content stream, da Delphi 5 fino a RAD Studio corrente, senza dipendenze esterne. I riferimenti dei metodi, le opzioni di sostituzione e una build di prova sono sulla pagina prodotto di HotPDF Delphi Component