Un parser va in stallo su un PDF malformato quando un ramo legge un byte, decide di non gestirlo e torna indietro senza muovere il cursore. Il loop chiamante non vede progressi né motivi per fermarsi, quindi gira all'infinito. HotPDF aveva esattamente questo difetto in tre parser indipendenti, tutti raggiungibili da input sotto i cinquanta byte
È una classe di denial-of-service che merita un nome a parte, perché non assomiglia a quella contro cui tutti si difendono già. Niente decompressione, niente crescita delle allocazioni, nessuna pressione sulla memoria che faccia scattare un watchdog. Il processo resta al cento per cento di CPU su un singolo core con una manciata di byte in un buffer. Se hai aggiunto un budget di decodifica dopo aver letto amplificazione dei filtri annidati e bombe PDF, qui quel budget non scatta: non c'è nulla da decodificare e nulla da allocare. Fallimento diverso, fix diverso
Perché un file di quaranta byte costa più di una bomba di decompressione?
Perché il costo non ha alcuna relazione con la dimensione dell'input. Un attacco per amplificazione ha un rapporto che puoi mettere sotto controllo: tetti ai byte in uscita, tetti alla profondità di ricorsione, e il caso peggiore diventa finito. Un loop senza avanzamento non ha alcun rapporto da limitare. La condizione del loop è una funzione di un cursore che non cambia mai, quindi non è lento: non termina, e nessun limite basato sulla dimensione a monte può intercettarlo. Questo lo rende anche unico nel suo genere dal punto di vista operativo. Un crash ti dà uno stack, un out-of-memory ti dà una riga di log, e un parser in stallo ti dà un worker thread che non restituisce mai un risultato, una richiesta che non va mai in timeout perché niente a valle sa che è partita, e un ticket che dice che martedì il server è diventato lento. La causa strutturale ha sempre la stessa forma. Un tokenizer o un parser di valori ha una catena di rami chiave sul byte corrente. Ogni ramo che riconosce qualcosa consuma ciò che ha riconosciuto. Poi c'è un ramo finale, o una guardia prima della catena, che risponde per i byte che nessuno ha reclamato, e chi lo ha scritto lo tratta come un percorso d'errore invece che come un passo di scansione. I percorsi d'errore ritornano. I passi di scansione avanzano. Quando una funzione deve fare entrambe le cose, è l'avanzamento che viene dimenticato
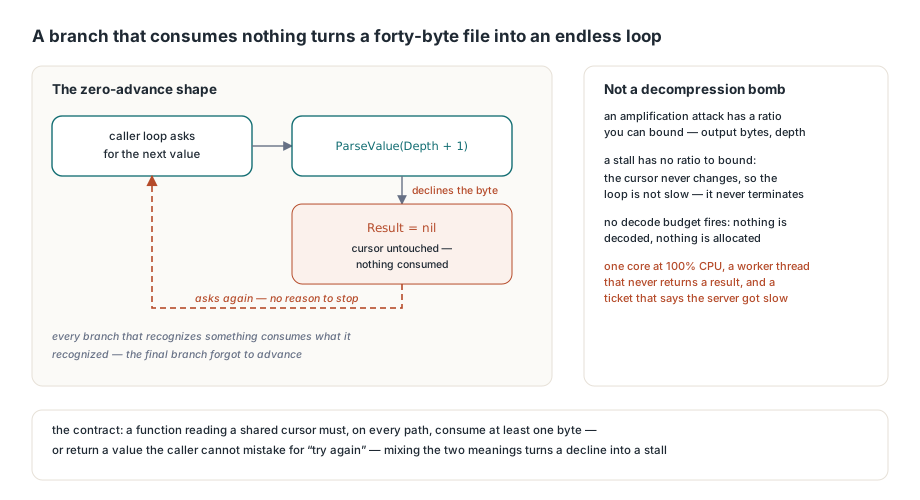
Il parser degli oggetti: due delimitatori che nessuno ha consumato
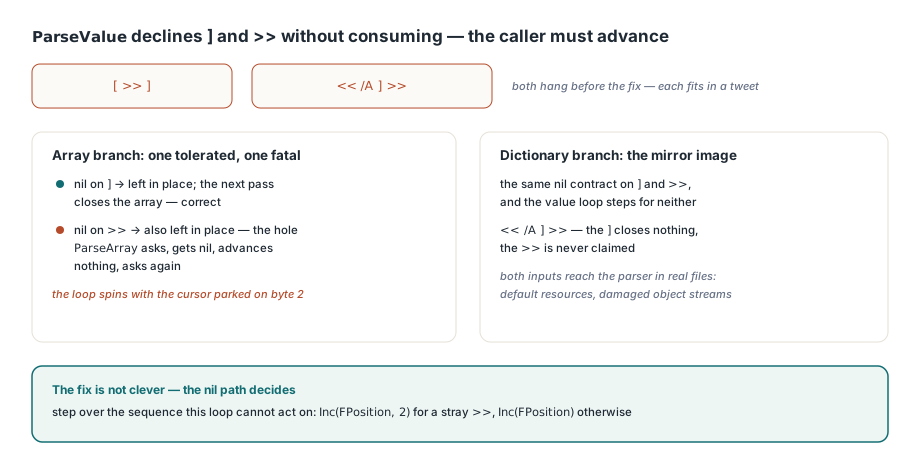
In HPDFParser, il metodo THPDFSpanObjectParser.ParseValue comincia rifiutando subito due sequenze di byte. Secondo la sezione 7.3 di ISO 32000-1, un valore non può iniziare con ] né con >>, perché chiudono un contenitore invece di aprirne uno, quindi ParseValue restituisce nil per entrambe senza consumarle. È il contratto corretto, e sposta tutto l'onere dell'avanzamento sul chiamante. Il ramo degli array ne rispettava metà: su un risultato nil controllava ], lo lasciava al suo posto perché il passaggio successivo chiudesse l'array, e scavalcava tutto il resto, tranne che il controllo era scritto in modo da lasciare al suo posto anche un >> fuori posto. Così [ >> ] va in stallo, perché ParseArray chiede un valore, ottiene nil, non avanza di nulla e richiede di nuovo. Il ramo dei dizionari aveva il buco speculare, e << /A ] >> si blocca allo stesso modo. Entrambi gli input sono abbastanza validi da arrivare al parser e abbastanza corti da stare in un tweet
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Prima della correzione, nessuna delle due chiamate sotto tornava mai
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Il fix non è geniale, ed è proprio questo il punto: il percorso nil deve decidere, esplicitamente, quale delle due sequenze non consumate il loop corrente può gestire, e scavalcare l'altra
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue restituisce nil sia per ']' sia per '>>' senza consumarli
  // Il ']' chiude l'array al passaggio successivo, ma un '>>' fuori posto
  // dentro un array va scavalcato o il parse non avanza mai
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
C'è un'altra cosa che merita attenzione qui. THPDFSpanObjectParser.RecordError si limita a incrementare ErrorCount in THPDFParserViewStatistics: non impone alcun tetto. Il parser imposta HPDFParserMaximumDepth a 64 per limitare l'annidamento, ma non ha alcun tetto equivalente sul conteggio degli errori, e un contatore che nessuno legge mai è un circuit breaker mancato. Anche con l'avanzamento ripristinato, un input che produce un errore per byte consumerà un oggetto grande a un ritmo che merita un'uscita anticipata invece di una traversata completa. Controlla Valid sul record delle statistiche dopo ogni parse e tratta un ErrorCount grande come un motivo per smettere di fidarti dell'oggetto, non solo come un dato diagnostico
La stessa forma nel tokenizer CMap e nel reader XFDF
HPDFCMapReader.NextToken aveva il difetto identico nel suo ramo di fallback. La funzione restituisce un TCMapTok e gestisce <, ( e / con rami dedicati; tutto il resto ricade in "leggi fino a whitespace o delimitatore". Quando il byte di partenza è esso stesso un delimitatore dell'insieme della sezione 7.2.2 di ISO 32000-1, quel loop gira zero volte, il token torna vuoto e il chiamante richiede lo stesso token di nuovo. Dei sei caratteri che possono finire lì, solo [ veniva intercettato prima dalla gestione di bfrange, quindi un ), >, ], { o } fuori posto in qualsiasi punto di un CMap ToUnicode bastava a bloccare l'estrazione del testo
// parola chiave o numero: leggi fino a whitespace o delimitatore
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Un delimitatore che nessuno dei rami sopra gestisce (un ')', '>',
// '[', ']', '{' o '}' fuori posto) lascerebbe P dov'era e restituirebbe
// una parola chiave vuota, quindi il chiamante richiederebbe lo stesso token all'infinito
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
Il lato XFDF aveva una variante con un'origine diversa e lo stesso effetto. HPDFXFDFXml.ParseElement imposta Result := P in cima, mentre P punta ancora al < iniziale, e solo dopo incrementa il suo cursore locale, quindi ogni uscita anticipata successiva restituisce la posizione di ingresso a meno che non sovrascriva prima Result. Una dichiarazione di doctype secondo la sezione 2.8 di XML 1.0, o qualsiasi altra cosa senza un nome di tag analizzabile come <1a>, prendeva un'uscita che non aggiornava mai Result, e il loop degli elementi figli riceveva la posizione che aveva passato in ingresso. Il loop degli attributi ne aveva altre tre, perché ReadName, il salto di whitespace e la gestione di = rifiutano tutti un byte che non è un carattere di nome, né whitespace, né uno tra =, >, /, e nessuno di loro lo consumava. La riparazione vicina per il CDATA ha spostato una responsabilità invece di aggiungere una guardia: una sezione CDATA secondo la sezione 2.7 di XML 1.0 inizia con <, quindi il loop dei figli la passava a ParseElement, che poi leggeva un nome di tag dal contenuto della sezione. Riconoscerla nel loop dei figli con IsCDATAStart e copiare i byte nel buffer di testo fino a IsCDATAEnd è la divisione corretta, e il vecchio salto era anche lungo un byte, dato che il marcatore misura otto byte contando dal !
Conteggi dichiarati che sopravvivono ai dati
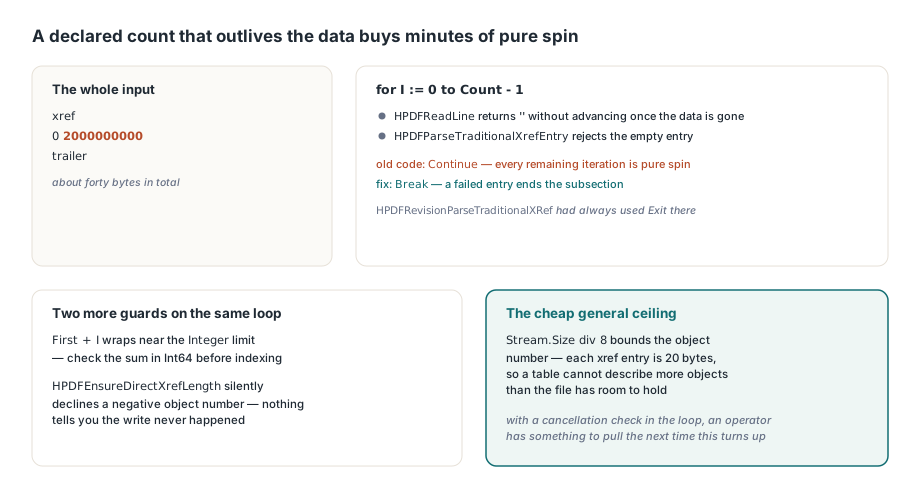
Una release successiva ha fatto emergere lo stesso pattern dalla direzione opposta, ed è la variante che più probabilmente esiste nel tuo codice. L'intestazione di una sottosezione di cross-reference secondo la sezione 7.5.4 di ISO 32000-1 è una coppia first count, ed entrambi i parser tradizionali di HotPDF ci giravano sopra con for I := 0 to Count - 1, usando Continue invece di Break quando una voce non riusciva a essere analizzata. Sembra tolleranza per una riga sbagliata. Non lo è: HPDFReadLine restituisce una stringa vuota senza avanzare quando i dati finiscono, e HPDFParseTraditionalXrefEntry rifiuta subito una voce vuota, quindi ogni iterazione rimanente del conteggio dichiarato è puro spin. L'aritmetica è spietata: l'intestazione xref\n0 2000000000\ntrailer più un wrapper minimale fa circa quaranta byte, e compra decine di secondi di un core occupato senza alcun controllo di cancellazione nel loop. L'indizio era nello stesso unit, perché HPDFRevisionParseTraditionalXRef aveva sempre usato Exit in quella posizione. Quando due funzioni analizzano la stessa grammatica e non concordano sul fatto che una voce fallita chiuda la sottosezione, una delle due è un fork che ha smesso di ricevere i fix, la stessa firma che salta fuori nella gestione delle cross-reference ibride dove una tabella tradizionale e uno stream descrivono gli stessi oggetti
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Un conteggio dichiarato più grande della tabella girerbbe altrimenti
  // qui senza più dati da leggere
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First viene dall'intestazione della sottosezione, quindi la somma va in wrap per un
  // inizio dichiarato vicino al limite di Integer, e l'helper di crescita
  // rifiuta in silenzio un indice negativo
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... registra la voce ...
end;
I due limiti dopo il Break appartengono alla stessa riparazione. HPDFEnsureDirectXrefLength rifiuta di far crescere l'array per un numero di oggetto negativo e non dice nulla al riguardo, e First + I va in wrap per un inizio dichiarato vicino al limite di Integer, quindi un indice negativo arriva alle scritture qui sotto. Il tetto sul numero di oggetto di Stream.Size div 8 è la risposta generale ed economica, perché nessuna tabella di cross-reference tradizionale può descrivere più oggetti di quanti il file abbia spazio per contenerne, e qualsiasi intestazione che affermi il contrario sta descrivendo un file che non esiste. Se stai riparando a mano una tabella danneggiata, lo stesso ragionamento vale dal lato opposto, che è il territorio coperto dalle note su diagnosi e riparazione dei PDF modificati a mano
Come dimostri che un fix per lo stallo funziona davvero?
Eseguendo il codice vecchio, non rileggendolo. Uno stallo è una delle poche classi di difetti in cui un fix si può verificare con un segnale binario e senza strumentazione, perché il processo o ritorna o non ritorna, e ragionare sul controllo di flusso è esattamente la capacità che ha prodotto il bug in primo luogo. Il meccanismo merita di essere copiato. Estrai la revisione pre-fix degli unit modificati in una directory scratch, poi compila una piccola probe con il percorso di ricerca degli unit che mette quella directory davanti alla libreria reale: dcc32 -U<scratchdir>;<Lib> probe.dpr. Il compilatore prende i sorgenti vecchi per quello che trova per primo e i sorgenti correnti per tutto il resto, quindi un singolo binario di probe esercita il parser vecchio contro il resto della libreria. Eseguito con un timeout, quaranta secondi sono generosi, e tratta l'exit code 124 come l'asserzione. Poi togli gli unit dalla directory scratch uno alla volta e ricompila. Tutti e tre gli stalli si sono riprodotti così, ognuno attribuibile a un unit specifico, e tutti e tre sono spariti una volta rimesso il sorgente corretto nel percorso, al costo di una compilazione per unit
Prima di provarci, ci sono due trappole da conoscere. Il percorso di ricerca degli unit è permissivo in silenzio: passa a -U un percorso in stile Unix da una shell, come $PWD, e il compilatore ignora quella directory senza dire una parola, il che significa che la tua probe ha compilato contro i sorgenti correnti ed è passata per il motivo sbagliato. Converti prima il percorso nella forma nativa di Windows. La seconda è che la directory scratch non contiene gli include, quindi serve anche -I<Lib> per HotPDF.inc, altrimenti la build fallisce in un modo che sembra un problema di sorgenti invece che di percorso. E sii onesto su cosa il metodo non ti dà: conferma che un input specifico ha smesso di bloccarsi su una build specifica, e non dice nulla sugli input a cui non hai pensato. I difetti con avanzamento zero si trovano col fuzzing o leggendo ogni ramo di ogni tokenizer, non con test di regressione scritti dopo i fatti
Cosa controllare nei tuoi parser
La regola riutilizzabile è un contratto, non una voce di checklist. Qualsiasi funzione che legge da un cursore condiviso deve, su ogni percorso inclusi quelli di errore, o consumare almeno un byte o restituire un valore che il chiamante non possa scambiare per "riprova". Mischiare questi due significati in un singolo nil o in un singolo token vuoto è ciò che trasforma un rifiuto in uno stallo. Quindi cerca la forma, non il sintomo. Trova ogni loop la cui terminazione dipende da un cursore posseduto da un'altra funzione, e chiediti cosa succede quando quella funzione rifiuta il byte corrente. Trova ogni ramo di fallback scritto come "leggi fino a X" e chiediti cosa fa quando il cursore è già su X. Trova ogni loop limitato da un conteggio che viene dal file e non dai dati, e fai sì che un elemento fallito chiuda il loop invece di saltare un'iterazione. Dove la stessa grammatica è analizzata in due punti, fai un diff, perché uno avrà ricevuto un fix che l'altro non ha avuto. E metti un controllo di cancellazione dentro ogni loop che può girare per un numero di iterazioni fornito dal chiamante, così un operatore ha qualcosa da tirare quando il prossimo di questi salta fuori in produzione
I parser descritti qui sono inclusi nell'attuale HotPDF Delphi Component per Delphi e C++Builder, con i record delle statistiche e i limiti di profondità esposti così che il tuo hardening possa costruirci sopra