HotPDF può salvare un documento caricato in una forma diagnostica pensata per essere letta e modificata da un essere umano, e poi riparare il file dopo che l'avete modificato. SaveLoadedDocumentDiagnostic scrive il documento con un ordinamento deterministico dei dizionari, ogni oggetto come normale oggetto indiretto, senza object stream, senza cross-reference stream e senza linearizzazione. RepairDiagnosticDocument ricostruisce poi gli offset dei byte, le lunghezze degli stream, la tabella dei riferimenti incrociati e il trailer che la vostra modifica ha invalidato
Questa coppia esiste per un unico flusso di lavoro: capire o correggere cosa c'è davvero dentro un PDF. Ogni sviluppatore che ha eseguito il debug di un problema di rendering ha desiderato aprire il file, cambiare un numero in un dizionario e osservare il risultato. In un PDF normale questo è impossibile, perché il contenuto è compresso in object stream e ogni byte inserito sposta degli offset che una tabella di riferimenti incrociati registra in modo esatto
Cosa rende diverso un salvataggio diagnostico?
Sei impostazioni cambiano insieme. Le chiavi dei dizionari vengono scritte in ordine deterministico, così due salvataggi dello stesso documento producono file comparabili. La modalità di output diagnostico annota la struttura. Viene forzata una riscrittura completa, così nulla viene trasportato come revisione incrementale non toccata. La linearizzazione è disattivata, poiché un file linearizzato è organizzato per un visualizzatore web e non per un lettore. I cross-reference stream sono disattivati, quindi la tabella è testo semplice. E gli object stream sono disattivati, quindi nessun oggetto è nascosto dentro un contenitore compresso
Il risultato è un file la cui intestazione porta un marcatore diagnostico accanto alla consueta firma %PDF-, e il cui corpo potete scorrere in qualsiasi editor. Gli oggetti compaiono uno dopo l'altro, i dizionari sono leggibili, e i content stream si trovano dove potete trovarli. Lo strumento di riparazione verifica la presenza di quel marcatore e rifiuta i file che ne sono privi, perché la struttura compatta di un PDF normale non è qualcosa che un riparatore basato su intervalli di byte dovrebbe tentare di interpretare

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Leggibile, un oggetto per blocco, nulla nascosto in object stream
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Perché modificare rompe il file, e cosa va ricostruito?
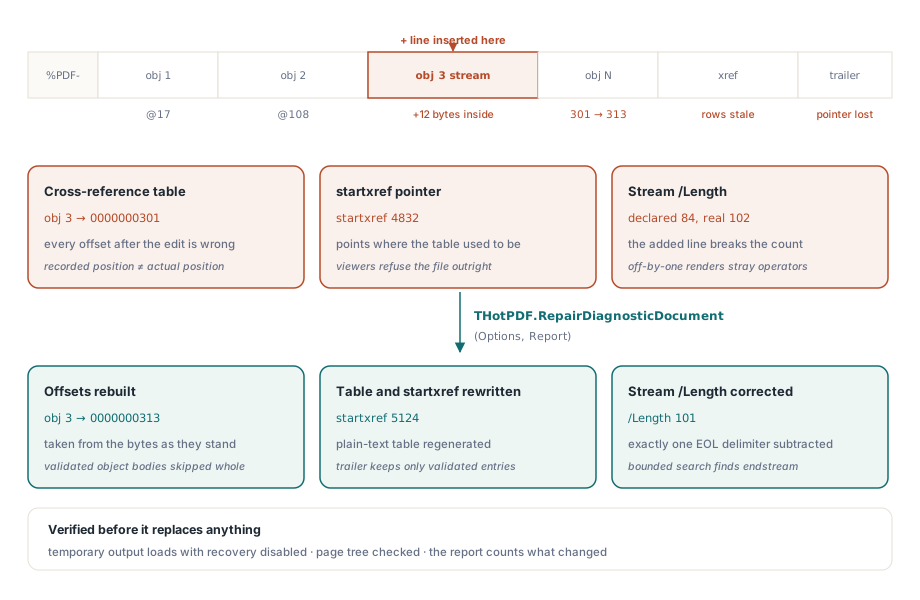
Tre elementi in un PDF codificano posizioni o conteggi di byte. La tabella dei riferimenti incrociati mappa ogni numero di oggetto su un offset di byte. Il valore startxref alla fine del file punta alla tabella. E ogni dizionario di stream porta un /Length che indica quanti byte occupa il corpo dello stream
Cambiate un carattere in qualsiasi punto prima della fine del file e gli offset successivi diventano sbagliati. Aggiungete una riga a un content stream e anche il suo /Length diventa sbagliato. La maggior parte dei visualizzatori rifiuterà il file, e quelli che lo recuperano lo fanno tramite scansione, il che nasconde l'errore invece di correggerlo. La riparazione ricostruisce tutti e tre gli elementi a partire da ciò che i byte dicono realmente ora
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // carica il risultato prima di sostituire

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Copiare i byte, non riserializzare
La decisione di design che rende affidabile questo strumento è che non carica mai il documento per poi riscriverlo. Copia gli intervalli di byte degli oggetti che ha validato, modifica solo i valori /Length che sono sbagliati, e ricostruisce attorno a essi la tabella, il trailer e lo startxref
Caricare e riserializzare sarebbe molto più facile da implementare, ma cambierebbe le cose in modo silenzioso. La sintassi di oggetti sconosciuti verrebbe normalizzata, gli escape delle stringhe verrebbero riscritti nella forma preferita dal writer, e i payload di stream già codificati potrebbero essere ricodificati. Per uno strumento di debug questo è inaccettabile: avete modificato un numero, e il diff dovrebbe mostrare un numero, non mille modifiche di formattazione incidentali. Se volete sapere esattamente cosa è cambiato tra due file, quello è un problema di confronto, trattato in confrontare due file PDF per struttura e pixel

Le due regole di parsing che prevengono oggetti falsi
Uno scanner a intervalli di byte affronta una trappola evidente: testo che assomiglia a un'intestazione di oggetto può comparire dentro il payload di uno stream o dentro una stringa. Una scansione ingenua emetterebbe una riga di riferimento incrociato che punta nel mezzo di un content stream, e il file risultante sarebbe rotto in un modo nuovo e più confuso
HotPDF evita questo problema saltando l'intero intervallo di byte di ogni oggetto validato, usando il suo offset di fine registrato, così nulla all'interno del corpo di un oggetto viene mai considerato un candidato. Tra un oggetto e l'altro sono ammessi solo spazi bianchi e commenti PDF; qualsiasi altra cosa significa che la regione non è compresa e i suoi byte non devono essere trascinati nell'output
Le lunghezze degli stream richiedono altrettanta cura. La lunghezza reale del payload esclude il delimitatore di fine riga che un writer inserisce prima di endstream. Quando la lunghezza dichiarata cade esattamente sul marcatore, tale dichiarazione viene accettata. Quando non è così, il riparatore esegue una ricerca limitata della coppia endstream ed endobj e sottrae esattamente un delimitatore, un CR, un LF o un CRLF. Sbagliare questo calcolo anche di un solo byte produce un file che si apre e renderizza una pagina con un operatore vagante alla fine del suo content stream
Cosa può conservare il trailer
Il trailer ricostruito non è una copia di quello vecchio. /Size, /Prev e /XRefStm descrivono tutti il precedente layout del file e vengono ricalcolati o eliminati. Sopravvivono solo le voci le cui destinazioni sono state validate: /Info, /ID ed /Encrypt. E /Root deve risolversi in esattamente un oggetto Catalog — non zero, e non diversi, cosa che tende a prodursi in un file assemblato incollando blocchi di oggetti
La sicurezza dell'output viene gestita come dovrebbe esserlo per uno strumento che opera su file a cui le persone tengono. Il risultato viene scritto in un file temporaneo nella directory di destinazione, poi verificato caricandolo attraverso il percorso normale con il recupero dei riferimenti incrociati disattivato, così un file che si apre solo grazie al recupero conta come un fallimento. Solo dopo che l'albero delle pagine viene verificato, il file temporaneo sostituisce in modo atomico la destinazione. Una riparazione fallita non sovrascrive mai un output esistente
Budget e codici di fallimento onesti
Tre limiti delimitano il lavoro: i byte di input, il conteggio degli oggetti candidati e il numero massimo di oggetto, predefiniti rispettivamente a 8 GiB, due milioni e due milioni. Il limite sul numero di oggetto conta più di quanto sembri, perché una tabella sparsa con pochi oggetti numerati nell'ordine dei miliardi gonfierebbe altrimenti enormemente la tabella dei riferimenti incrociati ricostruita. Anche le tabelle di riferimenti incrociati classiche rifiutano offset che richiederebbero più di dieci cifre decimali, il che è un limite del formato e non una scelta implementativa
I fallimenti restituiscono uno stato specifico anziché un booleano: argomenti non validi, sorgente troppo grande, non è un file diagnostico, limite oggetti superato, oggetto non valido, oggetto duplicato, catalogo mancante, trailer non valido, errore di output oppure validazione fallita. Ciascuno corrisponde a una correzione diversa. Un oggetto duplicato significa che avete incollato due volte un blocco di oggetto. Un catalogo mancante di solito significa che l'oggetto che contiene /Type /Catalog era danneggiato. Validazione fallita significa che la struttura è ora coerente ma l'albero delle pagine non si carica, il che tipicamente è un array /Kids modificato senza allinearlo al suo /Count
Due note pratiche chiudono il cerchio. Conservate il file diagnostico, non solo quello riparato, così la modifica successiva parte da una base leggibile. E non distribuite l'output diagnostico agli utenti finali: è più grande di un salvataggio normale perché nulla è compresso in object stream, e il percorso di produzione per un file compatto è il normale percorso di salvataggio descritto in object stream e aggiornamenti incrementali. Quando l'obiettivo è trovare cosa non va anziché modificarlo, il percorso automatizzato in automazione dei report di preflight risponde più velocemente della lettura dei byte
Il salvataggio diagnostico, la riparazione, il preflight e il confronto operano tutti sullo stesso modello di documento caricato in Delphi e C++Builder; l'elenco completo delle funzionalità è disponibile sulla pagina del componente PDF HotPDF Delphi