Apri un PDF prodotto da Microsoft Word o Excel, scorri le pagine e nulla sembra insolito. Caricalo in un programma Delphi, leggi il conteggio delle pagine e il numero è corretto. Poi risalvalo con la crittografia attivata e il passo di salvataggio lancia un'eccezione, oppure l'output si apre con un avviso di riferimenti incrociati danneggiati. Il file non è mai stato corrotto. È un file con riferimenti ibridi, e la struttura stessa che consente a un visualizzatore di quindici anni fa di aprirlo è la struttura che sconfigge un caricatore che smette di leggere troppo presto
Questo è uno dei modi più comuni in cui una pipeline PDF che ha superato ogni test interno incontra un file che non può gestire in un ciclo completo. Gli input sono stati tutti generati internamente, quindi non sono mai stati ibridi. Il primo file ibrido arriva il giorno in cui un cliente inoltra una fattura esportata da un foglio di calcolo
Cosa scrivono effettivamente Word ed Excel
ISO 32000-1 descrive il layout a riferimenti ibridi nel §7.5.8.4. Un'applicazione che desidera le funzionalità di PDF 1.5 come gli stream di oggetti, pur permettendo a un lettore PDF 1.4 di aprire il file, scrive le informazioni dei riferimenti incrociati due volte. C'è una tabella classica dei riferimenti incrociati, le righe ASCII a larghezza fissa che terminavano ogni PDF fino alla versione 1.4, e c'è uno stream di riferimenti incrociati che indicizza il resto. Il trailer della sezione classica contiene una voce /XRefStm il cui valore è l'offset in byte di quello stream
La divisione del lavoro è deliberata. Gli oggetti che un vecchio lettore deve raggiungere, tra cui il catalogo e l'albero delle pagine, sono indirizzabili dalla tabella classica. Gli oggetti che sono stati raggruppati in stream di oggetti compressi sono contrassegnati come liberi nella tabella classica, con una voce di tipo f, in modo che un lettore 1.4 li salti a piè pari e non inciampi mai in una struttura che non può analizzare. Le loro posizioni reali risiedono solo nello stream dei riferimenti incrociati. La firma di un file del genere è la sua coda: una breve sezione classica che copre solo gli oggetti di cui un lettore legacy ha bisogno, il cui trailer punta al /XRefStm in cui risiedono i dati di recupero effettivi
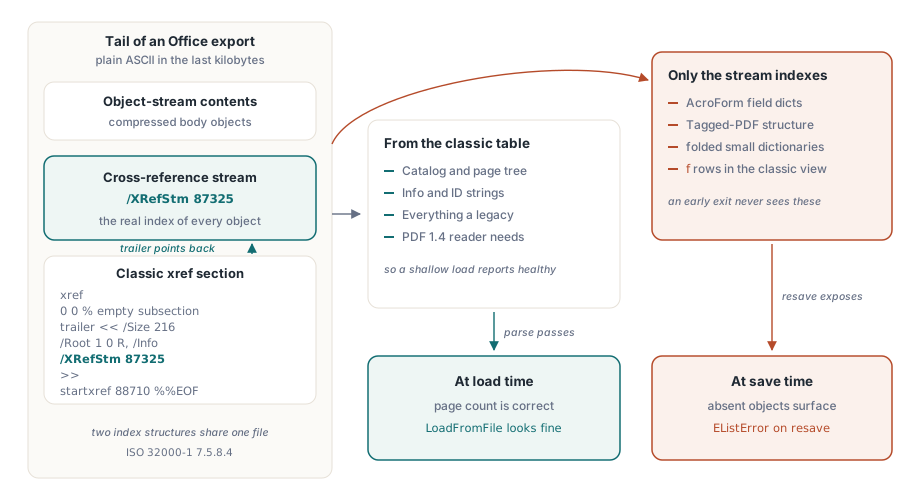
/XRefStm del suo trailer porta allo stream che custodisce il resto dell'indice degli oggettiPerché un conteggio delle pagine corretto non prova nulla
Poiché il catalogo e l'albero delle pagine sono raggiungibili di proposito dalla tabella classica, un caricatore che legge solo quella tabella trova /Root, percorre l'albero delle pagine e riporta il numero corretto di pagine. Tutto ciò di cui un vecchio lettore ha bisogno è presente, quindi il file appare sano. Gli oggetti andati perduti sono quelli raggruppati negli stream di oggetti: i dizionari dei campi AcroForm, gli elementi della struttura dei PDF taggati, la lunga serie di piccoli dizionari che non hanno mai dovuto essere visibili a un visualizzatore obsoleto
Non noti la lacuna finché qualcosa non tocca quegli oggetti, e un salvataggio completo li tocca tutti. Percorrere il documento per crittografarlo nuovamente o riscriverlo è esattamente l'operazione che richiede ogni numero di oggetto a sua volta, motivo per cui il sintomo affiora al momento del salvataggio piuttosto che al caricamento, lontano dalla sua causa
La trappola è un rilevatore che vede xref e si ferma
Il modo economico per decidere come è indicizzato un file è seguire startxref e ispezionare i primi byte a cui punta. La parola chiave xref significa una tabella classica; un oggetto stream significa uno stream di riferimenti incrociati. Quel test è corretto per qualsiasi file che si affidi a un solo schema. È sbagliato per un file ibrido, il cui startxref mira a una sezione classica al solo scopo di soddisfare i vecchi lettori, mentre il /XRefStm nel trailer di quella sezione è il punto in cui la maggior parte del documento è effettivamente indicizzata. Un rilevatore che restituisce "classico" al primo xref che incontra non legge mai /XRefStm e ogni oggetto che risiede solo nello stream diventa invisibile
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // le pagine sono raggiungibili dalla tabella classica
    // ispeziona o modifica qui il documento caricato
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // serve ogni oggetto, anche quelli solo negli stream
  finally
    Pdf.Free;
  end;
end;
Eseguite quella sequenza su un caricatore costruito attorno al rilevatore ad uscita anticipata e il caricamento sembra corretto; il risalvataggio è dove gli oggetti assenti si manifestano. La correzione non sta nel leggere più byte all'inizio; sta nel riconoscere il trailer ibrido e seguire /XRefStm prima di decidere che il file è finito
L'ordine di unione non è negoziabile
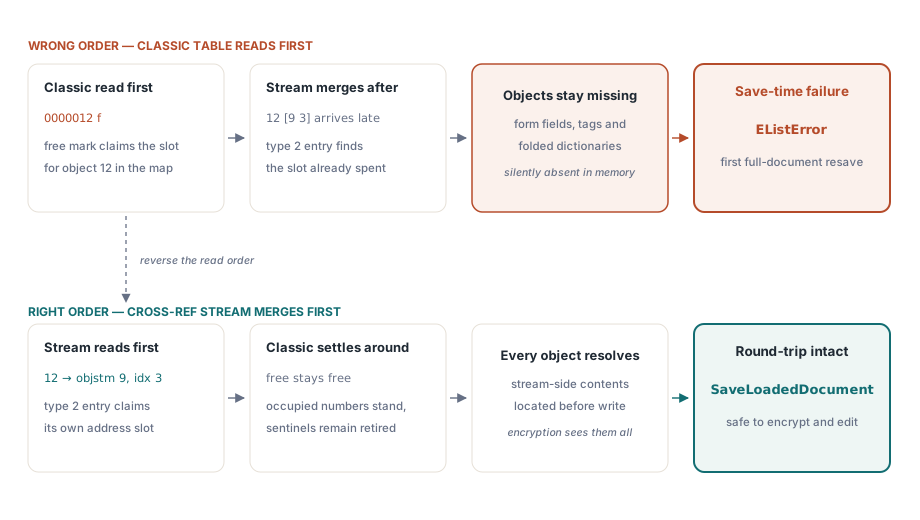
Una volta che entrambi gli indici sono stati letti, possono essere combinati solo in una direzione. Lo stream dei riferimenti incrociati deve essere unito per primo, con le voci classiche riempite attorno a esso. La ragione è il piccolo inganno al centro del formato. Un file ibrido contrassegna i suoi oggetti compressi come liberi nella tabella classica in modo che i vecchi lettori li ignorino. Un caricatore che onora una politica del tipo 'il primo visto vince' e legge per prima la tabella classica registrerà quei numeri di oggetto come liberi, poi scarterà le voci dello stream che effettivamente li localizzano, perché gli slot sono già occupati. Inverti l'ordine e le voci di tipo 2 dallo stream, ciascuna con un numero di stream di oggetti più un indice, conquistano gli slot che sono destinate a possedere, e le voci classiche si sistemano intorno a loro
La stessa disciplina evita che una revisione più vecchia resusciti un oggetto eliminato. Gli aggiornamenti incrementali si concatenano all'indietro attraverso /Prev e una voce libera di tipo 0 è una sentinella che indica che una sezione più recente ha ritirato un numero di oggetto. Non si deve permettere a una sezione successiva, ma cronologicamente più vecchia nella catena, di sovrascrivere quella sentinella con una posizione non più valida. Considera il 'primo visto' come autorevole per i marcatori liberi e l'oggetto cancellato rimarrà cancellato; trattalo con noncuranza e la storia stessa del file rianimerà i contenuti che l'ultima revisione aveva rimosso
Come le due viste divergono
Tutto questo presuppone che i due indici siano d'accordo. Appena uscito da Word, lo sono: ogni vista descrive lo stesso documento entro lo scope che dichiara. I guai iniziano quando il file passa attraverso uno strumento che ne capisce solo una. Le utility di timbratura sono i soliti sospettati. Una accoda un aggiornamento incrementale in stile classico con alcuni oggetti nuovi, una nuova sezione xref, un collegamento /Prev alla sezione precedente, e un trailer fresco. Se quel trailer butta via /XRefStm, la vista dello stream resta orfana. Se copia in avanti il vecchio valore, la vista dello stream descrive ancora il documento com'era prima che il timbro venisse applicato. In entrambi i casi, ora gli indici sono in disaccordo
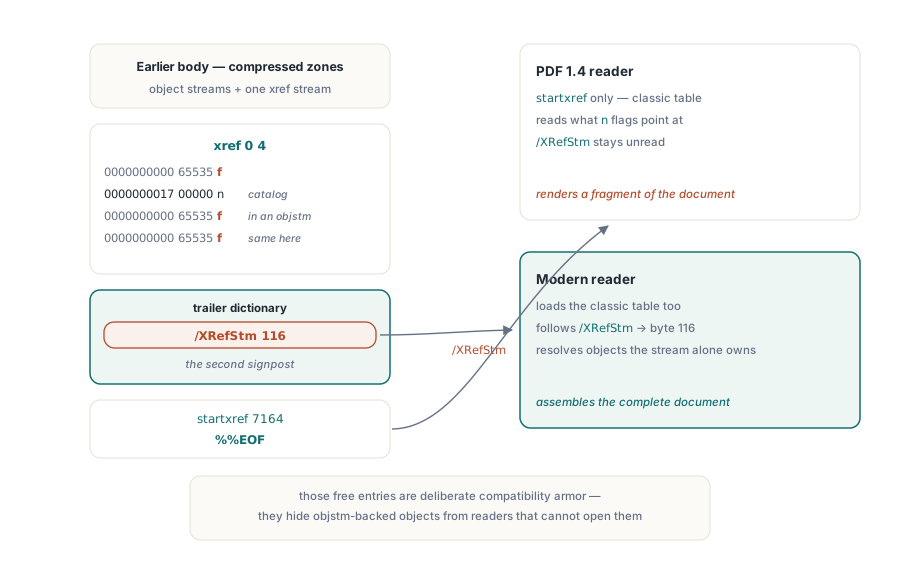
La firma è facile da riconoscere una volta che la conosci. Gli oggetti visibili attraverso una vista mancano o sono obsoleti nell'altra. Un lettore che risolve attraverso lo stream trova la versione pre-modifica di un oggetto aggiornato, o nessuna voce per uno aggiunto. Un lettore che si fida solo della tabella vede la modifica ma perde ogni oggetto compresso che solo lo stream poteva localizzare. Gli utenti lo descrivono come campi modulo che compaiono in un viewer e spariscono in un altro, annotazioni che il passaggio di timbratura sembra aver cancellato, o ricerche che atterrano su un oggetto completamente sbagliato
Adobe Acrobat è ciò che rende questi file così costosi da rincorrere. Quando l'indice dichiarato non è d'accordo con i byte, Acrobat di solito ricostruisce di nascosto i dati dei riferimenti incrociati scansionando gli header degli oggetti, così chi ha prodotto il file rotto lo apre, non vede niente di sbagliato, e lo rimanda avanti. Il fallimento affiora più tardi e altrove — un validator di preflight, un servizio di firma, un job di ingest archivistico — qualsiasi consumatore che si fida della struttura dichiarata e riporta oggetti mancanti o un disallineamento dei riferimenti incrociati. «Si apre benissimo in Acrobat» è così che inizia quasi ogni ticket di desincronizzazione ibrida
Cosa significa questo in HotPDF
Il motore risolve per voi i file a riferimenti ibridi, e lo fa su ogni percorso che deve analizzare i dati dei riferimenti incrociati. Caricate un documento con LoadFromFile o LoadFromStream, apportate le modifiche, e chiamate SaveLoadedDocument; oppure eseguite un'operazione singola come EncryptFile che legge un input e scrive un output. In entrambi i casi il recupero legge /XRefStm, unisce la sezione dello stream prima delle voci classiche, e risolve gli oggetti che risiedono negli stream prima che la scrittura li enumeri. Il percorso di crittografia AES-256 è dove questo conta in modo più visibile, perché crittografare un documento riscrive ogni oggetto e pretende quindi che ogni oggetto sia già stato localizzato
// Operazione singola: leggi l'input ibrido, scrivi una copia crittografata AES-256
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
Il dettaglio che vale la pena di portare con sé si trova a monte dell'API. I file che arrivano da Word, Excel, PowerPoint e da una lunga serie di pipeline "Salva come PDF" sono regolarmente ibridi, quindi un caricatore che eserciti solo contro l'output del tuo generatore potrebbe non incontrarne mai uno nei test. Popola i tuoi set di test con documenti esportati da applicazioni Office reali, non solo con file prodotti dal tuo stesso codice
Controllare un file sospetto
Due ispezioni risolvono rapidamente la questione. Apri il file in una vista esadecimale e leggi i byte dopo l'ultimo startxref; un file ibrido mostra una breve sezione classica il cui dizionario trailer contiene /XRefStm. Oppure confronta il conteggio degli oggetti riportato da un'analisi completa con il numero di oggetto più alto che /Size dichiara nel trailer. Una grande lacuna significa che gli oggetti sono nascosti in stream che il caricatore non ha aperto, il che è lo stesso ammanco che si trasforma in un fallimento al momento del salvataggio in seguito
La coda di un tipico export di Excel rende concreto il primo controllo. Tutto ciò che si trova dopo l'ultima parola chiave xref è in puro ASCII, quindi la firma è leggibile direttamente da una vista esadecimale (offset puramente indicativi, annotazioni aggiunte)
xref
0 16                         % oggetti 0-15: ciò che serve a un lettore legacy
0000000000 65535 f
0000000017 00000 n
...                          % altre 14 righe; il resto vive negli object stream
trailer
<< /Size 216                 % uno oltre al numero di oggetto più alto in uso
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % offset in byte dello stream dei riferimenti incrociati
>>
startxref
88710                        % punta alla sezione classica soprastante
%%EOF
La chiave /XRefStm nel trailer è l'indizio. La sezione classica qui sopra elenca 16 dei 216 numeri di oggetto che il file usa; tutto ciò che è impacchettato negli object stream manca da essa oppure è marcato libero. Un rilevatore che si ferma alla parola chiave xref ha, a questo punto, visto solo quell'indice parziale. Quando preferite scrivere uno script per il controllo piuttosto che farlo a occhio, il marcatore si trova entro gli ultimi due kilobyte del file, quindi una lettura a ritroso limitata è sufficiente. Se il file è stato poi aggiornato in modo incrementale, la coda contiene più di un trailer, e quello che conta è l'ultimo
// Restituisce l'offset di /XRefStm dal trailer più recente nella coda del file,
// o -1 se il marcatore è assente (il file non è ibrido, o non è affatto un PDF)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P, Q: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // il trailer risiede nella coda
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // lettura a ritroso limitata: 2 KB max
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := 0;                               // conserva l'ultimo marcatore: gli aggiornamenti
  Q := Pos(AnsiString('/XRefStm'), Tail); // incrementali accodano trailer più nuovi
  while Q > 0 do
  begin
    P := Q;
    Q := Pos(AnsiString('/XRefStm'), Tail, P + 1);
  end;
  if P = 0 then
    Exit;                               // nessun marcatore ibrido nella coda
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // salta gli spazi bianchi dopo la chiave
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Utilizzo: un risultato non negativo indica il byte da cui inizia lo stream
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Trattate la sonda come un triage, non come un parser: vi dice quali file in un batch meritano attenzione prima che un job di risalvataggio giri, e nient'altro
Puntatela su una cartella di input reali e i file si dividono in tre gruppi. Un file solo-classico ha una parola chiave trailer nella coda ma niente /XRefStm, quindi la sonda restituisce -1. Un file che punta interamente sugli stream di riferimenti incrociati restituisce pure -1, correttamente: non ha affatto una parola chiave trailer, perché le sue chiavi di trailer vivono nel dizionario dello stream. Solo il layout a doppio indice restituisce un offset. Se il vostro report di triage deve distinguere i primi due gruppi, cercate trailer nella stessa coda prima di scartarla; una chiamata Pos in più basta
Prima che la sonda giri senza supervisione, irrobustitela in due punti. Un offset è solo un'affermazione. Posizionatevi lì e confermate che un oggetto il cui dizionario dice /Type /XRef stia davvero in quel punto, perché un file danneggiato o troncato può ancora portare la chiave mentre lo stream che nomina è sparito. Quel file appartiene a un bucket diverso da un ibrido sano. Il controllo sono poche righe sopra la stessa gestione dei file
// Offset è il valore restituito da FindXRefStm; FS è un TFileStream aperto
// allo stesso modo, Head un AnsiString (Min viene da System.Math)
if Offset >= FS.Size then
  Exit(False);                          // la chiave è sopravvissuta, lo stream no
FS.Position := Offset;
SetLength(Head, Integer(Min(Int64(512), FS.Size - Offset)));
FS.ReadBuffer(Head[1], Length(Head));
Result := (Pos(AnsiString('/Type /XRef'), Head) > 0) or
  (Pos(AnsiString('/Type/XRef'), Head) > 0);  // la sintassi PDF consente entrambe le grafie
Poi rendete la finestra di 2 KB un parametro. Due kilobyte coprono l'output ordinario di Office, ma un dizionario trailer insolitamente grande può spingere il marcatore fuori portata, e allargare la finestra batte dichiarare il file classico per sbaglio
Instradare i file ibridi attraverso una pipeline
Il rilevamento ripaga quando cambia la destinazione successiva di un file. Quale sia dipende da ciò che la pipeline sta per farne
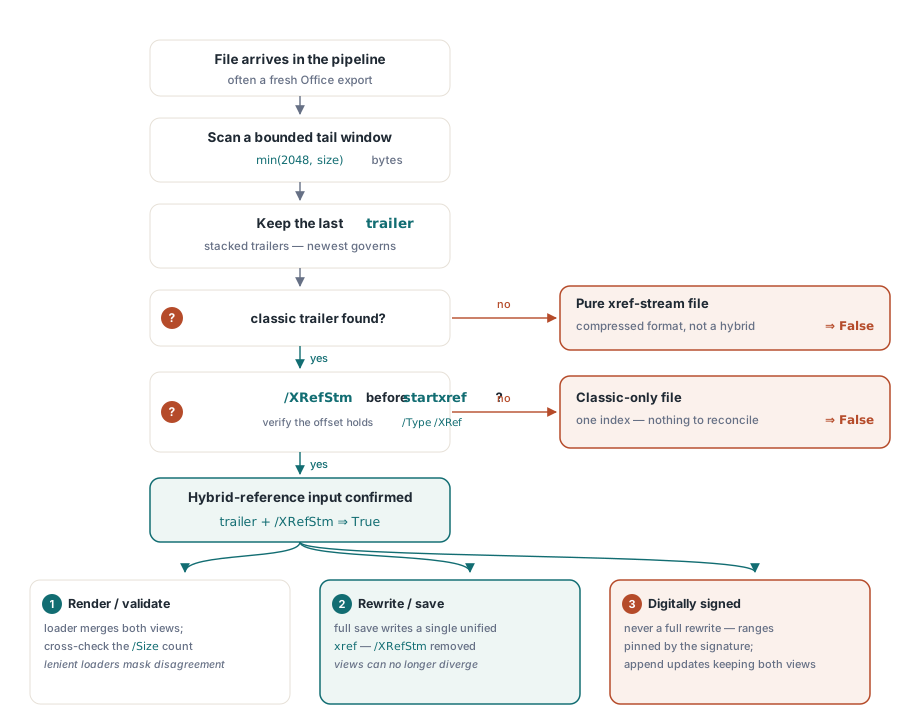
I file che vengono solo letti, renderizzati o validati dovrebbero andare a un caricatore che risolve entrambe le viste. Il PDFium Component analizza la catena /XRefStm durante il caricamento, quindi la tabella degli oggetti che il vostro codice vede è già quella fusa, e i controlli del nostro articolo sulla validazione di object stream e cross-reference stream valgono immutati. Quando un ibrido desincronizzato è danneggiato abbastanza da rifiutare il caricamento, il motore lo segnala attraverso il proprio codice di errore di load, e FPDF_ERR_FORMAT è quello che il danno strutturale produce. Un caricamento pulito è una prova più debole. PDFium è tollerante per design e ricostruisce senza commenti la maggior parte dei file incoerenti, quindi il successo dimostra che il file era recuperabile e non dice nulla sul fatto che le sue due viste siano d'accordo. Per quella domanda, tornate a confrontare ciò che una percorrenza completa degli oggetti trova con il /Size del trailer
I file che la pipeline modifica sono un'altra storia. La nostra preferenza qui è secca: far smettere del tutto di essere ibridi. Caricate il documento con HotPDF e salvatelo per intero, e l'output porta un unico cross-reference autoconsistente in una sola forma. Niente /XRefStm, niente seconda vista su cui divergere, ogni oggetto posseduto da esattamente una voce di indice. Quella normalizzazione è ciò che volete prima di un ingest archivistico, prima di un RIP a valle severo o di un servizio di firma, e dopo qualsiasi modifica applicata a un input ibrido. Poggia interamente sul merge stream-prima descritto in precedenza, dato che un salvataggio completo può scrivere solo gli oggetti che il caricamento è riuscito a localizzare
I documenti firmati sono l'eccezione. Una riscrittura completa sposta ogni byte, il che invalida qualsiasi firma calcolata sugli intervalli di byte originali. Una modifica a un ibrido firmato deve entrare come un vero aggiornamento incrementale che tiene entrambe le viste allineate, e un file firmato che deve solo essere letto dovrebbe attraversare la pipeline intoccato
Il lato dello scrittore di questa storia, ovvero come gli stream di oggetti e i riferimenti incrociati compressi vengono prodotti in primo luogo, è trattato nel nostro articolo sugli stream di oggetti e gli aggiornamenti incrementali. Quando il file ibrido in questione è anche molto grande, le tecniche di caricamento nella panoramica della Direct File API per i flussi di lavoro PDF di grandi dimensioni ti permettono di ispezionarlo senza leggere l'intero file in memoria. Entrambe si abbinano in modo naturale al ripristino descritto qui, che viene fornito come parte del Componente HotPDF per Delphi e C++Builder insieme alle API di caricamento, modifica, crittografia e firma trattate altrove in questo blog