"value":-.25 è ciò che produce uno writer JSON quando copia un token numerico PDF perfettamente legale così com'è, e un parser RFC 8259 severo si arrende nel punto subito dopo il segno meno. I suoi vicini +1.5 e 007.5 dallo stesso array PDF falliscono allo stesso modo. Trasformare i numeri PDF in JSON significa riscrivere ogni token cifra per cifra, scrivere null per NaN e Infinity, e tenere la virgola decimale regionale fuori dall'output
Quattro grafie che PDF accetta e JSON rifiuta
Le due grammatiche sono in disaccordo su quattro piccoli dettagli. ISO 32000-1 §7.3.3 lascia che un numero cominci con un segno più, ometta la parte intera (.5), finisca su un punto nudo (4.) e porti zeri in testa (007.5). RFC 8259 §6 non ammette nulla di tutto questo. Un numero JSON ha un meno opzionale, una parte intera che è o 0 o comincia con una cifra da 1 a 9, e almeno una cifra dopo qualunque punto decimale. I producer hanno diritto alle forme PDF, e i generatori che stampano i numeri con il loro codice di formattazione, insieme ai file che qualcuno ha sistemato a mano in un editor di testo, le usano
La collisione si fa più tagliente in una libreria che rispetta il testo sorgente. PDF Library for Delphi (PDFlibPas) conserva i caratteri esatti che ha parsato per ogni numero reale, così un valore di colore calibrato viene salvato indietro invariato invece di essere arrotondato ai quattro decimali di default; il ragionamento è in preservare la precisione decimale parsata dei PDF. Il tokenizer già sistema .5 in 0.5 e 4. in 4.0 durante la lettura, e gli interi vengono ricostruiti dal loro valore, così +3 torna come 3. Tre grafie raggiungono ancora lo writer alla lettera: un punto iniziale con segno (-.25), un più esplicito su un reale (+1.5) e zeri in testa (007.5)
Uno writer che incolla quei caratteri conservati direttamente nel JSON produce un file che in un editor sembra a posto. Il guaio comincia sulla strada del ritorno. SetObjectJSON restituisce 0, e LastErrorCode riporta PDFLIB_ERROR_OBJECT_JSON_INVALID, che è 105
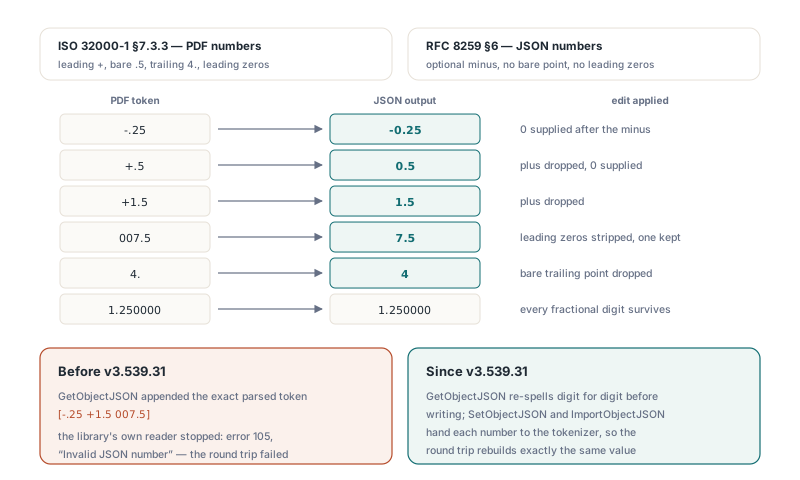
Il round trip qui sotto è il modo più rapido per vedere cosa emette davvero GetObjectJSON. Ogni numero arriva incapsulato come {"type":"number","value":...}, e i tre token scomodi escono come -0.25, 1.5 e 7.5
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  JSON: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('legacy-drawing.pdf', '') = 0 then
      raise Exception.Create('load failed');

    // L'oggetto 12 è un array scritto come [-.25 +1.5 007.5]
    JSON := Lib.GetObjectJSON(12, 0);
    if JSON = '' then
      raise Exception.CreateFmt('export failed, error %d',
        [Lib.LastErrorCode]);
    // Ogni elemento legge {"type":"number","value":-0.25} e così via

    // SetObjectJSON restituisce 1 in caso di successo; passate 0 per Options
    if Lib.SetObjectJSON(12, JSON, 0) = 0 then
      raise Exception.CreateFmt('round trip rejected, error %d',
        [Lib.LastErrorCode]);

    Lib.SaveToFile('legacy-drawing-roundtrip.pdf');
  finally
    Lib.Free;
  end;
end;
Riscrivere il token invece di ricalcolarlo
GetObjectJSON edita i caratteri conservati anziché formattare il Double parsato. Legge un segno opzionale, raccoglie le cifre ai lati di un unico punto decimale, e poi fa solo le modifiche su cui JSON insiste: il più va via, gli zeri in testa vengono ridotti a uno, una parte intera vuota diventa 0, un punto finale nudo viene tolto, e un meno viene rimesso davanti. Un token che contiene qualsiasi altro carattere, o nessuna cifra, viene formattato dal suo valore parsato con dieci decimali invece, e quel percorso scrive null quando il valore non è finito
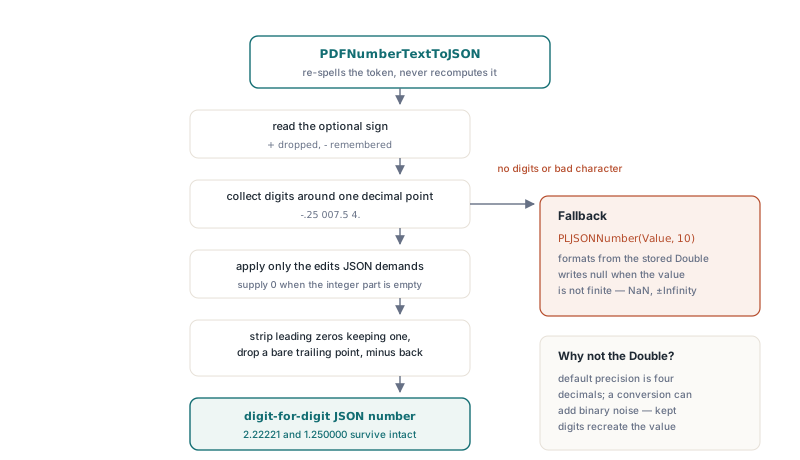
-.25diventa-0.25, e+.5diventa0.5+1.5diventa1.5007.5diventa7.5, mentre0.75resta come è4.diventa4se un tale token arriva mai allo writer2.22221e1.250000conservano ogni cifra frazionaria, zeri finali inclusi
Formattare dal Double sarebbe stata una riga sola, e sarebbe stata sbagliata in due modi. La precisione di output predefinita del documento è di quattro decimali, quindi 2.22221 perderebbe una cifra. Alzare la precisione non la salva neanche: 0.1 non ha forma binaria esatta, e una conversione a 17 cifre significative stampa 0.10000000000000001. Conservare le cifre originali significa che SetObjectJSON e ImportObjectJSON, che riconsegnano ogni numero JSON al tokenizer PDF, ricostruiscono esattamente il valore che il file dichiarava
Quella promessa copre il valore. I byte sono un'altra questione. Dopo un re-import, -.25 viene conservato e salvato come -0.25; entrambe le grafie sono uguali sotto il §7.3.3, eppure un diff a livello di byte segnala la modifica. Su un documento i cui intervalli di byte sono coperti da una firma, non faremmo affatto girare gli oggetti in un ciclo di export e import a meno che il piano non sia firmare di nuovo dopo
Cosa significa null nell'output di GetDocumentJSON?
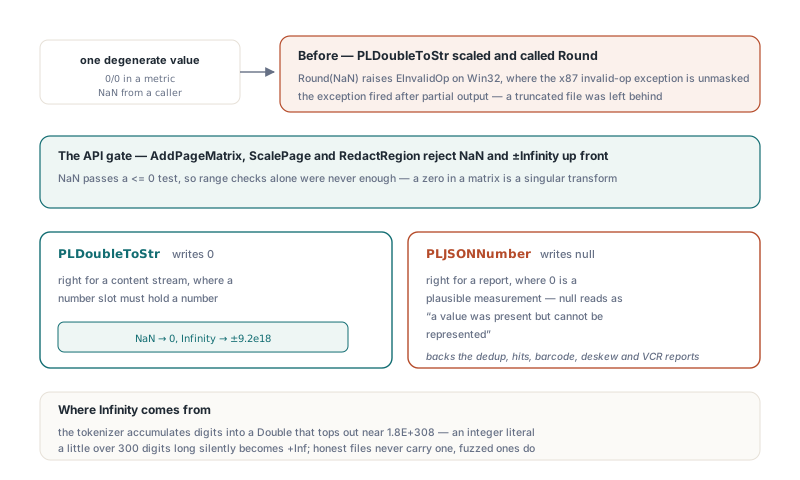
GetDocumentJSON scrive null per qualsiasi numero che sia NaN o infinito, perché RFC 8259 §6 non ha sintassi per nessuno dei due. Infinity è più facile da produrre di quanto suoni. Il tokenizer PDF accumula le cifre per moltiplicazioni ripetute in un Double, che arriva al massimo vicino a 1,8 × 10308, così un letterale intero un po' oltre le 300 cifre si trasforma in +Inf durante il parsing. I producer ordinari non scrivono mai un tale letterale; i file fuzzati e ostili sì, ed è per questo che un intero di 400 cifre appartiene allo stesso corpus di test dei casi in irrobustire un parser PDF Pascal contro file malevoli
Il controllo di finitezza deve venire prima. GetDocumentJSON stampa i valori integrali sotto MaxInt come interi e tutto il resto con lo Str(D:0:6) di Pascal, che va bene per 1,25 ed è fatale per +Inf, perché Str allora scrive il testo +Inf e nessun consumatore JSON parserà quello. La formattazione a sei decimali marca anche a cosa serve il JSON del documento. È una panoramica dell'intero file. Quando vi servono le cifre esatte di un oggetto, chiedete GetObjectJSON per quell'oggetto
Il null è deliberatamente con perdita, e condivide la sua grafia con qualcos'altro. Un oggetto null PDF esce anch'esso come null nel JSON del documento, quindi un consumatore non può distinguere "il file ha detto null" da "il file ha detto un numero troppo grande per un Double" guardando quel solo valore. GetObjectJSON li tiene separati: l'oggetto null PDF viene scritto come {"type":"null"}, e un numero conserva il suo involucro "type":"number". Il codice che legge il JSON del documento dovrebbe accettare null ovunque può apparire un numero, registrare il numero di oggetto, e trattare il file come sospetto invece di sostituirgli uno 0
Perché un singolo NaN può abortire un export SVG o JSON?
Un formattatore di numeri che scala il suo input e chiama Round incontra Round(NaN), e su Win32, dove Delphi lascia l'eccezione invalid-operation x87 smascherata, quello solleva EInvalidOp. L'eccezione scatta dopo che lo writer ha già emesso parte del suo output. Una sola misura degenerata, uno 0/0 dentro una metrica o un NaN passato dentro da un chiamante, lascia sul disco un file troncato
PLDoubleToStr in PDFlibExtra, il formattatore invariante che la libreria usa per gli stream di contenuto, SVG, XML, CSV e la maggior parte del suo JSON, restituisce 0 per NaN. Il suo ramo intero limita il valore scalato a ±9,2 × 10¹⁸ proprio come il ramo frazionario, così anche Infinity esce come letterale finito. In uno stream di contenuto è la chiamata giusta. Uno slot operando deve contenere un numero, e un viewer che incontra +Inf in mezzo a un percorso non ha niente di sensato da disegnare
In un report lo zero è la chiamata sbagliata, e su questa teniamo molto: 0 è un angolo di deskew o un errore pixel perfettamente plausibile, quindi scriverlo per "nessuna risposta" corrompe i dati senza che nessuno se ne accorga. Gli scriventi report usano invece PLJSONNumber(Value, Decimals) dalla stessa unità, che scrive null per NaN o Infinity e cifre invarianti altrimenti. GetSimilarImageDeduplicationReportJSON, GetAnnotationHitsJSON e i report barcode, deskew, structured text e PDF/VCR passano tutti per lì, così un angolo di deskew non finito arriva al consumatore come null
La stessa funzione è pubblica, così il vostro JSON accanto a quello della libreria può seguire la stessa regola. Lo schizzo qui sotto costruisce un piccolo record di skew; la forma del record è nostra, la chiamata di formattazione è della libreria
uses
  SysUtils, PDFlibTypes, PDFlibExtra;

// Scrivente report vostro, che usa la regola dei numeri della libreria
function SkewReportJSON(Page: Integer; Angle, Confidence: Double): string;
var
  B: PLStringBuilder;
begin
  B := PLStringBuilder.Create(128);
  try
    // Trasformate ogni Double in testo prima; PLJSONNumber scrive null
    // per NaN o Infinity e usa sempre un punto decimale
    B.Append('{"page":').Append(Page)
     .Append(',"angle":').Append(string(PLJSONNumber(Angle, 4)))
     .Append(',"confidence":').Append(string(PLJSONNumber(Confidence, 4)))
     .Append('}');
    // Mai B.Append(Angle): su Delphi quell'overload segue la locale utente
    Result := B.ToString;
  finally
    B.Free;
  end;
end;
Dove la locale utente si infila nel JSON
Qualsiasi formattatore che consulta le impostazioni regionali può mettere una virgola dove JSON vuole un punto. PLFloatToStr in PDFlibExtra è un wrapper sottile sopra FloatToStr, ed è esattamente ciò che fa. Scrivete un campo come maxAcceptedMeanError con lui su un desktop tedesco o francese e vi ritrovate "maxAcceptedMeanError":1,5. Un parser JSON legge quello come il valore 1 seguito da un token vagante. Quel campo riporta il peggiore errore pixel accettato dalla deduplicazione percettiva delle immagini, e GetSimilarImageDeduplicationReportJSON lo scrive tramite PLJSONNumber(Stats.MaxAcceptedMeanError, 6), così il separatore resta un punto qualsiasi cosa la macchina abbia impostato
La seconda strada è più silenziosa. Su Delphi, PLStringBuilder è un semplice alias di System.SysUtils.TStringBuilder, il cui overload Append(Double) formatta attraverso la locale utente. Le build Free Pascal usano invece una piccola classe builder Unicode da PDFlibTypes, perché la TStringBuilder propria del runtime FPC è solo ANSI. Compilate la stessa sorgente con entrambi e la build Delphi può essere in disaccordo con la build FPC. Un test che gira solo su Free Pascal, o solo su una macchina en-US, non vedrà la virgola
Il test qui sotto riproduce un desktop con virgola dentro il processo e consegna il report a un parser severo. Scegliete un input che contiene davvero immagini quasi duplicate; senza match l'errore medio è 0, e un valore senza parte frazionaria nasconde il problema del separatore
uses
  System.SysUtils, System.JSON, PDFlibrary;

var
  Lib: TPDFlib;
  Report: WideString;
  Parsed: TJSONValue;
begin
  // Fate comportare questo processo come un desktop tedesco o francese
  FormatSettings.DecimalSeparator := ',';
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('scanned-batch.pdf', '') = 0 then
      raise Exception.Create('load failed');
    // Prova a secco con soglie 2, 2, 4: il documento non viene modificato
    Lib.GetSimilarImageDeduplicationReportJSON(2, 2, 4, Report);
    Parsed := TJSONObject.ParseJSONValue(Report);
    // Questo controllo nil tocca a voi aggiungerlo, non fa parte della libreria
    if Parsed = nil then
      raise Exception.Create('report is not valid JSON on a comma locale');
    Parsed.Free;
  finally
    Lib.Free;
  end;
end;
Tre input che vale la pena tenere nella suite di test
La gestione dei numeri in JSON costa poco da rompere e poco da proteggere. Una pagina che porta -.25, +1.5 e 007.5 copre il divario grammaticale; controllate che l'output di GetObjectJSON parsi e che SetObjectJSON restituisca 1. Un oggetto che tiene un intero di 400 cifre copre l'overflow; il JSON del documento dovrebbe mostrare null in quella posizione. Un report prodotto con DecimalSeparator impostato a virgola copre la locale. Fate girare ciascuno attraverso un parser severo anziché leggere l'output a occhio, perché 1,5 e 1.5 sono facili da perdere in una lunga riga di JSON
Il JSON degli oggetti, il JSON del documento e i report di analisi condividono queste regole sui numeri attraverso le build Delphi, C++Builder e Free Pascal. La pagina del prodotto PDF Library for Delphi elenca le edizioni e il resto dell'API a livello di oggetto e di reportistica