PDF Library for Delphi può unire immagini all'interno di un PDF che appaiono uguali ma non sono identiche byte per byte, tramite DeduplicateSimilarImages. La deduplicazione esatta unisce solo immagini i cui dizionari e payload codificati corrispondono; questa invece confronta come le immagini appaiono realmente, usando un hash percettivo più due soglie di errore sui pixel, e reindirizza ogni riferimento verso un unico oggetto canonico
I file in cui questo ripaga sono quelli cresciuti per caso. Un batch scansionato dove ogni pagina porta lo stesso logo ri-codificato da uno scanner diverso. Un report assemblato da fonti che hanno ciascuna incorporato lo stesso grafico a una qualità JPEG leggermente diversa. Un catalogo le cui miniature sono state rigenerate da due strumenti. In ogni caso il file contiene molte copie di una singola immagine, e la deduplicazione esatta non può toccarne nessuna
Cosa deve significare "abbastanza simile"
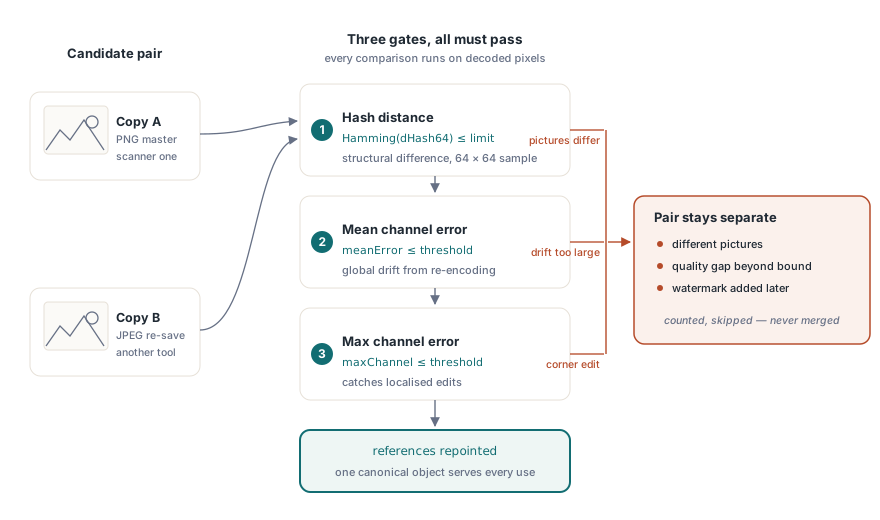
Tre soglie devono essere tutte soddisfatte prima che due immagini vengano unite, e ciascuna cattura un tipo diverso di differenza. La distanza dell'hash percettivo delimita la differenza strutturale: un difference hash a 64 bit viene calcolato da un campione 64 per 64 dell'immagine decodificata, e la distanza di Hamming permessa va da 0 a 7. L'errore medio di canale delimita la deriva complessiva, che è ciò che produce la ri-codifica. L'errore massimo su un singolo canale delimita la differenza localizzata, che è ciò che produce una piccola modifica
Richiedere tutte e tre è ciò che rende difendibile l'unione. Un'immagine che differisce per una filigrana in un angolo ha un errore medio basso e un errore massimo alto, così il gate dell'errore massimo la respinge. Un'immagine che è stata ricompressa ha un errore piccolo ovunque, così passa. È esattamente la distinzione che un ottimizzatore di dimensione deve tracciare
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Distanza hash 2, errore medio 2, errore su singolo canale 4
    // Le opzioni possono richiedere una simulazione a secco così nulla viene modificato
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
L'identità semantica viene prima della somiglianza visiva
Prima che venga confrontato qualsiasi pixel, le immagini candidate devono concordare semanticamente. La libreria costruisce una firma stabile dal dizionario immagine completo escludendo /Length, /Filter e /DecodeParms, così dimensioni, spazio colore, profondità di bit, maschere, l'array /Decode, l'interpolazione, l'appartenenza a contenuto opzionale e i metadati devono tutti corrispondere
Questo ordinamento previene un'intera classe di unioni sbagliate. Due immagini possono apparire identiche in un campione 64 per 64 e comportarsi diversamente sulla pagina: una con /Interpolate vero e una senza verranno smussate diversamente quando scalate, e una appartenente a un gruppo di contenuto opzionale sparirà quando quel livello viene nascosto. Unire attraverso quei confini produce un documento più piccolo e sbagliato
Vengono scansionati solo gli Image XObject indiretti. Le immagini inline sono un costrutto diverso con un'economia diversa, e le immagini che non possono essere decodificate vengono saltate e conteggiate in modo conservativo anziché unite per fede — nessuna prova sui pixel, nessuna unione
Come la ricerca resta economica
Confrontare ogni immagine con ogni altra immagine è quadratico, il che è inaccettabile su un documento contenente migliaia di immagini. L'hash viene quindi suddiviso in otto bande da 8 bit con un indice ordinato su ciascuna
Il principio dei cassetti fa il resto: se due hash differiscono al massimo di 7 bit, devono concordare esattamente su almeno una delle otto bande. Cercare i candidati banda per banda trova quindi ogni corrispondenza ammissibile senza una scansione esaustiva a coppie, e il limite pubblicato di 7 esiste proprio perché la garanzia vale solo fino a quella distanza
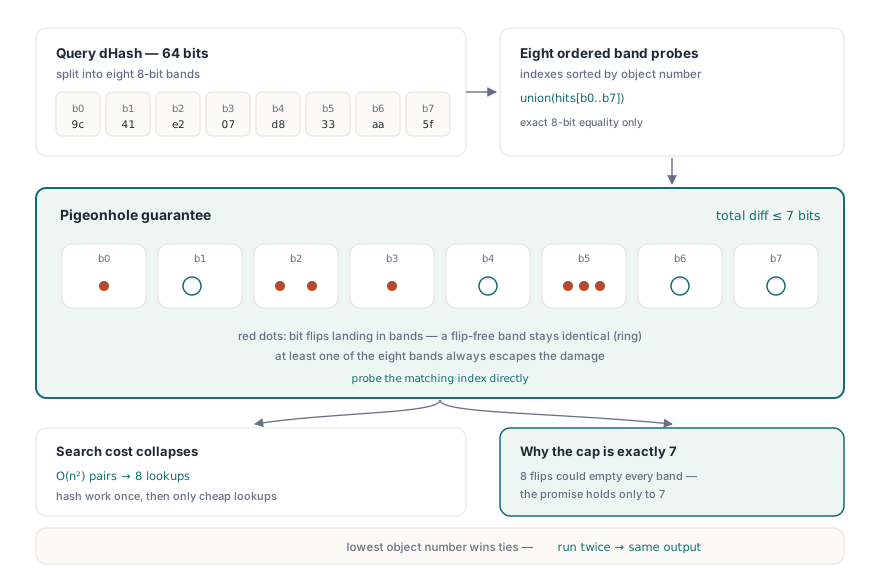
I candidati e le corrispondenze di banda vengono ordinati in modo deterministico per numero di oggetto e generazione, e il numero di oggetto più basso diventa canonico. Questo rende l'output riproducibile: eseguire l'ottimizzatore due volte sullo stesso input produce le stesse scelte canoniche, il che conta quando il risultato viene confrontato o firmato
Simulazioni a secco e report onesti
Poiché questa è un'ottimizzazione lossy nel senso che le immagini unite non erano identiche, il flusso di lavoro sensato è guardare prima di agire. L'opzione di simulazione a secco riporta cosa verrebbe unito e quanto payload verrebbe recuperato senza modificare il grafo degli oggetti, così un job batch può registrare l'effetto e un essere umano può approvare le soglie una volta sola anziché per ogni file
Due note di onestà nella reportistica meritano menzione. La cifra recuperabile stima solo il payload codificato degli stream duplicati; non conta l'overhead di dizionario, oggetto indiretto e riferimenti incrociati, quindi la riduzione effettiva della dimensione del file è leggermente maggiore di quella riportata anziché minore. E il report espone l'errore massimo accettato e il carico di lavoro di confronto, così potete vedere quanto le unioni si siano avvicinate alle vostre soglie
La griglia di campionamento fissa 64 per 64 è un'approssimazione intenzionale, e ha una conseguenza che vale la pena affermare chiaramente: una differenza più piccola di una cella di campionamento può passare inosservata anche a soglia zero. Una singola parola modificata in una pagina scansionata potrebbe non sopravvivere a quel campionamento. Quando è richiesta una prova a livello di byte, usate invece il percorso di deduplicazione esatta — unisce solo risorse genuinamente identiche e non formula alcun giudizio visivo
Dove si colloca in una pipeline di riduzione della dimensione
Ordinate i passaggi per rischio. Eseguite prima la deduplicazione esatta delle risorse, poiché è senza perdita e gratuita. Poi il subsetting dei font, che è anch'esso senza perdita e di solito il singolo guadagno maggiore sui documenti ricchi di testo, come trattato in ottimizzazione della dimensione del file PDF e subsetting dei font. Poi la ricompressione o il sottocampionamento delle immagini se il mezzo di destinazione lo consente. La deduplicazione percettiva va dopo questi passaggi, perché è l'unico i cui risultati dipendono da un giudizio soggettivo
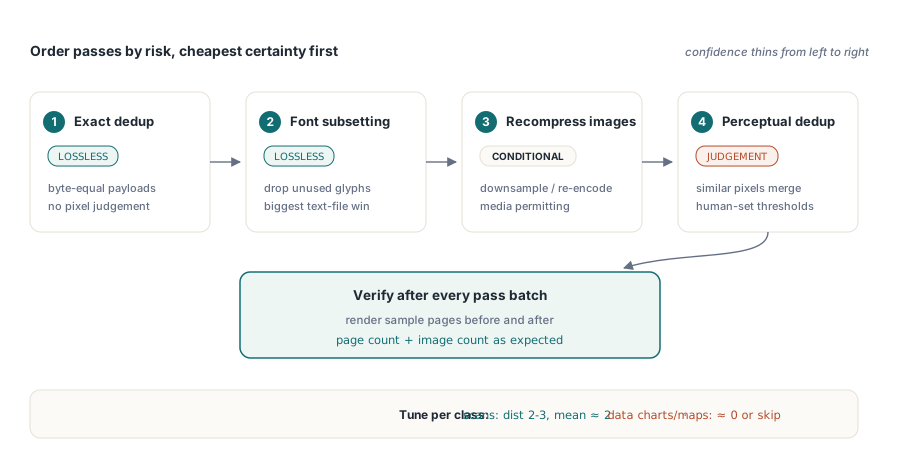
Scegliete le soglie per classe di documento anziché globalmente. Per i batch scansionati dove ogni pagina porta la stessa carta intestata, una distanza hash di 2 o 3 con un errore medio attorno a 2 unisce in modo affidabile la carta intestata. Per i documenti dove le immagini portano dati — grafici, mappe, immagini mediche — usate soglie zero o quasi zero, oppure saltate del tutto il passaggio, perché due grafici che differiscono per un punto tracciato sono due grafici diversi indipendentemente da quanto si somiglino a 64 per 64
Dopo aver ottimizzato, verificate. Renderizzate un campione di pagine prima e dopo e confrontatele, e controllate che il conteggio delle pagine e delle immagini sia cambiato come previsto. Il percorso di ispezione di ciò che un documento contiene realmente è descritto in verificare la dimensione del file PDF per categoria, che è anche il modo più rapido per scoprire se le immagini sono il vostro problema fin dall'inizio
La deduplicazione percettiva, la deduplicazione esatta delle risorse e la verifica della dimensione operano sullo stesso grafo di oggetti per Delphi, C++Builder e Free Pascal; l'elenco completo delle funzionalità è disponibile sulla pagina di PDF Library for Delphi