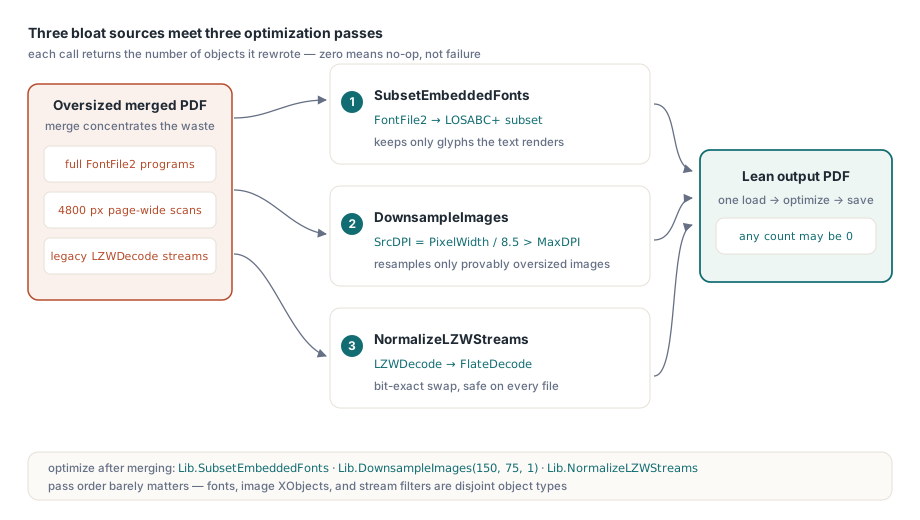
Per ridurre le dimensioni dei file PDF in Delphi, losLab PDF Library mette a disposizione tre API che aggrediscono le tre maggiori fonti di gonfiore: SubsetEmbeddedFonts riscrive ogni programma di font TrueType incorporato riducendolo ai glifi che il documento renderizza davvero, DownsampleImages ricampiona le immagini raster che superano un DPI obiettivo, e NormalizeLZWStreams sostituisce la vecchia compressione LZWDecode con FlateDecode. Ciascuna restituisce il numero di oggetti che ha modificato, quindi uno zero vi dice che il passaggio non ha avuto effetto anziché essere fallito in silenzio
Perché il mio PDF unito è più grande dei file di origine?
Un PDF unito o generato via codice è di solito sovradimensionato per una di tre ragioni: font incorporati per intero, immagini campionate molto al di sopra della loro risoluzione di visualizzazione e stream ancora compressi con il vecchio filtro LZW. ISO 32000-1 §9.9 consente a un produttore di incorporare il programma di font completo, e la maggior parte dei produttori fa esattamente questo perché è l'impostazione sicura. Un FontFile2 Arial completo arriva a centinaia di kilobyte; incorporatelo in una dozzina di file di origine, uniteli, e vi ritroverete a trasportare una dozzina di copie di contorni di glifi per caratteri che nessuno ha mai digitato. L'unione in sé non crea lo spreco, si limita a concentrarlo in un unico file dove il totale diventa finalmente visibile
Le immagini sono il secondo colpevole. Una scansione larga 4800 pixel collocata in un riquadro grande un quarto di pagina trasporta circa 40 volte più dati di pixel di quanti una pipeline di stampa a 300 DPI possa usarne. Il terzo è più discreto: gli stream filtrati con LZWDecode. ISO 32000-1 §7.4.4 specifica sia LZWDecode sia FlateDecode, e osserva che Flate comprime di solito almeno altrettanto bene; nella pratica l'output Flate è costantemente più piccolo sugli stessi dati, e LZW sopravvive soprattutto nei file che a un certo punto della loro storia sono passati per strumenti degli anni Novanta. Il resto di questo articolo percorre i tre passaggi di losLab PDF Library che risolvono ciascun problema, per poi combinarli in un'unica pipeline
Subsetting dei font con SubsetEmbeddedFonts
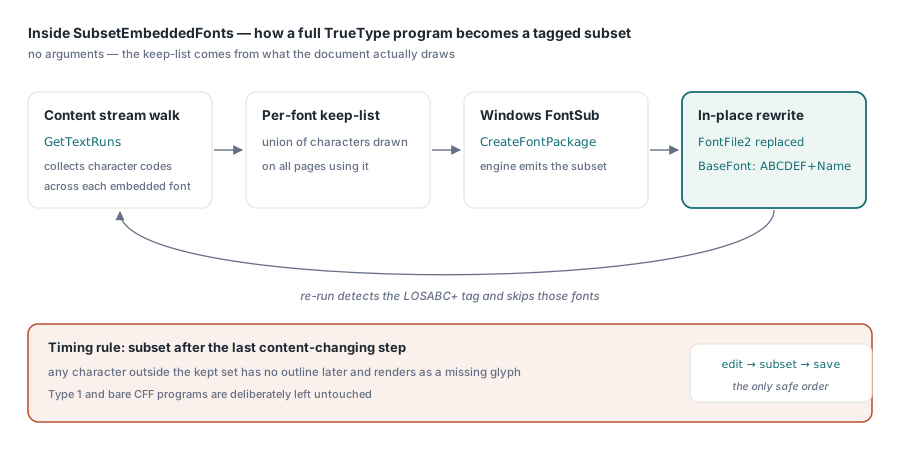
SubsetEmbeddedFonts riduce ogni font TrueType incorporato in un documento caricato ai caratteri che il documento usa davvero, e non ha bisogno di argomenti perché ricava l'elenco dei glifi da conservare dai flussi di contenuto stessi. Internamente il passaggio percorre il flusso di contenuto di ogni pagina con GetTextRuns, raccoglie i codici di carattere referenziati sotto ciascuna risorsa font, costruisce un elenco da conservare e consegna il programma di font originale al motore Windows FontSub (CreateFontPackage) per produrre un subset. Il programma riscritto sostituisce sul posto lo stream FontFile2, e il nome BaseFont acquisisce un tag LOSABC+, la convenzione delle sei lettere maiuscole più il segno che ISO 32000-1 §9.6.4 definisce per i font in subset. Quel prefisso è anche ciò che rende la chiamata idempotente: eseguite il passaggio due volte e i font già in subset vengono riconosciuti e saltati, quindi inserirlo in un job batch che può ripassare sugli stessi file è sicuro
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = numero di programmi FontFile2 riscritti;
      // 0 significa nulla di incorporato, oppure tutto già in subset
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Due dettagli di implementazione vale la pena conoscerli perché spiegano i confini dell'API. Primo, il passaggio prende di mira FontFile2, quindi copre i programmi TrueType incorporati; i font incorporati come Type 1 o come CFF nudo restano intatti anziché essere messi a rischio. Secondo, si appoggia a FontSub, il che rende SubsetEmbeddedFonts disponibile solo su Windows. Un punto più sottile che emerge dall'implementazione: se un font sia idoneo viene deciso risolvendo davvero la catena di riferimenti FontDescriptor → FontFile2, non fidandosi di un flag euristico di incorporamento, perché i font in un documento caricato non sono mai passati per la contabilità lato creazione che imposta quei flag. Se lo stream risolto esiste, il font è un candidato; altrimenti viene saltato senza errore
Il compromesso, detto con onestà: un font in subset contiene solo i glifi presenti al momento del subsetting. Se uno strumento a valle, o il vostro stesso codice, aggiunge in seguito testo con quello stesso font, qualsiasi carattere fuori dal subset non ha alcun contorno e verrà reso come glifo mancante. Fate il subsetting come ultimo passo che modifica il contenuto, mai prima di una fase di editing. La stessa cautela vale se prevedete di estrarre di nuovo il font in seguito per riutilizzarlo; l'articolo su estrazione di testo, immagini e font con PDF Library for Delphi spiega che cosa un programma di font in subset estratto può e non può darvi
Come decide DownsampleImages quali immagini ridurre?
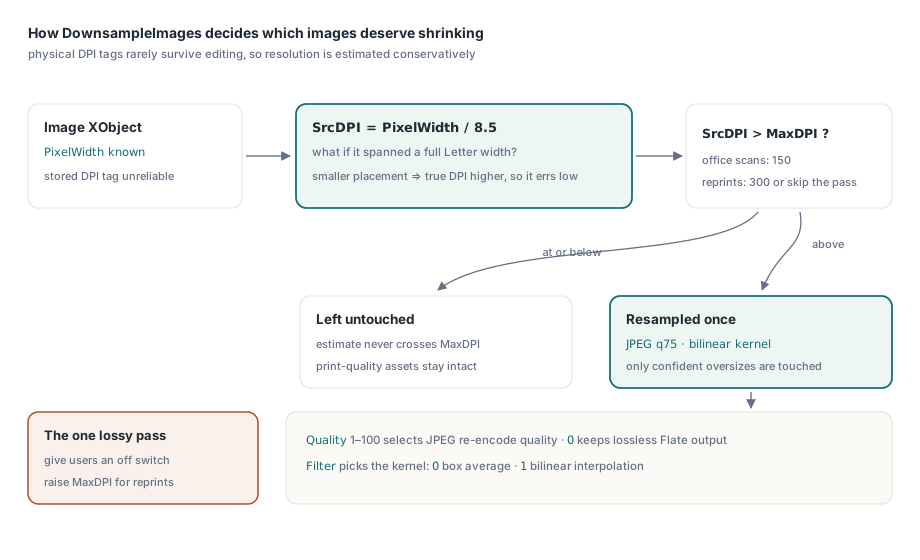
DownsampleImages(MaxDPI, Quality, Filter) ricampiona solo le immagini che può definire con sicurezza sovracampionate, usando una stima del DPI deliberatamente conservativa. Un XObject immagine PDF memorizza le dimensioni in pixel ma nessuna risoluzione fisica affidabile, e un eventuale tag DPI dell'immagine di origine raramente sopravvive a un ciclo di caricamento, modifica e salvataggio. Il passaggio stima quindi SrcDPI = PixelWidth / 8.5, chiedendosi in sostanza: se questa immagine occupasse l'intera larghezza di una pagina Letter, quale sarebbe la sua risoluzione? Vengono toccate solo le immagini la cui stima supera MaxDPI. La distorsione è voluta: un'immagine collocata piccola sulla pagina ha un DPI reale più alto della stima, quindi il passaggio interviene meno del dovuto anziché degradare una risorsa di qualità di stampa che non è in grado di misurare
Quality da 1 a 100 seleziona la qualità di ricodifica JPEG, mentre 0 mantiene l'output come Flate lossless in stile PNG; Filter sceglie il kernel di ricampionamento, 0 per una media a scatola e 1 per il bilineare. Per la documentazione d'ufficio scansionata, DownsampleImages(150, 75, 1) è un punto di partenza ragionevole; per qualunque cosa possa essere ristampata, alzate MaxDPI a 300 oppure saltate del tutto il passaggio. Il downsampling è l'unico passo con perdita dei tre, quindi va messo dietro un'impostazione che i vostri utenti possano disattivare
Convertire i vecchi stream LZW con NormalizeLZWStreams
NormalizeLZWStreams è la vittoria gratuita: decomprime senza perdita ogni stream LZWDecode e lo ricomprime con FlateDecode, sul posto, restituendo il conteggio degli stream convertiti. Gestisce sia una singola voce /Filter /LZWDecode sia la comparsa di LZW dentro un array di catena di filtri, dove viene sostituito solo l'anello LZW e il resto della catena è preservato. I parametri del predictor (Predictor, Columns, Colors, BitsPerComponent) vengono letti dal DecodeParms dello stream e passati al decompressore, così i dati immagine codificati con predictor compiono correttamente il giro completo. Poiché entrambi i filtri sono codec esatti al bit, i byte decodificati sono identici prima e dopo; cambia solo la compressione del contenitore, ed è per questo che questo passaggio si può eseguire senza condizioni su ogni file
Su un documento privo di stream LZW la chiamata restituisce semplicemente 0 e non tocca nulla, cosa che la suite di regressione della libreria esercita esplicitamente: un file appena creato con solo Flate deve riportare zero conversioni. Quella garanzia di non intervento conta quando il passaggio sta in una pipeline che elabora migliaia di file eterogenei, alcuni del 2024 e altri del 1998
La pipeline completa di ottimizzazione delle dimensioni in Delphi
I tre passaggi si combinano in un'unica funzione di caricamento, ottimizzazione e salvataggio, e l'ordine conta meno di quanto potreste pensare perché operano su tipi di oggetto disgiunti: font, XObject immagine e filtri di stream. Eseguire per primo il subsetting resta comunque la scelta ordinata, poiché è il passaggio con un vincolo sull'ordine di editing
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> subset
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilineare
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Registrate Fonts/Images/Streams: tre zeri significano che il file era già snello
  finally
    Lib.Free;
  end;
end;
Verificate la pipeline nel modo in cui la libreria verifica se stessa: con un giro completo. I test di regressione della v3.130 creano un documento, lo salvano, lo ricaricano, eseguono l'ottimizzazione, salvano di nuovo e poi affermano tre cose: che l'output è più piccolo, che i conteggi restituiti corrispondono alle attese e che una ricarica del file ottimizzato si analizza e si renderizza ancora. Riprodurre quel ciclo di creazione, ottimizzazione e ricarica su un campione dei vostri file di produzione, confrontando il testo estratto prima e dopo, è un investimento di un'ora che intercetta gli errori di integrazione molto prima che un cliente apra una fattura rotta
// Controllo di round-trip: il file ottimizzato deve ancora caricarsi senza errori
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Dove si colloca la pipeline in un flusso di lavoro di unione? Dopo l'unione, non durante. Unire prima e ottimizzare il singolo risultato significa che ogni font incorporato viene messo in subset una sola volta rispetto all'unione di tutti i caratteri usati, anziché file di origine per file di origine. Se il collo di bottiglia è la produttività dell'unione, PDF Library for Delphi offre un percorso rapido a livello di byte che evita l'analisi completa degli oggetti, descritto nell'articolo sull'unione veloce di PDF con lo spostamento dei riferimenti di byte; e per input troppo grandi da tenere interamente in memoria, unione e divisione ad accesso diretto per PDF di grandi dimensioni illustra la via in streaming. Entrambi si sposano naturalmente con un passaggio finale di ottimizzazione sull'output unito
Ciò che i tre passaggi non faranno
Il trio di ottimizzazione di losLab PDF Library esclude deliberatamente qualsiasi cosa che cambi la semantica del documento. SubsetEmbeddedFonts non unifica in un solo programma i font duplicati provenienti da sorgenti diverse, riduce ciascuno in modo indipendente; la deduplicazione è una trasformazione differente e più rischiosa. DownsampleImages lascerà passare un'immagine la cui stima conservativa di DPI resta sotto la soglia anche quando una persona capirebbe che è sovradimensionata per il proprio riquadro. E nessuno dei passaggi tocca la struttura del documento, quindi un file gonfiato da migliaia di oggetti orfani ha bisogno di un salvataggio di tipo riscrittura anziché di questi passaggi a livello di stream. Entro quei limiti, la combinazione di subsetting dei font, downsampling delle immagini e normalizzazione da LZW a Flate rimuove le tre classiche fonti di gonfiore dei PDF con una sola chiamata API prevedibile ciascuna. Le tre funzioni fanno parte di losLab PDF Library per Delphi, C# e VB.NET, accanto alle API di unione, estrazione e rendering discusse sopra