Concatenare PDF sembra un'operazione che dovrebbe costare poco. Il contenuto della pagina è già impaginato, i font sono già incorporati, le immagini sono già compresse. In teoria un merge è solo lavoro amministrativo: rinumerare gli oggetti così che gli spazi di numerazione dei due file non vadano in collisione, unire gli alberi delle pagine, sistemare la tabella dei cross-reference e scrivere tutto. In pratica, la maggior parte del codice di merge spreca questa semplicità. Per ogni oggetto di ogni file in ingresso esegue un parse completo in un albero di oggetti tokenizzato, modifica un paio di riferimenti indiretti e poi serializza di nuovo l'albero in byte. Il parse e la riescrittura sono le parti costose e, per la grandissima maggioranza degli oggetti, producono una sequenza di byte quasi identica a quella in ingresso
PDF Library for Delphi è un motore PDF nativo in Object Pascal per Delphi e C++Builder, e il suo percorso di merge veloce esiste per saltare quel viaggio di andata e ritorno ogni volta che è provatamente sicuro. L'idea è circoscritta, ma ripaga su interi insiemi di documenti: per un oggetto non modificato e non stream, prendi i byte sorgente originali così come sono ed esegui una sola riscrittura a livello di byte dei riferimenti indiretti che contengono, trasformando ogni N G R in (N+Offset) G R. Nessun tokenizer, nessun albero di oggetti, nessun serializer. Questo articolo passa in rassegna quando quella scorciatoia è lecita, la macchina a stati del parser che esegue la riscrittura dei byte senza corrompere nulla, perché il merge dei bookmark richiede un meccanismo completamente diverso, e come il percorso di merge ordinario condivide la stessa singola passata lineare
Perché la rinumerazione degli oggetti è il vero costo di un merge
Ogni PDF porta con sé il proprio spazio di numerazione degli oggetti. Il file A ha oggetto 1, oggetto 2 e così via; il file B ha i suoi oggetto 1, oggetto 2 e così via. Non puoi inserire gli oggetti di B nel file di A senza cambiamenti, perché i numeri andrebbero in collisione e ogni riferimento indiretto dentro B finirebbe per risolvere sull'oggetto sbagliato. La soluzione è un offset: se A termina con un conteggio oggetti Offset, allora l'oggetto N diventa l'oggetto N+Offset nell'output, e ogni riferimento N G R che compare in qualunque punto degli oggetti di B deve essere spostato a (N+Offset) G R per corrispondere
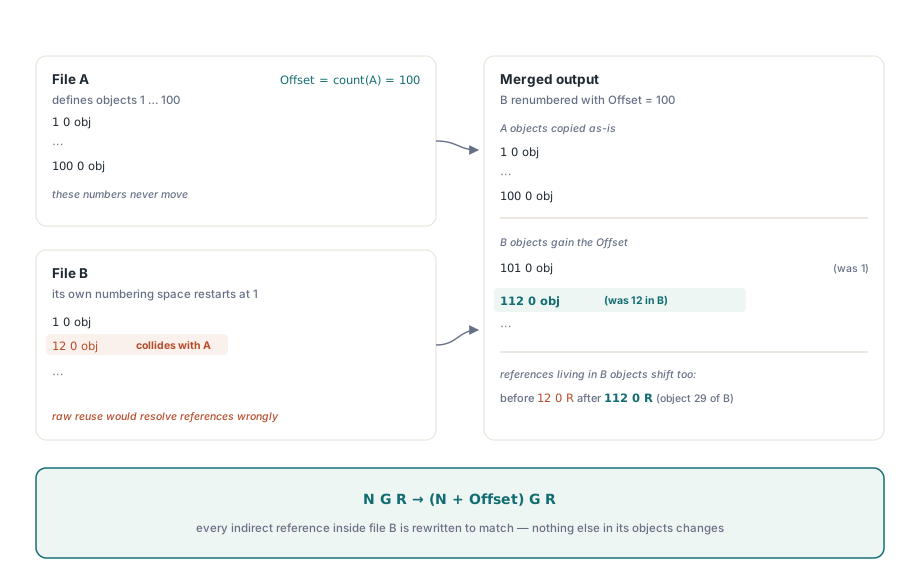
Questo spostamento è l'intero lavoro semantico del merge del corpo del file. Le correzioni dell'albero delle pagine e il merge dell'AcroForm sono piccole modifiche circoscritte a pochi oggetti. Il lavoro pesante è riscrivere i riferimenti attraverso migliaia di oggetti, e il modo ingenuo per farlo è fare il parse di ogni oggetto così da trovare i riferimenti in modo strutturale. MergeFileListFast di PDF Library for Delphi prende la strada opposta: i riferimenti si trovano anche nei byte grezzi, se stai attento ai contesti in cui una sequenza cifra-spazio-cifra-spazio-R non è un riferimento. Salta il parse, sposta in place, e il costo per oggetto crolla a una singola scansione lineare dei byte che avresti comunque dovuto copiare
Quando il riuso dei byte sorgente è provatamente sicuro
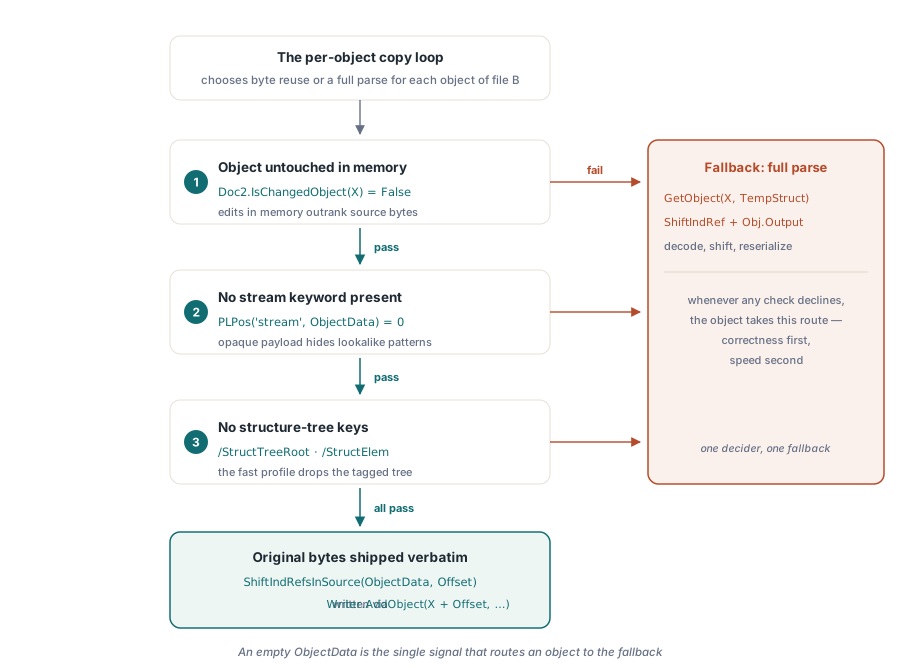
Il percorso a byte viene usato solo quando tutte e tre le condizioni sono vere per l'oggetto che viene copiato da un documento successivo. Se anche una sola fallisce, l'oggetto torna al percorso completo di decode e reserialize, quindi la correttezza prevale sempre sulla velocità:
Doc2.IsChangedObject(X)è False. Se il motore di merge ha già modificato l'oggetto in memoria, per esempio un oggetto pagina il cui/Parentera stato ripuntato, l'albero in memoria è la fonte di verità e i byte originali sono obsoleti. Solo gli oggetti intatti sono idonei- I byte sorgente non contengono
streamla parola chiave. Il corpo di un oggetto stream è racchiuso dastream/endstream, e una scansione ingenua dei dati di stream compressi o cifrati finirebbe per "trovare" e corrompere sequenze di byte che sembrano riferimenti. Gli oggetti stream restano sul percorso originale consapevole degli stream - I byte sorgente non contengono né
/StructTreeRootné/StructElem. Nel profilo veloce l'albero di struttura tagged-PDF viene scartato anziché essere fuso, quindi quegli oggetti devono passare dal percorso di decode, dove il motore può azzerarli deliberatamente
La decisione vive nel ciclo di copia per oggetto. Quando tutti e tre i controlli passano, i byte dell'oggetto vanno direttamente a ShiftIndRefsInSource e poi al writer; altrimenti i byte vengono scartati e l'oggetto viene ricostruito con GetObject, spostato con ShiftIndRef, e serializzato. La struttura di quel ramo vale la pena di essere vista, perché l'ordine dei controlli è ciò che la mantiene sicura:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // ripiega sulla decodifica
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // percorso di parsing completo
  // ... azzera gli oggetti dello struct tree, ShiftIndRef, Obj.Output ...
end;
Un ObjectData vuoto è il segnale che il percorso a byte ha rifiutato l'oggetto. Quel singolo sentinella impedisce che il percorso veloce e quello lento si allontanino: c'è un solo punto che decide e un solo fallback
La macchina a stati per lo spostamento dei riferimenti e i suoi casi limite
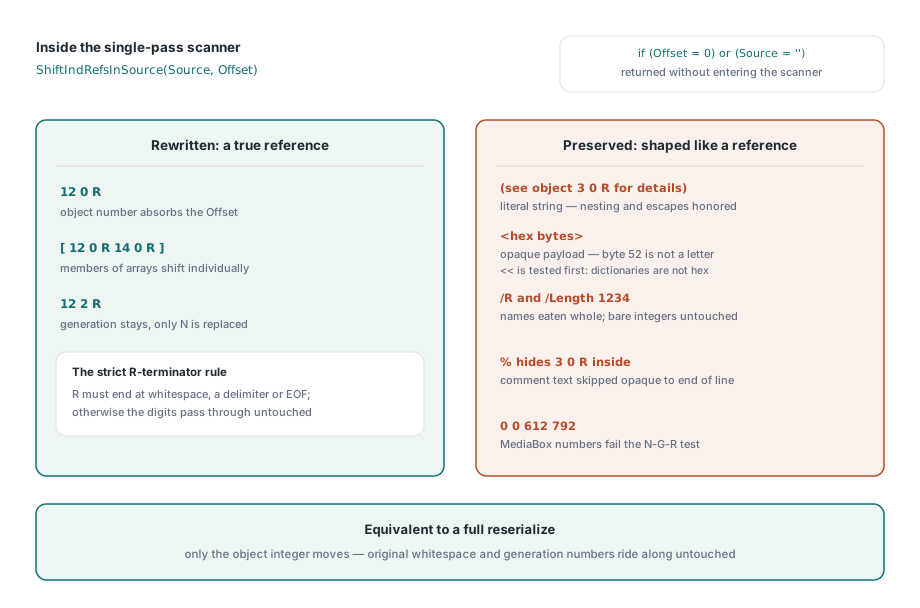
Una riscrittura in byte dei riferimenti indiretti è ingannevolmente facile da sbagliare, perché R e le sequenze di cifre compaiono ovunque in un oggetto PDF in contesti che non sono riferimenti. ShiftIndRefsInSource è uno scanner scritto a mano, piccolo, che attraversa i byte una sola volta e riscrive un numero solo quando è seguito, con whitespace PDF fra i token, da un altro numero e poi da un delimitatore R. I casi di uscita rapida vengono prima: se l'offset è zero o la sorgente è vuota, i byte vengono restituiti intatti senza nemmeno entrare nello scanner
La correttezza dello scanner dipende dal riconoscere i contesti in cui una sequenza che somiglia a un riferimento va lasciata in pace. Sono i confini più facili da perdere, e ciascuno viene gestito in modo esplicito:
- Stringhe letterali delimitate da
(e)vengono copiate alla lettera, tenendo traccia della profondità di annidamento e rispettando l'escape con backslash, così che una parentesi aperta escapata non falsi il conteggio della profondità. Una stringa come(see object 3 0 R for details)contiene un riferimento da manuale che in realtà è solo prosa, e deve sopravvivere byte per byte - Stringhe esadecimali delimitate da
<e>vengono passate attraverso senza interpretazione. I byte52dentro una stringa esadecimale sono il codice ASCII diR, e uno scanner che trattasse il payload esadecimale come testo potrebbe inventare un riferimento fantasma. La<<di apertura di un dizionario viene rilevata per prima, così un dizionario non viene scambiato per una stringa esadecimale - Oggetti nome che iniziano con
/vengono consumati per intero, dallo slash fino al successivo whitespace o delimitatore. Senza questo, un nome come/R(una chiave di risorsa comune) potrebbe essere letto come ilRdi un riferimento - Commenti introdotti da
%proseguono fino a fine riga e vengono saltati come testo opaco - La prova numero-then-R è rigorosa. Un riferimento viene riconosciuto solo come
NwhitespaceGwhitespaceRcon ilRterminato da whitespace, da un delimitatore o dalla fine dell'input. Se il numero di generazione manca, o unRè seguito da una lettera, le cifre vengono emesse invariate. Questo è ciò che protegge l'intero in/Length 1234e i quattro numeri di unMediaBoxdall'essere incrementati senza che nessuno se ne accorga
Il cuore di questo test rigoroso legge quasi esattamente come la frase della specifica:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // numero d'oggetto traslato
  AppendBytes(E1, P - E1);                 // whitespace e generazione originali
  AppendBytes(P, 1);                       // la 'R'
end;
Viene riscritto solo il numero dell'oggetto; il numero di generazione e il whitespace originale esatto fra i token vengono copiati così come sono, quindi l'output è identico in byte all'input salvo per l'unico intero che doveva cambiare. Questa precisione è il punto fondamentale, perché è ciò che rende il riuso dei byte sorgente equivalente a una riserializzazione completa, non solo simile. Se scrivi uno scanner simile per conto tuo, mettilo alla prova con riferimenti nudi, riferimenti dentro array, numeri che non sono riferimenti, stringhe letterali, stringhe esadecimali e numeri di generazione non nulli con offset applicato
Perché i bookmark non potevano riusare AppendOutline
Fondere i bookmark di più documenti in un unico albero outline sembra un lavoro per l'helper AppendOutline esistente, che già sa come innestare i bookmark di primo livello di un documento su quelli di un altro. Qui è lo strumento sbagliato, e la ragione è un disallineamento di livello sottile. AppendOutline individua l'attuale ultimo bookmark di primo livello facendo camminare il reader sui byte originali del file. Ma il merge veloce mette in scena le sue modifiche in un buffer di nuovi oggetti tramite ChangeObject; il reader non vede mai quelle modifiche. Concatena tre o più documenti e ogni append ripunterebbe l'originale ultimo bookmark del primo documento verso il documento più recente, così tutti i bookmark dei documenti intermedi uscirebbero dalla catena — resterebbe corretto solo il /Count cumulativo, il che rende il problema facile da non notare finché qualcuno non apre il pannello dei bookmark
Il percorso veloce lo risolve con un'iniezione in due fasi, guidata dai metadati, che non ricorre mai di nuovo al reader. Una prima passata su tutti gli input raccoglie, per ogni documento, l'oggetto radice dell'outline e i numeri di generazione, i numeri del primo e dell'ultimo bookmark di primo livello e /Count. Da quel riepilogo il codice calcola i numeri globali di oggetto di ogni collegamento che deve forgiare: il /Parent di primo livello di ogni documento verso la radice condivisa, il /Prev del primo bookmark verso l'ultimo del documento precedente, il /Next dell'ultimo bookmark verso il primo del documento successivo, usando pura aritmetica dei numeri di oggetto. Dietro c'è un vincolo di ordine di scrittura: gli oggetti del primo documento vengono scritti prima ancora che si apra un qualunque documento successivo, quindi tutte le modifiche outline del primo documento, sia il /Count sia /Last, e il /Next del vecchio ultimo bookmark, devono poter essere espresse con aritmetica che non richiede in mano alcun documento successivo. Le modifiche di ogni documento seguente vengono applicate in place dopo l'apertura ma prima della scrittura, quindi passano attraverso lo stesso percorso di change-object
L'invariante di allineamento dell'offset che tiene insieme tutto
Sia lo spostamento dei riferimenti sia l'iniezione dei bookmark dipendono da un unico invariante aritmetico, ed è l'assunzione più fragile dell'intero progetto. Un riferimento iniettato in un documento successivo viene scritto come numero di oggetto globale target meno l'Offset di quel documento, così che quando l'oggetto viene poi spostato da ShiftIndRef(Offset) il valore arrivi al numero globale voluto. Il primo documento riceve Offset = 0 e usa direttamente i numeri globali. Perché questa sottrazione sia corretta, la sequenza di offset in corso usata durante l'iniezione deve coincidere con la sequenza di offset usata quando gli oggetti vengono infine scritti
Coincide, grazie a una proprietà del modo in cui funzionano i merge delle pagine e dei form: AddPages, AddFields, e AddFieldFonts modificano solo gli oggetti esistenti del primo documento, non ne aggiungono mai di nuovi. Quindi il conteggio degli oggetti del primo documento resta invariato durante la fase di merge delle pagine, e l'offset di ogni documento seguente, cioè la somma di tutti i conteggi degli oggetti dei documenti precedenti, rimane stabile dall'iniezione alla scrittura finale. Rompi questo, introduci una fase che crea un nuovo oggetto a metà merge, e ogni riferimento di pagina e bookmark a valle finirebbe fuori di uno pari al numero di oggetti aggiunti. L'invariante è silenzioso, ma porta il peso strutturale dell'intero flusso
Tre punti di ingresso su un solo motore
Il percorso veloce non è un fork del codice di merge. Il motore a livello di byte è una singola routine interna, MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode), e le API pubbliche sono wrapper sottili che scelgono due flag:
MergeFileListFastchiama il motore con la preservazione dell'albero structure-tree disattivata, il percorso più snello, che scarta l'albero tagged-PDF così il percorso a byte si applica al maggior numero possibile di oggettiMergeFileListlo chiama con la preservazione attiva, così l'albero structure-tree sopravvive e il risultato resta un tagged PDF utilizzabile. Questo percorso ordinario eredita anche il merge multi-documento dei bookmark e dei formMergeFileListStrictattiva la strict mode: la prima passata di metadati si ferma al primo input che non segnala un merge pulito, così vengono inclusi solo i documenti raccolti prima del file difettoso, invece di saltarlo e andare avanti
Poiché tutti e tre condividono un solo motore, anche il merge ordinario gira come una singola passata lineare che apre ogni input una volta sola, invece di un ciclo a coppie O(N²) che fonde il file uno e due, fonde il risultato con il tre e così via, riparsando l'accumulatore in crescita a ogni passo. I punti di ingresso a due file e a due stream, MergeFiles e MergeStreams, restano disponibili per chi vuole davvero un merge a coppie
Una nota sul comportamento dell'albero di struttura, perché conta se verifici l'output ispezionando i byte. Il percorso veloce scarta l'albero rimuovendo il riferimento del catalogo del primo documento a /StructTreeRoot; l'oggetto structure-tree in sé viene comunque scritto, senza riferimenti. Così i byte dell'output veloce contengono ancora la stringa /StructTreeRoot, e cercare quella stringa non distingue l'output veloce da quello ordinario — la vera differenza è se il catalogo raggiunge ancora l'albero di struttura, che è ciò che determina se il file resta un tagged PDF navigabile
Quando scegliere quale percorso
Il percorso a byte è un'ottimizzazione di throughput per assemblare molti documenti quando non serve preservare l'albero di struttura tagged-PDF — fascicoli di report, elaborazioni di estratti conto, concatenazioni in batch. Misurato su merge ripetuti di insiemi di input medio-grandi, il riuso dei byte taglia circa il quattro-tredici percento del tempo a muro a seconda del mix di oggetti, e input piccoli o malformati si comportano esattamente come sul percorso completo, perché ogni oggetto che lo scanner non riesce a dichiarare sicuro ricade sul parse completo. Se ti serve l'albero di struttura intatto per l'accessibilità, usa il percorso di merge ordinario tagged-PDF, che lo preserva; e se lavori con singoli file molto grandi invece che con molti input, le tecniche di copia a byte descritte nell'articolo compagno sul merge e split di PDF grandi con accesso diretto ai file applicano la stessa filosofia "copia i byte, evita l'albero di oggetti completo" alla scala del file
Le routine di merge e le loro varianti fast e strict fanno parte della PDF Library for Delphi Delphi PDF Library, la cui documentazione contiene il riferimento completo per l'API dei file-list e le opzioni di merge descritte qui