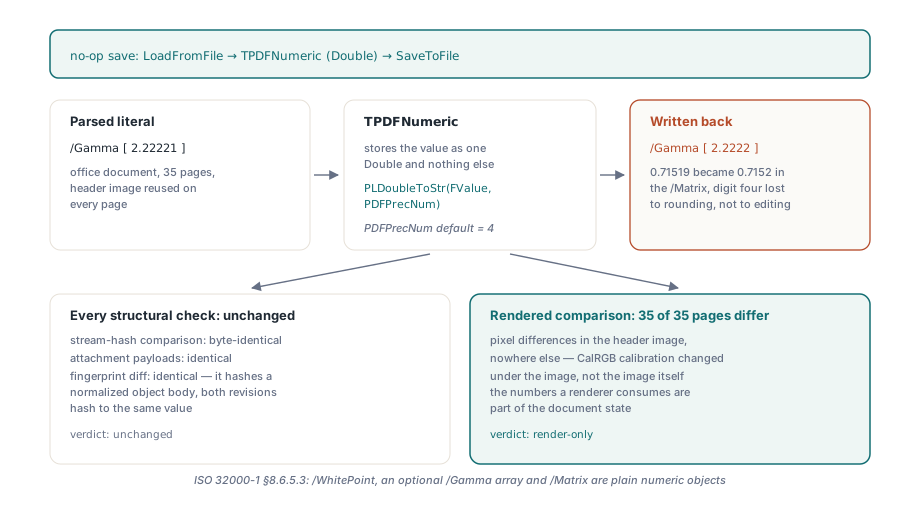
Carica un PDF calibrato, non cambiare nulla, salvalo con un nuovo nome e fai il diff del dizionario del color space: è entrato /Gamma [2.22221 2.22221 2.22221], è uscito /Gamma [2.2222 2.2222 2.2222]. Il writer ha riformattato un numero che non aveva alcun bisogno di toccare, e la pagina ora si renderizza con colori leggermente diversi. La cura è trattare ogni decimale letto come due cose insieme, un valore per l'aritmetica e un letterale per l'output, e continuare a emettere il letterale finché qualcuno non assegna davvero un nuovo valore
Perché un salvataggio no-op può spostare i colori CalRGB
I pixel si spostano perché al renderer vengono consegnati dati di calibrazione leggermente diversi mentre i byte dell'immagine restano identici. ISO 32000-1 §8.6.5.3 definisce un color space CalRGB con un /WhitePoint obbligatorio, un array /Gamma opzionale a tre elementi e una /Matrix opzionale a nove elementi, e sono tutti semplici oggetti numerici nel dizionario del color space. Falli passare per un Double e un formatter fisso a quattro cifre decimali, e 2.22221 diventa 2.2222 mentre una voce di matrice 0.71519 diventa 0.7152. Un valore di gamma è un esponente applicato a ogni componente di ogni pixel che passa per quello spazio, quindi il cambiamento si vede ovunque lo spazio venga usato
Per un file che dichiara un solo spazio CalRGB per un'immagine di intestazione riusata su 35 pagine, tutte e 35 le intestazioni si renderizzano con colori spostati e nient'altro su quelle pagine cambia. I controlli a cui si ricorre per primi tornano puliti. Un hash dei byte degli stream decodificati confronta i dati dell'immagine, e i dati dell'immagine sono davvero identici; il danno sta in un dizionario. Il diff di revisione descritto nell'articolo sul livello di modifica calcola l'impronta di un corpo oggetto normalizzato, quindi anche lì le due revisioni hanno lo stesso hash. È un confronto delle pagine renderizzate che lo intercetta. Per qualsiasi pipeline che riscrive PDF prodotti da altri software, metteremmo un confronto dei render per pagina davanti a ogni controllo strutturale
Che aspetto può avere un numero reale in un PDF
ISO 32000-1 §7.3.3 definisce un numero reale come una stringa decimale: un segno opzionale, cifre, un punto, altre cifre. Niente notazione con base. Niente forma esponenziale. L'Annex C, che elenca i limiti implementativi, si aspetta che vengano rispettate circa cinque cifre decimali significative nella parte frazionaria. Una precisione di output predefinita di quattro sta quindi già una cifra sotto ciò che la specifica dice ai reader di conservare, e il file non ha fatto nulla di sbagliato usandone cinque
Vicino allo zero, un formatter ingenuo fa di peggio che perdere una cifra. Il modo comune di stampare un Double a N posizioni è moltiplicare per 10^N, arrotondare a intero e scrivere le cifre, e quando quell'intero è zero l'output è 0. Dagli il primo operando di 0.00001 0 0 1 0 0 cm a quattro posizioni e il risultato è 0 0 0 1 0 0 cm, una matrice singolare che fa sparire tutto ciò che viene disegnato sotto di essa. Una voce di /Matrix pari a -0.000012345 fa la stessa fine
Quando PDF Library for Delphi (PDFlibPas) deve formattare un Double da sé, per un valore non nullo più piccolo del passo di precisione mantiene il numero richiesto di cifre significative invece di scrivere 0. A quattro posizioni, 0.00001 viene scritto come 0.00001 e 0.0000123 come 0.0000123; solo le grandezze sotto circa 5E-16 escono ancora come 0. Questo mantiene sani i numeri scritti ex novo. Un numero letto che non ha mai avuto bisogno di riformattazione è un'altra storia, e la libreria lo gestisce semplicemente non riformattandolo affatto
Come PDFlibPas conserva il letterale che ha letto
TPDFStructure.Decode conserva il testo sorgente di ogni reale standard che tokenizza, cioè un token con un punto decimale e senza marcatore di esponente, proprio accanto al Double convertito. TPDFNumeric.Output riscrive quel testo ogni volta che è presente e formatta il Double al PDFPrecNum della struttura solo quando non lo è. TPDFNumeric.SetTo scarta il testo, perché un numero modificato è un numero nuovo e deve seguire la precisione di output corrente
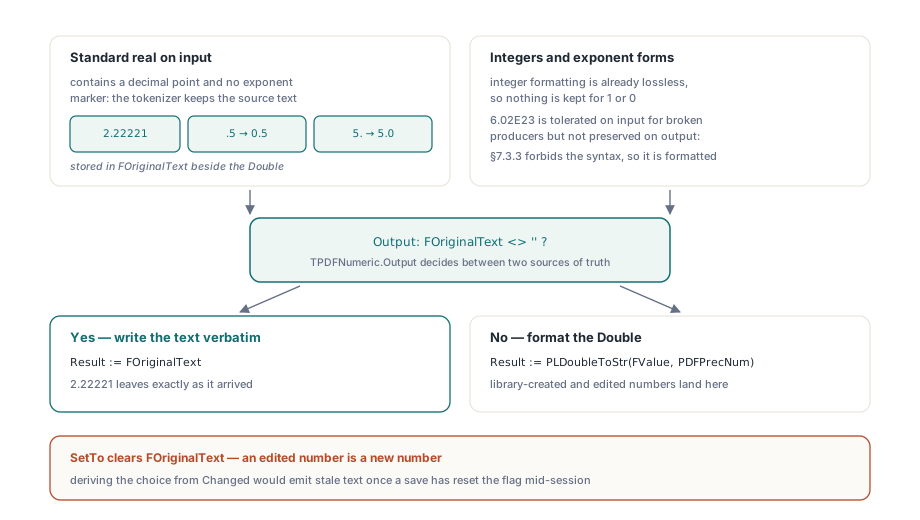
Legare il reset a SetTo è stata una scelta deliberata. La scorciatoia tentatrice è emettere il testo originale a meno che il flag Changed dell'oggetto sia impostato, visto che quel flag esiste già su ogni oggetto. La pipeline di salvataggio però azzera Changed una volta scritto l'oggetto, quindi un valore modificato, salvato e poi modificato di nuovo nella stessa sessione tornerebbe a emettere il suo letterale stantio al secondo salvataggio. Azzerare il testo dentro l'assegnazione stessa significa che letterale e valore non possono mai essere in disaccordo
Alcuni confini sono voluti. Gli interi non vengono memorizzati come testo perché la formattazione degli interi è già senza perdita. Le forme esponenziali come 6.02E23 vengono accettate in input per amore dei producer che le scrivono comunque, ma in output vengono formattate come qualsiasi numero generato dalla libreria, dato che ricopiarle perpetuerebbe una sintassi che la §7.3.3 esclude. Il tokenizer applica anche la sua solita piccola riparazione prima di memorizzare il testo: un letterale con punto iniziale come .5 viene tenuto come 0.5, uno con punto finale come 5. come 5.0. Ogni reader tratta ciascuna coppia come lo stesso numero, e la grafia riparata è accettata molto più largamente
Lo snippet qui sotto fa passare i valori CalRGB direttamente dal layer degli oggetti, così ogni regola si vede senza aprire un file PDF. Le righe Assert sono controlli che suggeriamo di aggiungere ai tuoi test; non sono chiamate alla libreria
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Controllo tuo: l'input non modificato sopravvive verbatim, compreso il
    // valore che un formatter ingenuo a quattro posizioni ridurrebbe a 0
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Una modifica scarta il testo originale e segue PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // I nuovi valori minuscoli mantengono le cifre significative invece di diventare 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // Abbassare la precisione dopo non arriva all'input non modificato
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Una trappola quando si scrivono assert come queste: la Round di Delphi usa l'arrotondamento bancario, e 0.000012345 * 1e8 in binario vale 1234.4999… e non 1234.5. Ci siamo sbattuti contro proprio quel valore controllando il percorso di formattazione vicino allo zero. Scegli input di test che non siano punti medi binari ogni volta che un'assert dipende da come arrotonda l'ultima cifra
Cosa controlla SetPrecision?
TPDFlib.SetPrecision imposta le cifre decimali dei numeri che la libreria scrive: la grafica disegnata tramite il painter, i numeri creati da un Double per esempio tramite NewNumeric, e i valori letti che nel frattempo sono stati cambiati con SetTo. Accetta da 2 a 8 e restituisce 0 per qualsiasi valore fuori da quell'intervallo. Un decimale letto che nessuno ha modificato mantiene il suo testo di input qualunque sia l'impostazione, e cambiare l'impostazione dopo LoadFromFile non lo tocca retroattivamente. Il sorgente passato a SetObjectFromString passa per lo stesso tokenizer e viene conservato allo stesso modo
Il nostro consiglio è lasciare in pace SetPrecision a meno che la geometria che generi non richieda passi più fini. Alzarlo per proteggere i file di input non compra nulla, perché l'input non toccato conserva già le proprie cifre, e rende più lungo ogni numero che disegni. Cinque posizioni sono una scelta sensata per il disegno sotto il punto; otto gonfia soprattutto i content stream
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Governa i numeri scritti da qui in poi; gli array /Gamma,
    // /Matrix e /WhitePoint letti mantengono il testo originale
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // i numeri disegnati usano cinque posizioni
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Content stream: le modifiche conservano gli operandi, la normalizzazione è opt-in
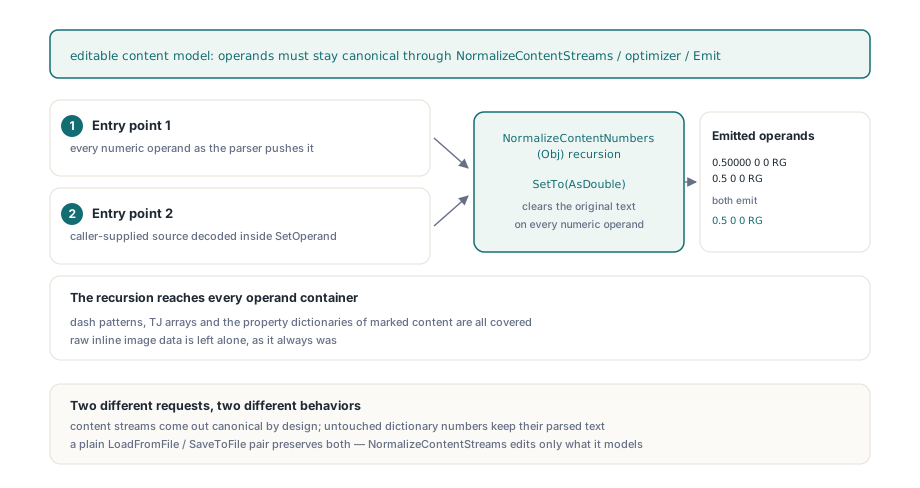
Il modello di contenuto editabile conserva il testo degli operandi per default e canonicalizza i numeri solo quando l'output canonico è lo scopo della chiamata. TPDFContentProgram.CanonicalNumbers ha come default False, quindi un layer restituito da ParsePageContentLayer, lo stesso modello su cui è costruito il tracker dello stato grafico, riemette ogni operando numerico non toccato esattamente com'era scritto. Le modifiche di pagina che riscrivono un intero layer, tra cui ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths e un tuo programma riscritto con WritePageContentLayer, cambiano solo gli operandi che la modifica ha toccato
L'altro default sembra più ordinato: canonicalizzare a ogni parse, così il percorso di modifica e NormalizeContentStreams producono sempre la stessa grafia. Pensiamo che sia il default sbagliato per la modifica. Una chiamata ScalePage su un layer contenente 0.123456 w riscriverebbe 0.1235 w, e ogni altro operando del layer verrebbe riscritto a sua volta, anche se il chiamante ha chiesto solo di scalare. La forma canonica appartiene alle operazioni il cui scopo è un output confrontabile
Quelle operazioni la ottengono comunque. NormalizeContentStreams e l'optimizer dei contenuti al salvataggio parsano con CanonicalNumbers impostato a True, perché il loro lavoro è un output stabile da input arbitrario; se 0.50000 0 0 RG e 0.5 0 0 RG venissero emessi in modo diverso, ogni confronto a valle andrebbe alla deriva con le abitudini di formattazione del producer. La canonicalizzazione ricorre attraverso array e dizionari, quindi pattern di tratteggio, array TJ e dizionari di proprietà del marked content sono coperti, mentre i dati grezzi delle immagini inline vengono lasciati stare. Gli operandi forniti tramite SetOperand vengono canonicalizzati qualunque cosa dica il flag. Un programma di contenuto porta un proprio store numerico fissato a quattro cifre decimali, indipendente da SetPrecision, quindi un operando modificato esce con quattro. Solo Parse legge il flag, il che significa che va impostato prima del parsing; per un programma che ParsePageContentLayer ha già parsato, imposta il flag e chiama Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Cambia uno spessore di linea; ogni altro operando mantiene il suo testo sorgente
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // emesso come 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Copia canonica solo per confronto, non riscritta:
      // Parse è l'unico a leggere il flag, quindi riparsa dopo averlo impostato
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit ora scrive 0.50000 e 0.5 allo stesso modo
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Messa insieme, la regola per chi chiama è breve. Un semplice LoadFromFile seguito da SaveToFile lascia i content stream non toccati e i numeri dei dizionari non toccati come stavano. Una pagina modificata attraverso il content model conserva il testo di ogni operando che la modifica non ha cambiato. NormalizeContentStreams, l'optimizer che gira quando il contenuto viene compresso al salvataggio, e qualsiasi programma parsato con CanonicalNumbers impostato a True producono numeri canonici per progetto, e il resto del documento è comunque preservato
Quanto costa, e dove si ferma la garanzia
Ogni TPDFNumeric porta un riferimento AnsiString in più, e ogni decimale letto tiene in vita il suo testo sorgente per tutta la vita dell'oggetto. Su un documento con milioni di numeri reali è memoria misurabile, e va messa in qualsiasi benchmark su documenti grandi che esegui. La garanzia è inoltre limitata al documento a cui il numero appartiene. Copiare oggetti tra documenti, o ricostruire valori tramite l'API degli oggetti, produce numeri nuovi, e i numeri nuovi seguono la precisione di output
Numeri preservati e output byte-identico sono proprietà separate. Un load-and-save di un documento non toccato conserva i numeri di calibrazione che il renderer consuma, ma l'identità byte per byte dipende anche dalla numerazione degli oggetti, dalla compressione degli stream e dall'identificatore nel trailer trattato nell'articolo sull'ID PDF deterministico. Il diff di impronte continua a fare l'hash del corpo normalizzato, il che significa che le differenze di arrotondamento nei file scritti da altri strumenti cadono fuori da ciò che confronta; per quelle il controllo resta un confronto dei render
La gestione dei numeri e la semantica esatta di SetPrecision sono trattate nel riferimento della losLab PDF Developer Library, insieme alle chiamate del content model usate sopra