L'attribut axis="rowAxis" sur un élément pivotField se lit comme du XML parfaitement sensé, et un lecteur qui le mappe en « champ de ligne » chargera le tableau croisé avec chaque champ sur le bon axe. Passez la même partie dans un validateur bâti depuis le schéma ECMA-376 Partie 1 §18.10 et il échoue au premier attribut : ST_Axis a exactement quatre jetons, axisRow, axisCol, axisPage et axisValues, et rowAxis n'en fait pas partie. Un rédacteur de tableaux croisés doit satisfaire le schéma plutôt que son propre lecteur, car les gens qui ouvrent le fichier utilisent Excel et leurs propres analyseurs
Les définitions de champs pivot regorgent de règles comme celle-là. Trois ont tendance à passer au travers d'un test d'aller-retour : les jetons d'énumération, l'exigence qu'un élément items ne soit jamais vide, et les entrées de sous-total finales qu'Excel liste après les items de données. Deux autres se trouvent côté lecture, dans des attributs qu'Excel omet parce qu'ils portent leur défaut de schéma. Le reste de cet article parcourt chaque règle, montre à quoi le XML doit ressembler, et montre les appels Delphi qui le produisent
Pourquoi un aller-retour ne peut pas attraper un mauvais jeton d'axe
Un aller-retour prouve que le générateur et le lecteur sont d'accord entre eux, et rien de plus. Si le lecteur accepte axisRow et rowAxis, un générateur qui émet le mauvais passe tous les contrôles sauvegarde-puis-charge que vous pouvez écrire, car le lecteur répare la faute au retour. La faute n'apparaît que quand un consommateur plus strict ouvre la partie : un validateur de schéma, un analyseur généré depuis le XSD, ou Excel décidant que la partie demande réparation
HotXLS sépare les deux côtés exprès. Le rédacteur XLSX n'émet que les quatre jetons ST_Axis, tandis que le lecteur de tableaux croisés mappe aussi les graphies d'apparence anglaise rowAxis, colAxis, pageAxis et dataAxis vers l'axe correspondant, si bien que les fichiers de producteurs qui les utilisent se chargent quand même avec leur disposition intacte. La sortie est tenue au schéma ; l'entrée n'a qu'à être reconnaissable. L'inverse, un lecteur strict accouplé à un générateur négligent, échouerait au moins bruyamment dans vos propres tests ; un lecteur indulgent accouplé à un générateur négligent n'échoue nulle part de visible
<!-- invalide : rowAxis n'est pas une valeur ST_Axis, et CT_Items ne peut pas être vide -->
<pivotField axis="rowAxis" defaultSubtotal="1"><items count="0"></items></pivotField>

<!-- valide : jeton ST_Axis, vrais items, sous-total default final -->
<pivotField axis="axisRow" defaultSubtotal="1">
  <items count="4"><item x="0"/><item x="1"/><item x="2" h="1"/><item t="default"/></items>
</pivotField>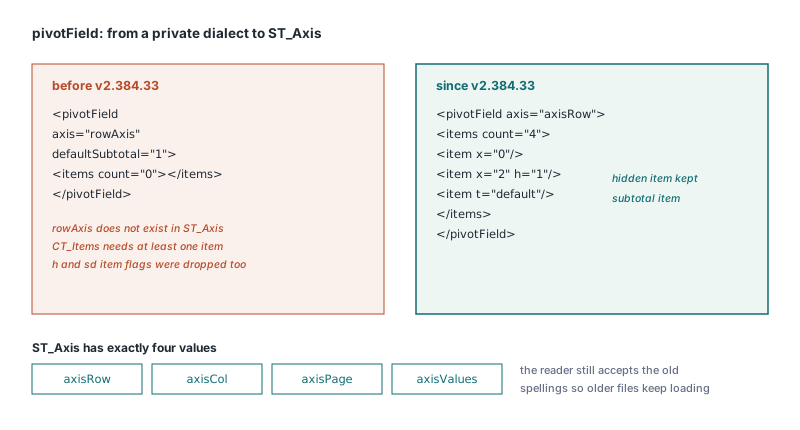
Ce que CT_PivotField attend au-delà de l'axe
CT_PivotField a trois autres exigences faciles à abandonner. Un champ agrégé dans la zone de valeurs doit le dire sur sa propre définition avec dataField="1", même si la liste <dataFields> le référence déjà. HotXLS pose ce drapeau sur chaque champ pivot vers lequel une entrée de DataFields pointe, si bien qu'un champ ajouté avec AddDataFieldByName est marqué aux deux endroits
La seconde règle est structurelle. CT_Items exige au moins un enfant item, ce qui rend <items count="0"></items> invalide même si c'est du XML bien formé qui s'analyse partout. Quand un champ n'a pas d'items, HotXLS laisse de côté tout l'élément items. La troisième règle concerne l'état de chaque item : un membre caché porte h="1" et un membre aux détails repliés porte sd="0". Les deux viennent de TXLSPivotItem.IsHidden et TXLSPivotItem.IsDetailHidden et sont écrits à chaque sauvegarde, si bien qu'un filtre posé en code survit jusqu'à Excel
Items de sous-total finaux et le piège du compte
Quand un champ a des items, Excel fait suivre les items de données d'un item supplémentaire par fonction de sous-total, typés avec ST_ItemType. Le sous-total automatique est <item t="default"/> ; les fonctions explicites emploient sum, countA, avg, max, min, product, count, stdDev, stdDevP, var et varP. Ces entrées ne portent aucun index x vers le cache, et elles sont incluses dans l'attribut count de items. Un rédacteur qui les omet produit une liste d'items qui ne correspond plus aux drapeaux de sous-total du même élément
HotXLS dérive la traîne de TXLSPivotField.Subtotals à la sauvegarde : un item t="…" par fonction de l'ensemble, en ordre d'énumération, ajouté au compte, plus l'attribut du genre sumSubtotal="1" sur le champ. Les champs créés par AddPivotTable démarrent avec un ensemble vide, ce qui écrit defaultSubtotal="0" et aucun item final du tout. Pour des rapports générés, laissez l'ensemble vide : les lignes de sous-total changent la hauteur du tableau croisé et décalent tout ce qui est placé dessous. N'ajoutez des fonctions à Subtotals que sur les champs où un lecteur a besoin des lignes supplémentaires
Le nommage mérite un second regard avant de choisir une fonction. xlpsCount mappe vers countA, qui compte toutes les entrées non vides, et xlpsCountNums mappe vers count, qui ne compte que les nombres. Quiconque lit « count » dans le XML et attrape xlpsCount obtient l'autre fonction
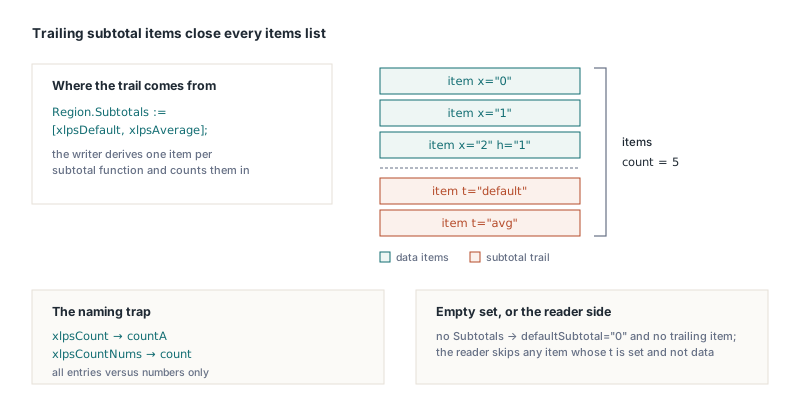
Le programme ci-dessous construit un tableau croisé depuis une feuille de données existante avec un champ de ligne, un champ de colonne et un champ de valeur. Le champ Region obtient le sous-total automatique plus une moyenne, ce qui produit deux items finaux après ses items de données et dataField="1" sur Revenue
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book  : TXLSXWorkbook;
  Sheet : TXLSXWorksheet;
  Pivot : TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    Sheet := Book.Sheets[1];                  // Sheets est en base 1
    Pivot := Sheet.AddPivotTable('Data!$A$1:$D$800', 3, 6, 'RegionTotals');
    if Pivot = nil then
      raise Exception.Create('Bad source range or anchor');

    Region := Pivot.AddRowField('Region');    // nil si aucun champ de ce nom
    if Region <> nil then
      Region.Subtotals := [xlpsDefault, xlpsAverage];  // -> t="default", t="avg"
    Pivot.AddColumnField('Quarter');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);      // Revenue reçoit dataField="1"

    Book.SaveAs('orders-pivot.xlsx');
  finally
    Book.Free;
  end;
end;
Lire ce qu'Excel omet
Le lecteur a le problème en miroir. Un champ pivot fabriqué par Excel liste ses entrées de sous-total dans items, et les charger comme membres ordinaires donnerait au champ des items fantômes qui ne pointent aucune valeur de cache. HotXLS saute tout item dont l'attribut t est présent et différent de data, ce qui couvre les entrées de sous-total, de total général et de vide. Les fonctions de sous-total arrivent par les propres drapeaux du champ et atterrissent dans Subtotals, si bien que le code qui parcourt Items ne voit que de vrais membres et que chaque CacheItemIndex réfère à une valeur de cache
Les attributs manquants sont l'autre moitié. Dans le schéma, defaultSubtotal sur CT_PivotField et containsString sur CT_SharedItems valent tous deux true par défaut, et Excel les omet quand ils portent cette valeur. HotXLS lit un defaultSubtotal absent comme true et ajoute xlpsDefault à Subtotals quand le champ ne porte aucun drapeau de sous-total explicite, ce qui est la façon dont Excel lui-même affiche un tel champ. Un containsString absent se lit aussi comme true, si bien qu'un champ de cache texte pur est classé comme données de type chaîne. Lisez l'un ou l'autre attribut comme false et chaque tableau croisé sauvegardé par Excel perd ses sous-totaux automatiques au chargement, pendant que les champs texte se transforment en un autre type. Un rédacteur qui épelle toujours chaque attribut ne touche jamais ce chemin ; seuls les fichiers d'un autre producteur l'exercent
Un classeur Excel chargé est la bonne entrée de test ici, car c'est le seul genre de fichier qui omet ces attributs. Le contrôle ci-dessous en ouvre un et parcourt un champ de ligne :
var
  Book : TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Fld  : TXLSPivotField;
  I, J : Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('saved-by-excel.xlsx');
    Pivot := Book.Sheets[1].PivotTables.FindByName('PivotTable1');
    if Pivot = nil then
      Exit;
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Fld := Pivot.Fields[I];
      if Fld.Axis <> xlpfaRowField then
        Continue;
      // Un champ Excel sans attributs de sous-total rapporte quand même le défaut
      if xlpsDefault in Fld.Subtotals then
        Writeln(Fld.Name, ': automatic subtotal');
      // Les entrées de sous-total ont été sautées, donc chaque item mappe une valeur de cache
      for J := 0 to Fld.ItemCount - 1 do
        Assert(Fld.Items[J].CacheItemIndex >= 0);  // contrôle suggéré pour vos propres tests
    end;
  finally
    Book.Free;
  end;
end;
Pourquoi numFmtId="General" est invalide sur les champs de cache
numFmtId="General" est invalide parce que ST_NumFmtId est un entier non signé, aussi naturel qu'il soit d'emprunter le nom que les utilisateurs voient dans la boîte de dialogue Format de cellule. Un analyseur qui type les attributs depuis le schéma rejette carrément le nom, et cette classe de défaillance est exactement celle qui devient une boîte de réparation dans Excel ; l'article sur les règles OPC et de balisage derrière l'invite de réparation d'Excel couvre la façon dont ces boîtes se déclenchent. HotXLS écrit chaque cacheField avec un numFmtId numérique tiré du NumberFormat du champ de cache, qui vaut 0, le format General intégré, sauf si quelque chose l'a réglé
Les tableaux croisés sous la ligne 65535 ont besoin de positions 32 bits
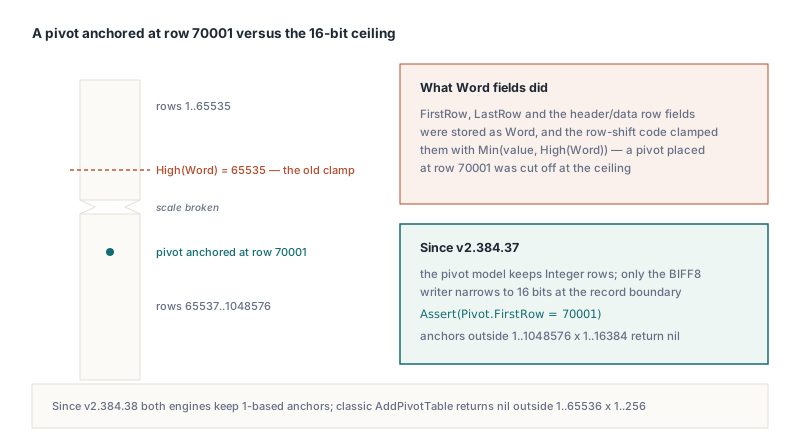
Un modèle de pivot partagé par les moteurs XLS et XLSX est tenté d'emprunter ses largeurs de champs à l'enregistrement BIFF8 SxView, où 16 bits couvrent chaque ligne qu'une feuille classique peut tenir. Une feuille XLSX court jusqu'à 1 048 576 lignes. Stockez FirstRow, LastRow, FirstHeaderRow, FirstDataRow et leurs équivalents en colonnes comme des Word, bornez-les avec Min(Value, High(Word)), et un tableau croisé ancré à la ligne 70001 se fait couper à 65535
Sur TXLSPivotTable, ces propriétés sont des Integer, et seul le rédacteur BIFF8 les resserre à la frontière d'enregistrement. TXLSXWorksheet.AddPivotTable renvoie nil pour une ancre hors de 1..1048576 par 1..16384, et AddPivotTableCopy renvoie nil quand l'étendue de la copie déborderait de la grille
var
  Book, Check: TXLSXWorkbook;
  Pivot      : TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    // La ligne 70001 est au-delà de la plage 16 bits
    Pivot := Book.Sheets[1].AddPivotTable('Data!$A$1:$D$800', 70001, 1, 'LateTotals');
    if Pivot = nil then
      Exit;  // ancre hors feuille ou plage source irrésoluble
    Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);
    Book.SaveAs('late.xlsx');
  finally
    Book.Free;
  end;

  Check := TXLSXWorkbook.Create;
  try
    Check.Open('late.xlsx');
    Pivot := Check.Sheets[1].PivotTables.FindByName('LateTotals');
    // Assert est un contrôle suggéré pour vos propres tests
    Assert((Pivot <> nil) and (Pivot.FirstRow = 70001));
  finally
    Check.Free;
  end;
end;
Le moteur XLS classique suit la même convention en base 1. Les enregistrements SxView et DConRef stockent des valeurs en base 0, tandis que le modèle, comme le moteur XLSX et Cells[Row, Col], garde des positions en base 1 : le lecteur BIFF8 ajoute 1 et le rédacteur retranche 1 à la frontière d'enregistrement. Le AddPivotTable classique renvoie nil pour une ancre hors de 1..65536 par 1..256, donc ancrez les tableaux croisés en (1, 1) plutôt qu'en (0, 0). La disposition des enregistrements elle-même est décrite dans les enregistrements SX du BIFF8 derrière les tableaux croisés .xls classiques
Tester contre le schéma plutôt que contre votre propre lecteur
Chaque piège ci-dessus survit à un aller-retour quand le côté indulgent et le côté fautif vivent dans la même bibliothèque. Trois genres de contrôle les attrapent. Une validation de schéma des parties pivotTableN.xml et pivotCacheDefinitionN.xml générées attrape les jetons inventés, les éléments items vides et les ids de format nommés. Des fichiers sauvegardés par Excel, passés dans votre lecteur, exercent les attributs qu'Excel omet à leurs défauts. Des assertions qui épinglent le jeton exact dans le XML écrit, comme axis="axisRow", attrapent un rédacteur qui dérive vers une graphie que seul votre lecteur comprend ; affirmer sur l'axe analysé ne le peut pas
Les tableaux croisés construits via l'API, y compris les champs calculés, les items calculés et les dispositions pourcentage-du-total montrés dans la construction et le rafraîchissement de tableaux croisés XLSX avec champs calculés, sortent avec ces règles appliquées et aucun code supplémentaire de votre côté. Le travail qui vous reste est de choisir quels champs obtiennent des sous-totaux et quelle fonction de compte vous visez
Le composant tableur HotXLS pour Delphi construit, lit et sauvegarde des tableaux croisés XLS et XLSX depuis du code Delphi et C++Builder, sans installation d'Excel ni automatisation COM sur la machine qui l'exécute