HotXLS construit et actualise des tableaux croisés dynamiques XLSX natifs depuis Delphi et C++Builder, sans installation d'Excel ni automation COM sur la machine. Vous appelez AddPivotTable avec une plage source, posez des champs sur les axes de lignes, de colonnes, de page et de données, ajoutez des éléments calculés ou un affichage en pourcentage du total, et le composant écrit les parties pivotCacheDefinition et pivotTableDefinition qu'Excel ouvre comme un tableau croisé vivant et actualisable
Le scénario qui rend l'exercice payant est celui d'un serveur de reporting. Vous générez des centaines de classeurs par nuit, chacun portant un tableau croisé qui résume un compte, et le mois suivant les nombres bougent et chaque fichier doit refléter les nouvelles lignes sources. Piloter Excel depuis un service Windows est fragile et non autorisé par la licence sur serveur, et écrire à la main le XML du tableau croisé est un chantier d'archéologie de spécification qui ne finit jamais. HotXLS se place entre ces deux impasses : un modèle objet typé au-dessus des parties de tableau croisé OOXML, si bien que le même Pascal qui remplit les cellules déclare aussi le tableau croisé et reconstruit son cache dans le même processus
Comment créer un tableau croisé dynamique en Delphi sans Excel ?
Vous en créez un par un seul appel, puis vous placez les champs sur les axes. AddPivotTable prend la plage source en notation A1, la cellule de destination où le tableau s'ancre, et un nom ; il analyse la plage, balaie chaque colonne pour en déduire le type de données, construit un cache de tableau croisé (ou en réutilise un déjà lié à la même plage), et renvoie un TXLSPivotTable dont tous les champs commencent hors axe. À partir de là, les méthodes de commodité AddRowField, AddColumnField, AddPageField et AddDataFieldByName câblent la disposition, et chaque champ de données prend l'une des onze agrégations de l'énumération TXLSPivotAggregation (xlpaSum, xlpaCount, xlpaAverage, xlpaMax, xlpaMin, xlpaProduct, xlpaCountNums, xlpaStdDev, xlpaStdDevP, xlpaVar, xlpaVarP)
uses
  lxHandleX, lxPivot;

var
  Book : TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Pivot: TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('sales.xlsx');
    Sheet := Book.Sheets[1];                 // feuille de rapport (base 1 dans le moteur XLSX)

    // Source A1:E500 sur la feuille 'Data' ; ancrer le tableau ligne 3, colonne 1.
    Pivot := Sheet.AddPivotTable('Data!$A$1:$E$500', 3, 1, 'SalesByRegion');
    if Pivot <> nil then
    begin
      Pivot.AddRowField('Region');
      Pivot.AddColumnField('Quarter');
      Pivot.AddPageField('Year');
      Pivot.AddDataFieldByName('Revenue', xlpaSum);
      Pivot.AddDataFieldByName('Units', xlpaAverage);
      Book.SaveAs('sales-pivot.xlsx');
    end;
  finally
    Book.Free;
  end;
end;
Pourquoi le cache et le tableau sont deux parties distinctes
Un tableau croisé dynamique est en réalité deux artefacts qui se référencent mutuellement, et comprendre cette séparation est ce qui garde le reste clair. Le pivotCacheDefinition est l'instantané des données : un worksheetSource qui pointe vers la plage source, et un cacheField par colonne contenant les valeurs distinctes de cette colonne (ses sharedItems) ainsi que les bornes dérivées. Le pivotTableDefinition est la vue : quel champ de cache siège sur quel axe, les champs de données et leurs agrégations, les bascules de disposition. La vue se lie au cache par cacheId à travers la relation pivotCaches du classeur, exactement comme le disposent ECMA-376 partie 1 §18.10 et [MS-XLSX]
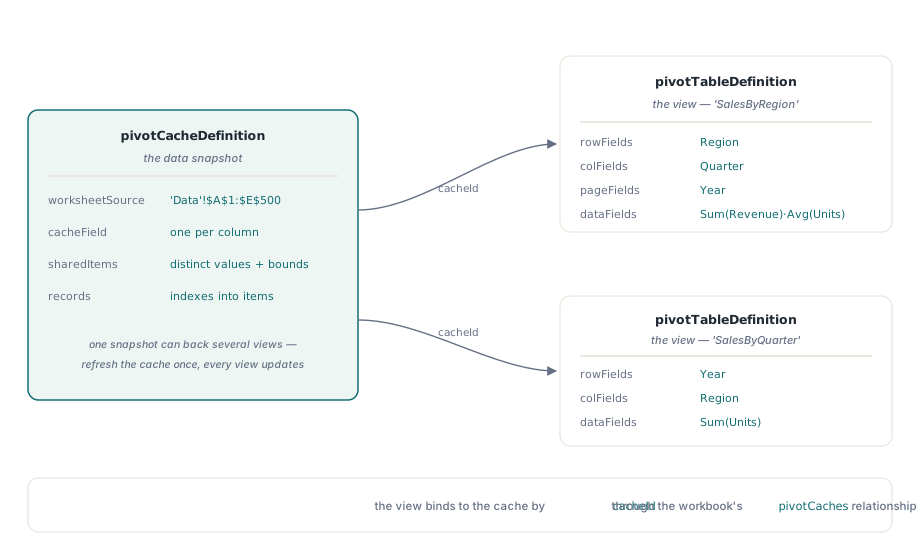
Cette indirection n'est pas de la bureaucratie, elle achète deux choses. Un cache peut alimenter plusieurs tableaux, si bien qu'actualiser le cache une fois met à jour toutes les vues qui en découlent. Et le cache range les valeurs de chaque colonne dédoublonnées avec une table d'index par enregistrement plutôt que la grille brute, ce qui explique pourquoi construire un tableau croisé consiste à balayer la source, non à copier des cellules. HotXLS modélise cela de la même façon pour les deux moteurs, si bien que le code ci-dessus est presque identique au chemin classique documenté avec la disposition binaire des enregistrements SX derrière les tableaux croisés .xls classiques. Si votre source vit sur une autre feuille ou si vous l'adressez par un nom, le préfixe de plage et les noms définis et références inter-feuilles suivent les règles A1 habituelles, les noms de feuilles entre apostrophes étant admis pour les noms comportant des espaces
Les éléments calculés ne sont pas des champs calculés
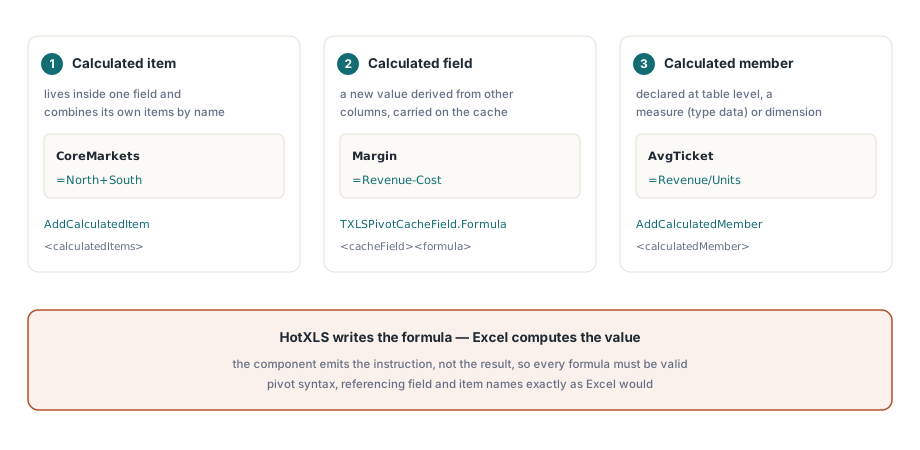
Ces trois termes désignent trois choses différentes, et les confondre est l'erreur classique des tableaux croisés. Un élément calculé vit à l'intérieur d'un champ et combine par leur nom les éléments de ce champ, si bien qu'au sein d'un champ Region vous pouvez définir une ligne synthétique CoreMarkets égale à North plus South ; HotXLS l'expose comme TXLSPivotField.AddCalculatedItem et écrit un <calculatedItem> sous les <calculatedItems> de ce champ. Un champ calculé est différent : c'est une nouvelle valeur dérivée d'autres colonnes, comme Margin à partir de Revenue et Cost, et il est porté comme une formule sur un champ de cache par TXLSPivotCacheField.Formula. Un membre calculé, ajouté par TXLSPivotTable.AddCalculatedMember, est un membre personnalisé au niveau du tableau qui peut jouer le rôle de mesure (type de membre data) ou de membre de dimension, surtout utile pour les tableaux croisés de forme OLAP
var
  Region: TXLSPivotField;
  Member: TXLSPivotCalculatedMember;
begin
  // Un ÉLÉMENT calculé combine par leur nom les éléments d'un seul champ.
  Region := Pivot.AddRowField('Region');
  Region.AddCalculatedItem('CoreMarkets', '=North+South');

  // Un MEMBRE calculé se déclare au niveau du tableau. Le type de membre
  // 'data' en fait une mesure ; un type vide donne un membre de dimension.
  Member := Pivot.AddCalculatedMember('AvgTicket', '=Revenue/Units');
  Member.MemberType := 'data';
end;
Une limite honnête s'applique aux trois. HotXLS émet le texte de la formule dans le XML de définition ; il ne l'évalue pas. Excel calcule l'élément, le champ ou le membre calculé quand il ouvre le fichier, de la même façon qu'il calcule chaque agrégat de la grille. HotXLS écrit les instructions, pas les résultats, si bien que les formules que vous fournissez doivent être des formules de tableau croisé valides dans le dialecte propre à Excel, en référençant les noms de champs et d'éléments comme Excel le ferait
Comment afficher les valeurs en pourcentage du total ?
Vous réglez le mode d'affichage des valeurs sur le champ de données plutôt que de transformer les nombres vous-même. TXLSPivotDataField.ShowDataAs prend l'énumération TXLSPivotShowDataAs, qui reflète les valeurs OOXML ST_ShowDataAs : xlpsdaNormal, xlpsdaDifference, xlpsdaPercent, xlpsdaPercentDiff, xlpsdaRunTotal, xlpsdaPercentOfRow, xlpsdaPercentOfCol, xlpsdaPercentOfTotal et xlpsdaIndex. Une astuce courante consiste à placer deux fois la même colonne source sur l'axe des données, une fois en somme brute et une fois en part du total général, afin que le rapport montre à la fois le nombre et son poids
var
  Rev, Share: TXLSPivotDataField;
begin
  Rev := Pivot.AddDataFieldByName('Revenue', xlpaSum);

  Share := Pivot.AddDataFieldByName('Revenue', xlpaSum);
  Share.DisplayName := 'Share of total';
  Share.ShowDataAs  := xlpsdaPercentOfTotal;

  // Les modes relatifs à un élément ont besoin d'une base de comparaison. Un cumul
  // le long de 'Quarter' (champ de cache d'index 3) s'écrirait :
  //   Share.ShowDataAs := xlpsdaRunTotal;
  //   Share.BaseField  := 3;         // index du champ de cache parcouru par la transformation
  //   Share.BaseItem   := $7FFD;     // $7FFD = "(Tous)"
end;
xlpsdaPercentOfTotal n'a besoin d'aucune base puisqu'il est relatif au total général, mais les modes relatifs à un élément, si. xlpsdaDifference, xlpsdaPercentDiff et xlpsdaRunTotal exigent BaseField (l'index du champ de cache sur lequel court la comparaison) et, pour les formes ancrées à un élément, un index BaseItem, où $7FFD représente la sentinelle (Tous). HotXLS les écrit sous forme des attributs <dataField showDataAs="percentOfTotal" baseField="N" baseItem="M"/> et, comme pour les formules calculées, laisse l'arithmétique à Excel
Regrouper dates et nombres, et filtres de champ de page
Le regroupement se configure sur le champ de cache, pas sur le champ de tableau croisé, car il change la façon dont le domaine source est découpé en tranches. Passez HasGroup := True sur le champ de cache renvoyé par Cache.FindFieldByName, puis choisissez soit les boutons de plage numérique (GroupStartNum, GroupEndNum, GroupInterval), soit les indicateurs de hiérarchie de dates (GroupByDate avec GroupMonths, GroupQuarters, GroupYears et un intervalle GroupStartDate / GroupEndDate). HotXLS émet l'élément <fieldGroup><rangePr groupBy="months"/> correspondant, si bien qu'un champ regroupé par mois ou par une tranche numérique de 1000 s'ouvre comme Excel l'aurait regroupé
Les champs de page sont les listes déroulantes de filtre au-dessus du tableau. AddPageField place un champ sur l'axe de page, et PageItemIndex présélectionne un unique élément de cache, avec pour valeur par défaut xlPageItemAll ($7FFD, qui signifie (Tous)). Pour laisser un lecteur cocher plusieurs éléments à la fois, passez MultipleItemSelectionAllowed := True, que HotXLS écrit sous la forme <pivotField multipleItemSelectionAllowed="1"/>. Pour des critères qui dépassent une sélection manuelle, chaque champ porte une collection typée Filters couvrant les familles OOXML ST_FilterType — filtres de nombre, de pourcentage, de somme, de libellé, de valeur et de date — chaque entrée associant un type de filtre à ses valeurs de comparaison
Comment actualiser un cache de tableau croisé quand la source change ?
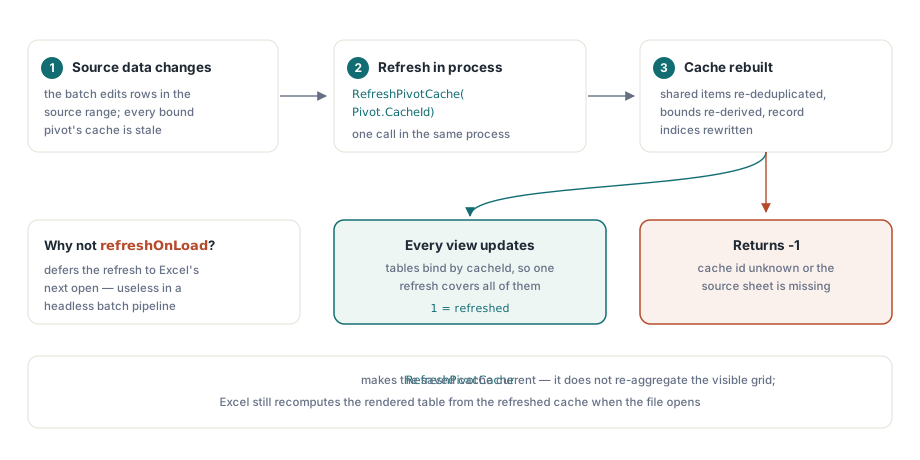
RefreshPivotCache sur TXLSXWorkbook rebalaie la plage source et reconstruit le cache sur place, ce dont un pipeline par lots a besoin après avoir modifié les lignes sous-jacentes. Passez l'identifiant du cache, et la méthode relit chaque cellule de la plage source (l'en-tête sur la première ligne, les données à partir de la deuxième), reconstruit le domaine d'éléments partagés de chaque champ en redédoublonnant les valeurs et en redérivant les bornes par type, puis réécrit les index d'éléments par enregistrement. Elle renvoie 1 en cas de succès et -1 quand l'identifiant de cache est inconnu ou que la feuille source manque
var
  Rc: Integer;
begin
  // ...les données sources ont changé depuis la construction du tableau croisé...
  Sheet := Book.Sheets[1];
  Sheet.Cells[2, 5].Value := 128000;             // un chiffre de Revenue corrigé

  // Reconstruire les éléments partagés et les index d'enregistrements du cache depuis la source.
  Rc := Book.RefreshPivotCache(Pivot.CacheId);   // 1 = actualisé, -1 = cache ou source absent
  if Rc = 1 then
    Book.SaveAs('sales-pivot-refreshed.xlsx');
end;
La limite sémantique mérite ici d'être énoncée sans détour. Avant l'existence de cette méthode, HotXLS s'appuyait sur l'indicateur refreshOnLoad="1" et laissait tout le travail d'actualisation à Excel à la prochaine ouverture, ce qui convient quand un humain ouvrira le fichier mais ne sert à rien dans un pipeline sans interface qui doit transmettre des données correctes. RefreshPivotCache rend le cache enregistré à jour dans le processus, et comme les tableaux se lient à un cache par identifiant, chaque tableau croisé issu de ce cache voit la mise à jour. Ce qu'elle ne fait pas, c'est disposer ni agréger la grille visible — Excel recalcule toujours le tableau rendu à partir du cache actualisé quand le fichier s'ouvre
Ce que HotXLS écrit et ce qu'Excel calcule
Gardez la division du travail en vue et plus rien ne vous surprend. HotXLS est un écrivain de définitions : il produit le pivotCacheDefinition, les enregistrements du cache et le pivotTableDefinition, avec axes, agrégations, éléments et membres calculés, affichages de valeurs, regroupements et filtres. Excel est le calculateur : à l'ouverture, il matérialise les tranches de regroupement, évalue les formules calculées, applique les transformations showDataAs et agrège le corps. Les valeurs que voit un utilisateur sont celles d'Excel, produites à partir des instructions écrites par HotXLS, ce qui explique pourquoi chaque formule et chaque index de base doit être correct au moment de l'écriture plutôt que contrôlé au moment du rendu
Deux limites méritent d'être connues avant de concevoir autour de cette fonctionnalité. AddPivotTable analyse une plage A1 rectangulaire avec un préfixe de feuille facultatif ; les sources en plage nommée et en classeur externe sortent de ce que le constructeur résout, même si les caches lus depuis un fichier écrit par Excel préservent leur source en plage nommée lors de l'aller-retour. Et les tableaux croisés créés par Excel que HotXLS lit sur disque sont rejoués octet pour octet à la sauvegarde, si bien que les modifications typées décrites ici s'appliquent proprement aux tableaux croisés que vous construisez par code tandis que les tableaux existants restent sans perte. Pour le versant entrée d'un rapport — les cellules validées et les tableaux filtrés que le tableau croisé résume — voyez la validation des données, le filtre automatique et les tableaux structurés
Le modèle de tableau croisé présenté ici fait partie du HotXLS Delphi Excel Component standard pour Delphi et C++Builder, qui lit et écrit à la fois les parties typées de tableau croisé XLSX et les enregistrements BIFF8 classiques depuis le même modèle objet