Excel affiche « We found a problem with some content » sur un XLSX que LibreOffice et tout lecteur maison ouvrent sans protestation, car Excel impose deux choses que ces lecteurs ignorent : les attributs exigés par le schéma et les règles d'unicité des Open Packaging Conventions. Trois de ces règles sont faciles à enfreindre dans tout writer qui combine des parties générées et des parties préservées : un <phoneticPr> a besoin de son fontId, chaque nom de partie reçoit exactement un Override dans [Content_Types].xml, et deux relations racine ne doivent jamais partager un identifiant tel que rId4. Cet article passe chaque règle en revue et montre comment HotXLS, le composant tableur Excel natif pour Delphi et C++Builder, écrit le package pour la satisfaire
Pourquoi Excel rejette-t-il un paquet que tous les autres lecteurs acceptent ?
Parce que l'invite de réparation est un validateur de schéma et de package, pas un échec d'analyse. Un classeur peut faire un aller-retour par votre bibliothèque, par LibreOffice et par des validateurs XML, et être structurellement sain au sens OPC employé dans l'article sur la résolution des relations XLSX OPC : chaque partie joignable, chaque cible résoluble. Ouvrez-le via Workbooks.Open dans une instance COM isolée avec DisplayAlerts désactivé et l'appel peut quand même échouer net. Interactivement, le même fichier produit le familier dialogue proposant de réparer, et le journal de réparation, quand Excel daigne en écrire un, nomme la partie mais pas la règle. Plusieurs violations indépendantes peuvent se cacher derrière cette unique invite, et Excel ne les signale pas une par une ; il refuse le classeur et vous laisse les trouver et les analyser. Ce qui suit détaille chaque règle, la manière naturelle de la violer, et comment HotXLS écrit le package à la place, car chacune est une règle sur laquelle tout writer XLSX Delphi peut trébucher
Règle 1 : phoneticPr fontId est obligatoire, même quand il vaut zéro
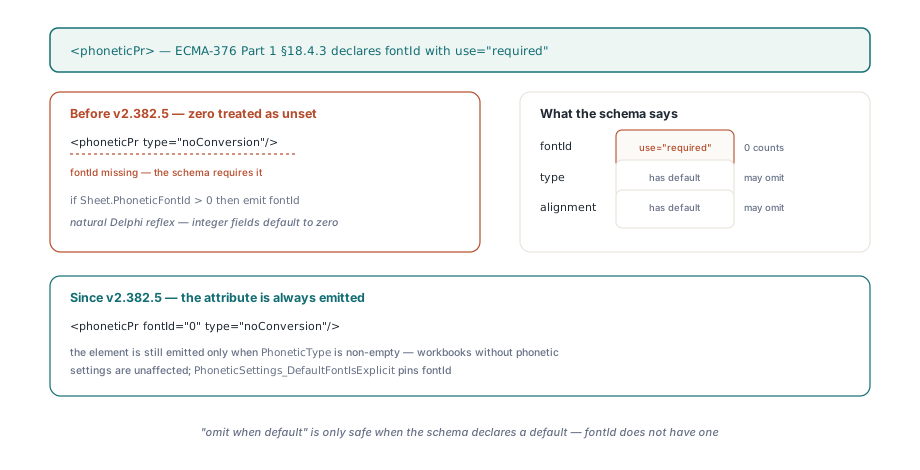
L'élément <phoneticPr> porte un attribut fontId déclaré use="required" dans ECMA-376 Part 1 §18.4.3, et la valeur 0 est un index de police légal, pas une absence. Un writer qui traite zéro comme « non défini » et n'émet l'attribut que quand Sheet.PhoneticFontId > 0 suit un réflexe Delphi naturel, puisque les champs entiers valent zéro par défaut, mais il produit <phoneticPr type="noConversion"/> pour tout classeur dont la police phonétique se trouve être la première police de styles.xml, ce qui est facile à rencontrer car l'index 0 est simplement la première police. Excel rejette alors, au retour, une valeur qu'il a écrite lui-même
// lxHandleX.pas, écrivain de feuille — avant la v2.382.5
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// v2.382.5 — l'attribut est obligatoire, zéro compris
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS n'émet l'élément que lorsque TXLSXWorksheet.PhoneticType est non vide, donc les classeurs qui n'ont jamais porté de réglages phonétiques ne sont pas affectés. Mettez PhoneticFontId à zéro sur une feuille neuve, enregistrez, et xl/worksheets/sheet1.xml porte <phoneticPr fontId="0". La leçon plus large : « omettre quand c'est la valeur par défaut » n'est sûr que si le schéma déclare un défaut ; type et alignment ont des défauts dans cet élément, fontId non
Règle 2 : un seul Override par nom de partie dans [Content_Types].xml
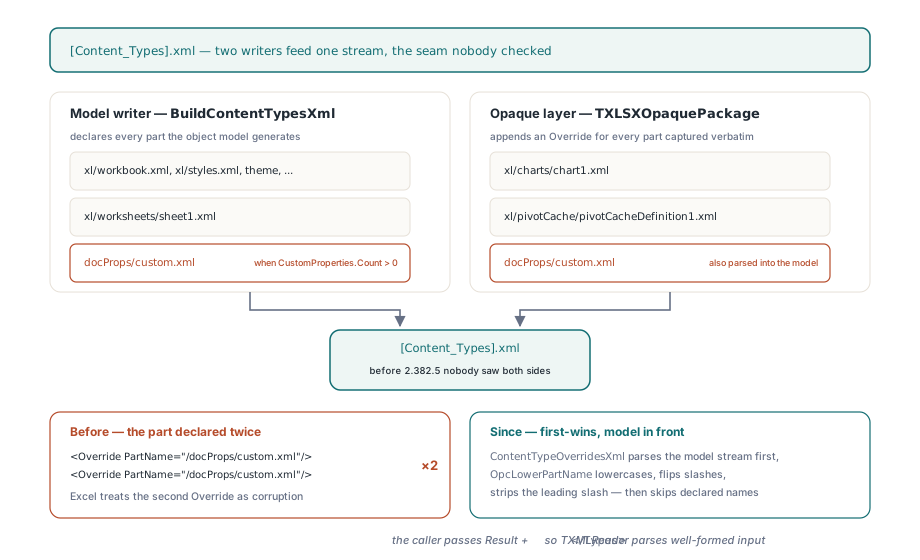
Le flux des types de contenu peut déclarer chaque nom de partie au plus une fois, et Excel traite un second Override pour le même PartName comme une corruption même quand les deux entrées portent le même ContentType. HotXLS a deux writers qui alimentent ce flux. BuildContentTypesXml déclare chaque partie que le modèle objet génère : classeur, styles, chaînes partagées, thème, feuilles et, quand TXLSXWorkbook.CustomProperties.Count > 0, /docProps/custom.xml. Quand PreserveUnsupportedParts est actif, TXLSXOpaquePackage ajoute ensuite un Override pour chaque partie capturée verbatim depuis le package source pour que ces octets restent déclarés en sortie. La collision, c'est une partie qui vit des deux côtés. Les propriétés de document personnalisées sont analysées dans le modèle, mais le docProps/custom.xml du package source est aussi capturé de façon opaque, donc une fusion naïve le déclare deux fois, et les parties de graphiques et de cache de pivot peuvent tomber au même endroit quand le modèle régénère une partie que la couche opaque a aussi retenue. Un writer opaque sans vue de ce que le modèle a déjà écrit ne peut pas le savoir, voilà pourquoi ContentTypeOverridesXml reçoit cette vue
<!-- Ce qu'Excel voyait avant la v2.382.5 -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS passe le XML généré à ContentTypeOverridesXml et laisse le writer opaque l'analyser avant d'émettre quoi que ce soit. Deux détails portent la correction. OpcLowerPartName met en minuscules, retourne les antislashs en slashs et retire les slashs initiaux avant comparaison, car les noms de parties OPC se comparent sans tenir compte de la casse et le modèle les écrit avec un slash initial alors que la couche opaque stocke les noms d'éléments ZIP sans. Et l'appelant dans BuildContentTypesXml passe Result + '</Types>', fermant le document partiellement construit pour que TXMLReader voie une entrée bien formée plutôt qu'un flux tronqué. La règle qui se dégage : premier arrivé gagnant avec le modèle devant, ce que le modèle objet déclare fait autorité, et la relecture opaque ne comble que les trous
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Analyser le flux généré par le modèle et collecter chaque PartName déclaré
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // déjà déclaré, ou partie rels
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Règle 3 : les identifiants de relation sont uniques dans une partie de relations
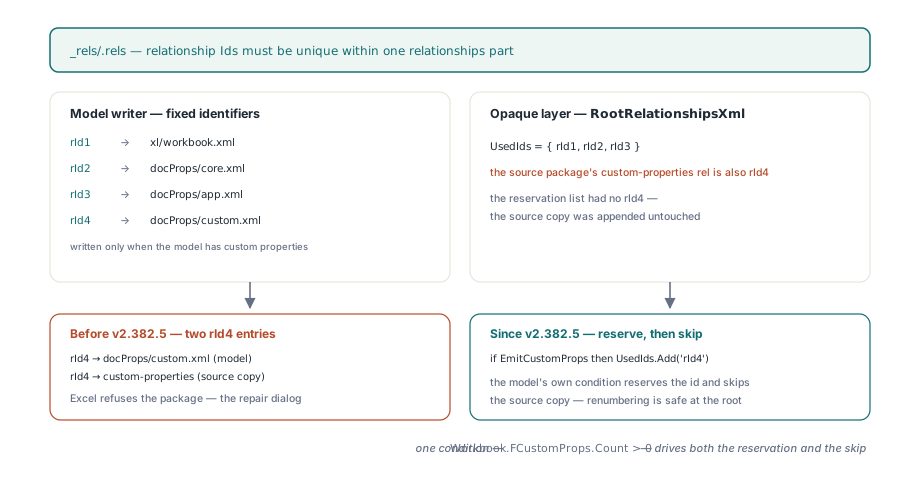
Chaque Relationship d'une partie .rels a besoin d'un Id unique dans cette partie, et Excel refuse le package quand deux le partagent. HotXLS écrit le _rels/.rels au niveau package avec des identifiants fixes : rId1 pour le classeur, rId2 et rId3 pour les propriétés de document core et étendues, et rId4 pour les propriétés personnalisées quand le modèle en a. Le package opaque ajoute ensuite toutes les relations racine qu'il a retenues du source, renumérotant tout identifiant déjà présent dans une liste UsedIds. Si cette liste ne connaît que rId1 à rId3, et pas le fait que le modèle s'apprête à émettre sa propre relation de propriétés personnalisées, un package source dont la relation de propriétés personnalisées est aussi rId4, ce qu'Excel écrit par défaut, ressort avec deux entrées rId4 pointant la même cible. RootRelationshipsXml réserve donc rId4 et saute la copie du source chaque fois que le modèle émet des propriétés personnalisées. L'appelant, BuildRootRelsXml, passe Workbook.FCustomProps.Count > 0 en second argument, si bien que la réservation et le saut sont pilotés par la même condition qui décide si le modèle émet un rId4. La renumérotation est sûre à la racine du package car rien dans le classeur ne référence les identifiants de relations racine par nom ; la même astuce serait fausse un niveau plus bas, où les attributs r:id de workbook.xml se lient aux identifiants de la partie de relations du classeur, voilà pourquoi MergeWorkbookRelationshipsXml tient une table d'identifiants séparée
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // réservé par l'écrivain du modèle
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // Le modèle possède désormais les propriétés personnalisées ; ne pas rejouer la copie source
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // plus petit rIdN libre
  UsedIds.Add(String(Id));
  ...
end;
Qu'ont en commun ces trois règles ?
Les trois gardent contre un writer à deux sources sans propriétaire unique des invariants du package. Le modèle objet génère les parties qu'il comprend ; la couche opaque rejoue celles qu'il ne comprend pas, pour qu'un aller-retour conserve graphiques, caches de pivot, XML personnalisé et tout ce que décrivent les notes sur l'aller-retour sans perte de theme, extLst et calcChain. Chaque côté peut être individuellement cohérent. Les contraintes que l'OPC met au package entier, noms de parties Override uniques et identifiants de relations uniques par partie, n'existent qu'à la couture où les deux sont concaténés, donc quelque chose doit posséder la couture. La règle du fontId est de la même forme un niveau en dessous : un writer peut savoir ce qu'il veut omettre sans jamais consulter le schéma qui dit qu'il n'en a pas le droit. HotXLS tranche avec une précédence fixe plutôt qu'une heuristique de fusion. Le modèle écrit d'abord, et la couche opaque voit ce qui est écrit et cède à toute collision. Les invariants sont aussi peu coûteux à vérifier de l'extérieur : lisez [Content_Types].xml et chaque élément .rels d'un package enregistré et échouez sur tout PartName, Extension ou Id dupliqué. Ce test n'a pas besoin d'Excel et couvre les deux règles d'unicité ; la règle du fontId exige toujours un validateur de schéma
Des zones d'impression qui sont des formules, pas des plages
La zone d'impression est l'autre chose qu'Excel compare sur une copie enregistrée : un modèle dont le _xlnm.Print_Area est rapporté par Excel comme $A$1:$J$29 doit se rapporter à l'identique après un aller-retour. Deux pièges se cachent là. À l'import, un retrait de préfixe qui coupe tout jusqu'au premier ! non quoté transforme une zone d'impression dynamique telle que OFFSET('Print Data'!$A$1,0,0,2,2) en $A$1,0,0,2,2), et fait qu'une union qualifiée telle que 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 perd son préfixe sur son premier segment seulement. À l'export, préfixer le nom de feuille une seule fois devant tout le PrintArea stocké donne à une union simple $A$1:$B$2,$D$1:$E$2 un premier segment qualifié et un second nu, ce qu'Excel n'accepte pas comme définition de _xlnm.Print_Area sous ECMA-376 Part 1 §18.2.5
// Import : ne retirer le préfixe que si ce qui reste est un sqref simple
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) est renvoyé tel quel

// Export : qualifier chaque segment séparé par des virgules, ou aucun
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // une formule : émettre tel quel
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
La règle d'appariement est la même des deux côtés : une zone d'impression est une plage nue seulement si chaque segment s'analyse comme tel, sinon c'est une formule et elle voyage verbatim. Avec cette règle, la base nommée, la base qualifiée par feuille et l'union survivent à des cycles répétés d'enregistrement et de réouverture. La façon dont les zones d'impression interagissent avec la mise en page et le reste du modèle d'impression est traitée dans l'article sur la protection de feuille, la mise en page et l'impression
Comment trouver à quelle règle Excel objecte ?
Partez du postulat que votre propre validateur se trompe, puisqu'il a validé. Le validateur de l'Open XML SDK nommera une violation de schéma comme le fontId manquant avec la partie et le XPath, et la couche d'empaquetage en dessous refuse carrément d'ouvrir un package avec des entrées de type de contenu dupliquées, donc faites-le tourner avant tout. Quand il se tait et qu'Excel répare quand même, bissectez le package : dézippez, supprimez une partie avec sa relation et son Override, rezippez, rouvrez, en divisant par deux l'ensemble candidat à chaque tour jusqu'à ce que l'invite disparaisse. Les trois violations ci-dessus surgissent dans cet ordre, et aucune ne serait visible dans le fichier réparé qu'Excel propose d'enregistrer, puisque la réparation abandonne ou renumérote silencieusement les entrées fautives. Deux choix de conception du writer HotXLS sont bons à connaître. La déduplication est premier-arrivé-gagné avec le modèle devant, donc si le package source déclarait un type de contenu différent pour une partie que le modèle génère aussi, la déclaration du modèle gagne et celle du source est jetée, ce qui est correct pour les parties qu'HotXLS régénère et n'est pas une fusion générale. Et la passe TXMLReader supplémentaire sur le flux des types de contenu généré tourne à chaque enregistrement avec PreserveUnsupportedParts activé, un petit coût pour un flux qui dépasse rarement quelques kilooctets. Avec ces règles en place, un modèle de prêt de 4805 formules enregistré par les builds Win32 et Win64 s'ouvre dans Excel sans invite, recalcule avec zéro écart et rapporte la même zone d'impression que l'original
Si vous écrivez vous-même du XLSX depuis Delphi, la liste de contrôle est courte : émettez chaque attribut que le schéma marque comme obligatoire quelle que soit sa valeur, déclarez chaque nom de partie une seule fois, et tenez une seule liste d'identifiants utilisés par partie de relations pour tous les écrivains qui la touchent. Si vous préférez que cette liste existe déjà et soit testée contre Excel plutôt que contre votre seul lecteur, l'écrivain de paquet décrit ici est livré dans le composant tableur Delphi HotXLS, avec l'aller-retour des parties opaques qui rendait la jointure digne d'être surveillée