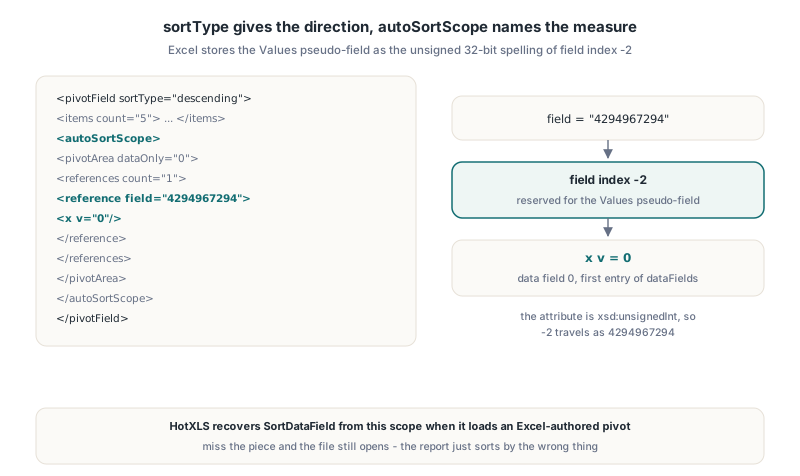
HotXLS trie les éléments de PivotTable par valeur en Delphi au travers de deux propriétés de TXLSPivotField : SortType choisit croissant ou décroissant, et SortDataField nomme le champ de données à base zéro dont les totaux pilotent lordre. Quand HotXLS ouvre un XLSX rédigé par Excel, il récupère ce champ de données depuis lélément autoSortScope, où Excel stocke le champ Valeurs comme field="4294967294", lorthographe non signée de -2
Trier par valeur est la demande que finit par recevoir tout rapport de ventes : "montrez-moi les régions de la plus grande à la plus petite". Dans linterface Excel cest deux clics. Dans le format de fichier cest un attribut, une zone de pivot imbriquée, un index de champ réservé et un ordinal de champ de données sélectionné, et un lecteur qui rate une seule de ces pièces ouvre quand même le fichier sans plainte. Il trie simplement par la mauvaise chose
Où Excel stocke-t-il une mesure de tri par valeur ?
Excel stocke la mesure de tri seulement à lintérieur dautoSortScope, pas sur le champ lui-même. Lattribut sortType sur <pivotField> (une valeur ST_FieldSortType dECMA-376 Part 1 : manual, ascending ou descending) dit dans quel sens trier. Quelle mesure employer pour trier vit dans un <autoSortScope> enfant, qui enveloppe un <pivotArea> dont la référence daxe de données sélectionne un champ de données
<pivotField axis="axisRow" showAll="0" sortType="descending">
  <items count="5"> ... </items>
  <autoSortScope>
    <pivotArea dataOnly="0" outlineLevel="all" fieldPosition="0">
      <references count="1">
        <reference field="4294967294" count="1" selected="0">
          <x v="0"/>
        </reference>
      </references>
    </pivotArea>
  </autoSortScope>
</pivotField>
Lélément reference pointe normalement un champ de pivot par index. Lindex de champ -2 est réservé dans la partie PivotTable dECMA-376 pour le pseudo-champ Valeurs, celui quExcel montre comme "Values" quand deux mesures ou plus siègent sur un axe. Lattribut est typé comme un entier 32 bits non signé, si bien que -2 passe sur le fil en 4294967294. Le <x v="0"/> en dessous sélectionne le champ de données 0, la première entrée de <dataFields>. Il y a aussi un attribut rankBy sur <pivotField>, mais dans les fichiers que nous avons comparés Excel la laissé de côté et comptait sur la portée seule
Pourquoi la mesure de tri revenait-elle en -1 ?
Le lecteur HotXLS perdait à lorigine la mesure de tri parce que 4294967294 ne tient pas dans un entier 32 bits signé. Le helper dattributs est une fine enveloppe autour de StrToIntDef, et une valeur hors plage renvoie en silence le défaut, si bien que le test daxe de données ne correspondait jamais, SortDataField restait à -1, et le champ ne gardait que sortType="descending" sans mesure attachée
La défaillance était silencieuse de la pire façon. Un champ décroissant sans mesure trie quand même, juste par étiquette délément à lenvers, si bien quun rapport quExcel avait ordonné par total revenait de HotXLS comme lordre des éléments inversé. Rien ne levait dexception et les nombres de chaque cellule étaient corrects. Seul lordre des lignes était faux, et seulement pour les fichiers quExcel avait rédigés
La correction dans lxPivotXml.pas compare le token brut dattribut comme une chaîne avant toute conversion entière. Si rankBy a déjà réglé une mesure, elle lemporte ; sinon une référence dont le token field vaut exactement '4294967294' résout SortDataField depuis sa valeur x sélectionnée. Le côté évaluation na eu besoin daucun changement : le comparateur finalisait déjà les totaux par membre sur les axes ligne et colonne, gérait lordre décroissant et départageait les égalités. Les données ne lui parvenaient simplement jamais
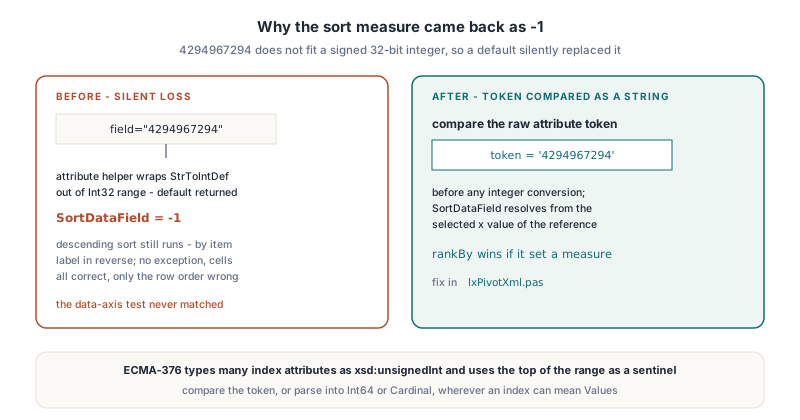
La leçon générale sapplique à tout lecteur OOXML écrit en Delphi. ECMA-376 type plusieurs attributs dindex comme xsd:unsignedInt puis emploie le haut de la plage comme sentinelle, si bien quun lecteur signé avec un repli par défaut transforme une valeur réservée en "attribut manquant". Comparez le token, ou analysez en Int64 ou Cardinal, partout où un index de champ peut signifier Valeurs
Trier les éléments de pivot par une mesure depuis du code Delphi
Pour trier un champ de pivot HotXLS par valeur, réglez SortType à xlpfstAscending ou xlpfstDescending et SortDataField à lindex à base zéro de la mesure dans la liste DataFields de la table. Avec SortType = xlpfstManual, qui est le défaut, SortDataField est ignoré et les éléments gardent leur ordre de cache ou programmatique
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book: TXLSXWorkbook;
  Data, Report: TXLSXWorksheet;
  Pivot: TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Data := Book.Sheets.Add('Data');
    Data.Cells[1, 1].Value := 'Region';
    Data.Cells[1, 2].Value := 'Product';
    Data.Cells[1, 3].Value := 'Units';
    // ... remplir les lignes 2..41 ...
    Report := Book.Sheets.Add('Report');

    Pivot := Report.AddPivotTable('Data!A1:C41', 3, 1, 'UnitsByRegion');
    Region := Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Units', xlpaSum);   // champ de données 0

    Region.SortType := xlpfstDescending;  // la plus grande région dabord
    Region.SortDataField := 0;            // trier par Sum of Units
    Region.AutoSortScope := '0';          // émet aussi lautoSortScope propre à Excel

    if Book.MaterializeNativePivotTable(Pivot) <> 1 then
      raise Exception.Create('Pivot layout was rejected');
    Book.SaveAs('units-by-region.xlsx');
  finally
    Book.Free;
  end;
end;
Deux détails méritent une note. Le rédacteur HotXLS émet SortDataField comme rankBy, et quand AutoSortScope nest pas vide il écrit aussi un bloc autoSortScope avec la référence daxe de données 4294967294, en mettant la chaîne de la propriété dans le logement x v. Au chargement, AutoSortScope reçoit ce même token x v, si bien que pour les tris par valeur la propriété détient lordinal du champ de données comme texte. Le régler à '0' produit donc un fichier qui porte la mesure aux deux endroits, ce qui est la correspondance la plus proche de ce quExcel écrit lui-même. MaterializeNativePivotTable met alors en scène la grille triée et ses métadonnées de disposition ensemble et renvoie 1 en succès ou -1 avec un diagnostic
Les lignes déléments ne sont pas la seule chose triée. Les champs de colonnes passent par le même comparateur, en employant les totaux par colonne au lieu des totaux par ligne, si bien quun champ de colonnes avec SortType = xlpfstDescending et un SortDataField valide ordonne ses colonnes par valeur exactement de la même façon
Inspecter le tri quun classeur Excel porte déjà
Pour les fichiers rédigés par Excel, HotXLS remplit SortType, SortDataField et AutoSortScope pendant le chargement de la définition de pivot, si bien que vous pouvez auditer ou changer le tri dun rapport sans reconstruire la table. Le fragment ci-dessous liste chaque champ qui trie par une mesure et nomme la mesure par son DisplayName
var
  Book: TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Field: TXLSPivotField;
  I: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('sales-report.xlsx');
    Pivot := Book.Sheets.SheetByName('Report').PivotTables[0];
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Field := Pivot.Fields[I];
      if (Field.SortType <> xlpfstManual) and (Field.SortDataField >= 0) then
        Writeln(Field.Name, ' sorted by ',
          Pivot.DataFields[Field.SortDataField].DisplayName);
    end;

    // basculer le tri Region en croissant et reconstruire la grille existante
    Field := Pivot.FindFieldByName('Region');
    if Field <> nil then
      Field.SortType := xlpfstAscending;
    if Book.MaterializeNativePivotTable(Pivot, True) <> 1 then
      raise Exception.Create('Could not re-materialize the pivot');
    Book.SaveAs('sales-report-asc.xlsx');
  finally
    Book.Free;
  end;
end;
Le second argument de MaterializeNativePivotTable dit à HotXLS dadopter la plage de sortie existante du pivot au lieu de la traiter comme une collision. Le même schéma apparaît dans le guide des Show Values As rang et totaux cumulés dans HotXLS, où lordre de tri compte parce que les totaux cumulés saccumulent dans lordre daffichage
Comment HotXLS départage-t-il quand deux éléments ont la même valeur ?
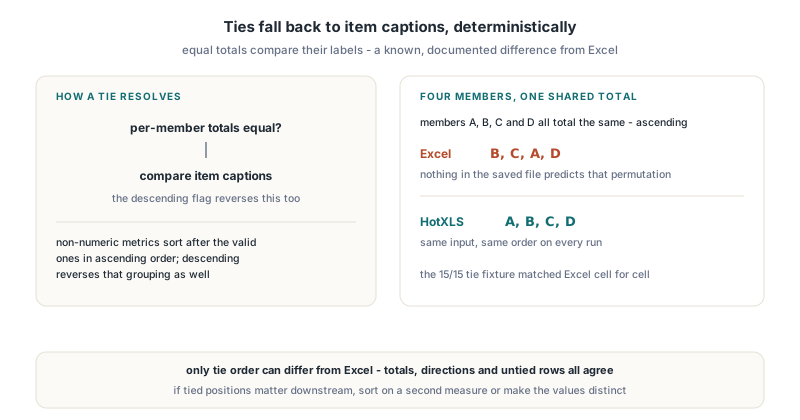
HotXLS départage par étiquette délément, de façon déterministe, ce qui est une différence connue davec Excel. Quand deux membres ont des totaux identiques, le comparateur retombe sur la comparaison de leurs légendes, et le drapeau décroissant inverse cette comparaison aussi. Les éléments dont la métrique nest pas un nombre valide trient après les valides en ordre croissant, et le drapeau décroissant inverse toute la comparaison, ce groupement inclus
Excel ne promet aucun ordre dégalité du tout. Dans une fixture de test où quatre membres, A, B, C et D, avaient tous le même total, un tri croissant dans Excel produisait B, C, A, D. Rien dans les métadonnées sauvegardées ne prédit cette permutation ; cest un sous-produit dun tri instable, et il peut différer entre fichiers. HotXLS renvoie A, B, C, D pour la même entrée. Notre vérification pour ce cas contrôle lensemble des membres et les valeurs par membre plutôt que la séquence, et la fixture décroissante avec une égalité 15/15 correspondait à Excel cellule pour cellule. Si votre code en aval dépend de la position exacte des lignes à égalité, triez sur une seconde mesure ou rendez les valeurs distinctes
Membres repliés et le champ le plus interne
Les membres repliés se matérialisent dans HotXLS comme une ligne agrégée par élément replié. Quand Excel cache les détails dun élément, il écrit sd="0" sur ce <item> ; HotXLS lexpose comme TXLSPivotItem.IsDetailHidden. Lélément replié se rend avec son étiquette simple, remplace tout son sous-arbre, et le repli sapplique à cet élément sous chaque parent, tandis que les blocs englobants gardent leurs propres sous-totaux
var
  Category: TXLSPivotField;
begin
  // Le pivot a Category (externe) et Product (interne) en lignes
  Category := Pivot.FindFieldByName('Category');
  if (Category <> nil) and (Category.ItemCount > 0) then
    Category.Items[0].IsDetailHidden := True;   // replier la première catégorie
  if Book.MaterializeNativePivotTable(Pivot, True) <> 1 then
    raise Exception.Create('Collapse was rejected');
end;
Le repli interagit avec le tri de façon prévisible : une ligne repliée reste un membre de son champ, si bien quelle prend sa position de son total comme tout autre élément. Le champ le plus interne est différent. Il na aucun niveau interne, donc il ny a rien à replier et, depuis une correction antérieure, HotXLS ne rend jamais de ligne de sous-total pour lui non plus, même quand son drapeau defaultSubtotal est posé. Excel se comporte pareil sur les axes à champ unique et multiniveaux, et avant ce changement HotXLS pouvait émettre une ligne Total fantôme sous le champ le plus interne. Pour les attributs de niveau champ impliqués ici, le parcours HotXLS de la validité de schéma CT_PivotField couvre ce que le schéma exige sur <pivotField> et ses éléments
Pièges quand on vérifie contre lautomatisation Excel
Quand vous contre-vérifiez un tri HotXLS contre Excel par automatisation COM, appelez AutoSort avec la légende localisée de la mesure, orthographiée exactement comme Excel la montre. Sur un Excel en chinois, la légende par défaut dun champ Units sommé est '求和项:Units' ; passer 'Sum of Units' sur cette machine ne lève aucune erreur et ne change rien. Le même script qui marche sur un Excel anglais devient silencieusement un no-op ailleurs, donc lisez la légende depuis le champ de données au lieu de la coder en dur
PivotField.SortTypene pouvait pas être relu au travers de COM dans la build dExcel que nous avons testée, donc vérifiez plutôt le tri depuis le XML sauvegardé ou les cellules rendues- Dans cette build, placer un champ parent de groupe manuel sur le même axe hors du champ trié supprimait le tri des membres par valeur ; le rendu trié sous des parents de groupe manuel nest pas vérifié
- Les écritures vers
PivotField.OutlineetPivotField.LayoutFormétaient rejetées dans cette build aussi, donc réglez une disposition en plan pour une fixture viaPivotTable.RowAxisLayoutà la place
Aucune de ces bizarreries ne change le format de fichier, mais elles décident si un test de régression prouve quoi que ce soit. Un test qui appelle AutoSort avec la mauvaise légende passe contre un pivot qui na jamais été trié
FAQ
Que signifie le champ 4294967294 dans un fichier XML PivotTable ?
Le champ 4294967294 est lencodage 32 bits non signé de lindex de champ -2, que ECMA-376 réserve au pseudo-champ Valeurs. À lintérieur dautoSortScope il marque une référence daxe de données, et son enfant x sélectionne le champ de données selon lequel les éléments sont triés
HotXLS trie-t-il les éléments de pivot par valeur sans Excel installé ?
Oui. HotXLS évalue le tri lui-même quand il matérialise la grille de pivot, en employant les totaux par membre du champ de données choisi, et écrit sortType, rankBy et optionnellement autoSortScope pour quExcel garde le même ordre après un refresh. Seul lordre des égalités entre valeurs égales peut différer dExcel
Pourquoi mes éléments de pivot sont-ils triés alphabétiquement au lieu de par valeur ?
Dordinaire parce que le champ a un sens de tri mais pas de mesure. Vérifiez que SortType nest pas xlpfstManual et que SortDataField est entre 0 et DataFieldCount - 1 ; avec -1, HotXLS ordonne les éléments par étiquette dans le sens demandé
Le tri par valeur, les membres repliés et le reste du pipeline de pivot natif sont livrés dans HotXLS, le composant de tableur Delphi pour XLS et XLSX, qui lit, édite et écrit des classeurs Excel sans Excel installé. Si vous construisez dabord le pivot de zéro, le tutoriel HotXLS de construction et rafraîchissement de pivots couvre caches, champs et refresh avant den venir à leur ordre