HotPDF exécute Tesseract à l’intérieur de votre processus Delphi via HPDFCreateTesseractDLLOCREngine, une factory ajoutée en v2.772.0 qui charge dynamiquement une DLL compatible Tesseract 5, pilote son API C (TessBaseAPIInit2, TessBaseAPIRecognize, l’itérateur de résultats) et renvoie un IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer utilise ce moteur pour ajouter une couche de texte Unicode invisible et cherchable aux pages PDF scannées
Le même reconnaisseur était déjà accessible par l’adaptateur tesseract.exe externe qui écrit un BMP et analyse du TSV. Ce chemin marche, mais chaque page paie un lancement de processus, un fichier bitmap temporaire et un format de texte sans baselines ni contrôle de la segmentation de page. Appeler la DLL supprime les trois. Elle supprime aussi le mur du processus, ce qui veut dire qu’une liaison Pascal se pose directement sur des structures C, des booléens C et des chaînes allouées en C. L’essentiel de ce qui vaut d’être su sur cet adaptateur, ce sont les endroits où cette liaison peut se tromper en silence
Comment exécuter Tesseract en process depuis Delphi avec HotPDF ?
Exécuter Tesseract en process avec HotPDF tient en un appel de factory dans l’unité HPDFTesseractRecognition et le même appel ApplyLoadedOCRTextLayer qu’utilise tout moteur OCR HotPDF. La factory valide tôt. Le fichier DLL et le dossier tessdata doivent exister, l’identifiant de langue ne peut contenir que des lettres ASCII, des chiffres, _ et +, chaque modèle d’une combinaison telle que chi_sim+eng doit avoir un fichier .traineddata correspondant, et les 21 exports requis doivent tous se résoudre avant que le moteur ne soit renvoyé. Les erreurs de configuration lèvent EArgumentException ; une DLL qui échoue au chargement lève EOSError avec le code d’erreur Windows et une astuce de vérifier architecture et dépendances
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Une application Win64 exige une DLL 64 bits ; les DLL de dépendances à côté
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Une liste de pages vide veut dire toutes les pages ; pages avec texte déjà sautées
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default règle PageSegMode sur tpsAuto, EngineMode sur temDefault, TimeoutMilliseconds sur 60 000 et MaxPixels sur 16 777 216. Le budget de pixels compte plus qu’il n’y paraît. Une page US Letter aux 300 DPI par défaut se rend en 2 550 × 3 300 pixels, environ 8,4 millions, ce qui tient. La même page à 600 DPI fait 5 100 × 6 600, environ 33,7 millions, et l’adaptateur la refuse avant que Tesseract ne voie un pixel. Montez MaxPixels (le plafond est 67 108 864) ou laissez le DPI où il est ; chaque côté est en plus plafonné à 32 767 pixels
La DLL est chargée avec LoadLibraryEx et les drapeaux de recherche du propre dossier de la DLL plus les répertoires sûrs par défaut, si bien que les bibliothèques d’images dont Tesseract dépend peuvent vivre à côté sans toucher au PATH ni au répertoire courant. HotPDF n’embarque ni ne télécharge aucun runtime ou modèle OCR ; vous provisionnez les deux
Qu’est-ce qui change par rapport à l’adaptateur tesseract.exe ?
L’adaptateur DLL échange l’isolation de processus contre une sortie plus riche et un coût par page plus bas. Les deux adaptateurs se branchent sur le même pipeline de couche de texte, donc la cartographie de coordonnées, le filtrage par confiance et le commit tout-ou-rien sont identiques ; ce qui diffère, c’est la façon dont les pixels entrent et les mots sortent
| Aspect | Adaptateur tesseract.exe | Adaptateur DLL Tesseract |
|---|---|---|
| Factory | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Pixels en entrée | Fichier BMP dans un répertoire temporaire privé | Tampon en niveaux de gris 8 bits en mémoire |
| Mots en sortie | TSV au niveau du mot, plafonné à 64 Mio | Itérateur de résultats, UTF-8 par mot |
| Baselines | Indisponibles | Transmises depuis TessPageIteratorBaseline |
| Segmentation de page et mode moteur | Segmentation automatique seulement | THPDFTesseractPageSegMode, THPDFTesseractEngineMode |
| Timeout | Dur : le processus enfant est terminé | Coopératif : Tesseract doit s’en apercevoir |
| Isolation de crash et mémoire | Processus séparé | Aucune, partage votre espace d’adressage |
Un coût ne disparaît pas. Chaque appel Recognize crée sa propre instance d’API et appelle TessBaseAPIInit2, si bien que les modèles de langue sont initialisés par page plutôt qu’une fois par moteur. Le cache de fichiers du système adoucit le rechargement, mais sur de grands ensembles de modèles multilingues ça reste le coût fixe dominant par page, et ça compte contre l’échéance de reconnaissance. Le moteur DLL RapidOCR en process prend le design opposé et garde ses modèles ONNX résidents pour la durée de vie du moteur ; les problèmes de frontière (ABI C, tampons empruntés, travail natif ininterruptible) sont de la même famille
Pourquoi Delphi ne peut-il pas copier la structure moniteur de Tesseract ?
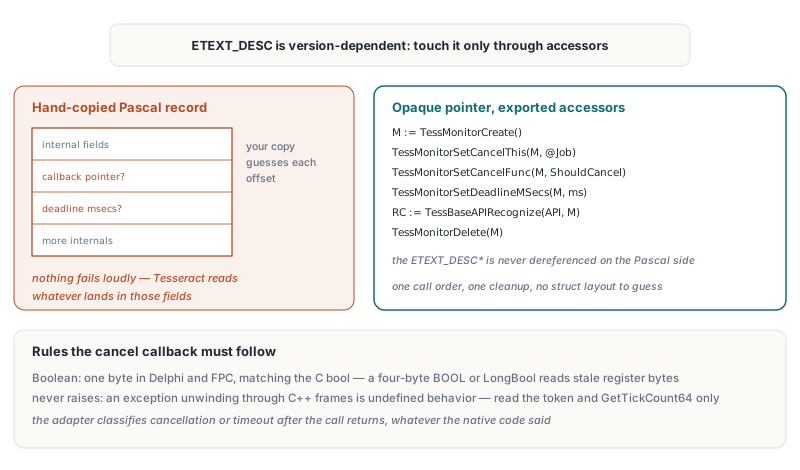
Delphi ne peut pas refléter en toute sécurité le moniteur de progression de Tesseract parce que ETEXT_DESC contient des champs internes dépendants de la version, si bien qu’un record copié à la main place le callback d’annulation et l’échéance aux mauvais offsets sur certains builds. Rien n’échoue bruyamment quand ça arrive. Tesseract lit simplement votre pointeur de callback dans un champ qui contient désormais autre chose, ou ne voit jamais l’échéance du tout
HotPDF traite donc le moniteur comme un pointeur opaque et n’y touche qu’à travers des fonctions exportées : TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs et TessMonitorDelete. Si vous liez l’API C vous-même pour un autre usage, le même motif s’applique. Le croquis ci-dessous est votre propre code de liaison, pas une API HotPDF, et reflète les déclarations que HotPDF utilise en interne
type
  // C : typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, jamais déréférencé
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Tourne sur la pile de Tesseract : lisez drapeaux et horloge, ne levez jamais
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Usage, avec les pointeurs de fonctions résolus par GetProcAddress :
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Deux détails de ce croquis sont délibérés. Le callback renvoie un Boolean, qui fait un octet en Delphi comme en Free Pascal, à l’image du bool C de TessCancelFunc. Le BOOL Windows à quatre octets ou le LongBool Delphi paraissent interchangeables et ne le sont pas : quand un côté écrit un seul octet et que l’autre en lit quatre, les octets hauts du registre de retour valent ce qui y restait, et un false peut arriver en true. Le même en-tête complique encore les choses, parce que des fonctions comme TessPageIteratorBoundingBox renvoient un int, que HotPDF déclare en Integer. Lisez le type C de chaque valeur de retour au lieu de supposer une convention unique pour toute l’API
Le second détail est que le callback ne lève jamais. Une exception Delphi se déroulant à travers les frames C++ de Tesseract est un comportement indéfini, si bien que le callback de HotPDF ne lit que le token d’annulation et une valeur GetTickCount64 monotone. L’adaptateur transforme le résultat en diagnostic d’annulation ou de timeout après le retour de TessBaseAPIRecognize, et il fait ce contrôle quel que soit le code de retour natif
Quels pointeurs natifs le côté Delphi possède-t-il ?
L’adaptateur DLL Tesseract de HotPDF possède trois objets natifs par requête, l’instance d’API, le moniteur et l’itérateur de résultats, et emprunte tout le reste. Chaque appel Recognize crée son propre jeu et le libère dans un bloc finally : TessResultIteratorDelete, puis TessMonitorDelete, puis TessBaseAPIDelete. Libérer l’interface du moteur décharge la bibliothèque
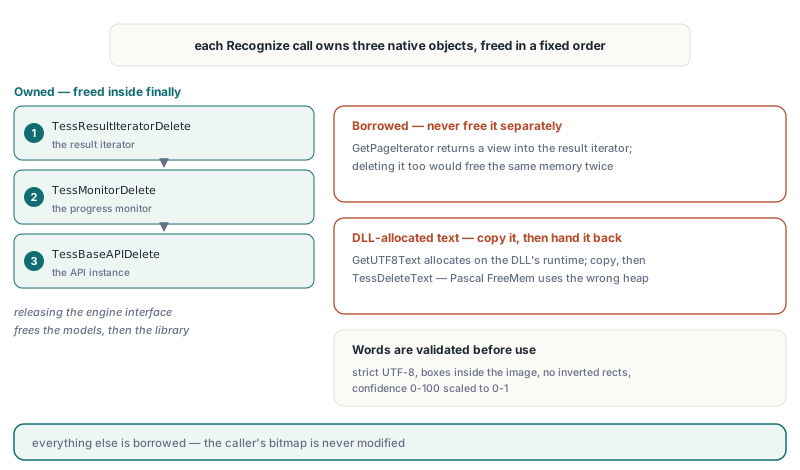
TessResultIteratorGetPageIteratorrenvoie une vue empruntée dans l’itérateur de résultats, pas un nouvel objet. HotPDF s’en sert pourTessPageIteratorBoundingBoxetTessPageIteratorBaselineet ne la libère jamais ; la supprimer séparément libérerait deux fois la même mémoireTessResultIteratorGetUTF8Textrenvoie une chaîne allouée par le runtime propre de la DLL. HotPDF la copie et la rend viaTessDeleteTextdans un blocfinally; unFreeMemPascal la libérerait sur le mauvais tas- Le texte des mots est décodé avec une validation UTF-8 stricte et contrôlé en longueur avant conversion. Les mots avec caractères de contrôle, UTF-8 mal formé, boîtes hors de l’image, rectangles inversés ou confiance hors de 0–100 font échouer la requête au lieu d’être rafistolés en silence
- Le texte total par requête est plafonné à 1 048 576 unités de code UTF-16, et le compte de mots doit tenir dans le budget de requête transmis par
ApplyLoadedOCRTextLayer
La confiance arrive en 0–100 et est ramenée à 0–1, si bien que THPDFOCRTextLayerOptions.MinimumConfidence veut dire la même chose pour chaque moteur. Quand Tesseract rapporte une baseline, les deux extrémités sont transmises ; sinon le pipeline de couche de texte retombe sur son estimation géométrique, exactement comme pour une entrée TSV
Pourquoi valider un enum avant qu’il atteigne la DLL ?
HotPDF copie l’ordinal brut de PageSegMode et EngineMode dans un Integer avant le contrôle de bornes, parce qu’un compilateur peut supposer qu’une variable enum détient toujours une valeur déclarée et replier Ord(X) > Ord(High(T)) en un constant false. Les ordinaux ne sont pas décoratifs : THPDFTesseractPageSegMode suit la numérotation de segmentation de page de Tesseract de 0 à 13, THPDFTesseractEngineMode suit la numérotation des modes moteur de 0 à 3, et les deux vont à la DLL comme de simples entiers. Un record d’options construit avec FillChar, rempli depuis un flux, ou passé depuis C++Builder avec un entier casté peut porter un octet comme 200. Valider l’ordinal copié transforme ça en EArgumentException au moment de la factory au lieu d’un mode indéfini à l’intérieur du code natif. La factory rejette aussi tpsOSDOnly et tpsAutoOnly, qui ne produisent aucun mot, et exige osd.traineddata pour tpsAutoOSD et tpsSparseTextOSD
Que garantit réellement le timeout de reconnaissance ?
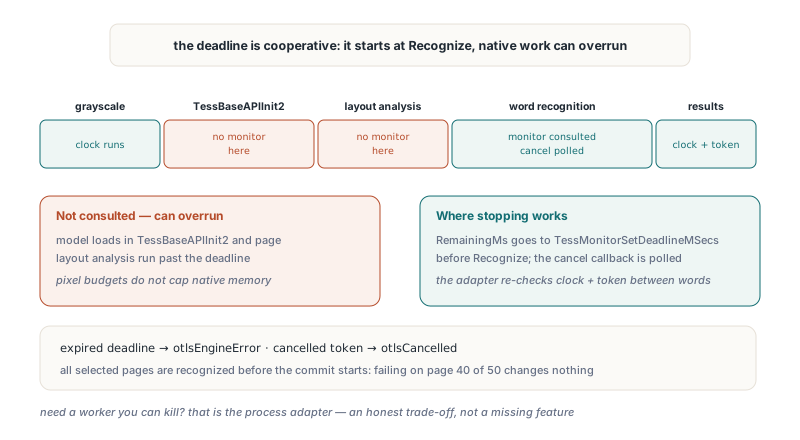
Le timeout de la DLL Tesseract est coopératif : HotPDF peut arrêter son propre travail et demander à Tesseract de s’arrêter, mais il ne peut pas forcer le code natif à revenir. L’horloge démarre quand Recognize commence, si bien que la conversion du bitmap et l’initialisation des modèles consomment le même budget que la reconnaissance. HotPDF vérifie le temps écoulé et le token d’annulation pendant la conversion en niveaux de gris et entre les mots pendant le parcours des résultats, et passe les millisecondes restantes à TessMonitorSetDeadlineMSecs avant d’appeler TessBaseAPIRecognize
La brèche est à l’intérieur de l’appel natif. Le moniteur de Tesseract est consulté pendant la reconnaissance de mots, pas pendant TessBaseAPIInit2 ni l’analyse de mise en page, si bien qu’un chargement de modèle lent ou une mise en page pathologique peut dépasser l’échéance avant que le timeout ne soit rapporté. Les budgets de pixels et de sortie ne plafonnent pas non plus la propre consommation mémoire de la bibliothèque native. Si vous avez besoin d’un worker que vous pouvez tuer, utilisez l’adaptateur process ; c’est le compromis honnête, pas une fonctionnalité manquante
La segmentation de page est l’endroit où l’adaptateur DLL se rentabilise sur les entrées difficiles. Les formulaires, étiquettes et tableaux scannés aux champs éparpillés se reconnaissent souvent mieux avec tpsSparseText qu’avec la segmentation automatique, qui essaie d’assembler des colonnes et des paragraphes qui n’existent pas
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // champs éparpillés, pas d’assemblage de colonnes
  TessOptions.EngineMode := temLSTMOnly;     // exige les modèles LSTM dans tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // inclut l’initialisation des modèles
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Un timeout se manifeste en otlsEngineError avec le diagnostic Tesseract DLL OCR timed out, tandis qu’un token annulé se manifeste en otlsCancelled. Dans les deux cas, ApplyLoadedOCRTextLayer a reconnu chaque page sélectionnée avant de démarrer la transaction de commit, si bien qu’un échec à la page 40 sur 50 laisse le document chargé exactement comme il était. Notez que tpsSingleLine, tpsSingleBlock et tpsSparseText ne changent que la segmentation ; aucun ne redresse un scan penché
Free Pascal et Lazarus : pixels périmés et chinois perdu
Les deux factories Tesseract marchent dans les builds Windows Free Pascal et Lazarus Win32 et Win64 depuis v2.772.1, après deux corrections propres à FPC. Rebuildez d’abord le paquet Lazarus pour l’architecture cible ; le portage général est traité dans HotPDF sous Free Pascal et Lazarus Win64
La première correction concerne les pixels. Un TBitmap LCL écrit par scanlines peut mettre à jour son image brute sans rafraîchir le handle de bitmap Windows, si bien que GetDIBits sur ce handle renvoie les anciens pixels. Le symptôme était déroutant : du texte dessiné directement sur un bitmap était reconnu, tandis qu’une page rendue par le moteur PDF de HotPDF produisait une liste de mots vide. Côté FPC, l’adaptateur lit désormais un instantané conscient du format via CreateIntfImage, qui respecte le format de pixels et l’ordre des lignes de l’image brute. Le build Delphi garde le chemin GetDIBits sur une copie privée 24 bits. Aucun des deux builds ne modifie le bitmap de l’appelant
La seconde correction appartient à l’adaptateur tesseract.exe. Le TStringList de FPC stocke des chaînes ANSI, si bien qu’affecter du texte TSV UTF-8 décodé à Lines.Text abandonnait en silence chaque caractère chinois ou hors plan multilingue que la page de code ANSI du système ne pouvait pas représenter. Le chemin FPC garde désormais le TSV en octets UTF-8, retire le BOM au niveau octet et décode chaque mot en UnicodeString individuellement. L’adaptateur DLL n’a jamais eu ce problème parce qu’il décode chaque mot directement depuis l’itérateur
Aide-mémoire
- Factory :
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options])dansHPDFTesseractRecognition, ajoutée en v2.772.0, support FPC en v2.772.1 - Défauts :
tpsAuto,temDefault, 60 000 ms, 16 777 216 pixels ; plage de timeout 1–3 600 000 ms, plafond de pixels 67 108 864 - Faites correspondre la bits de la DLL à l’application et placez les DLL de dépendances à côté de la DLL Tesseract
- Traitez le moniteur comme opaque ; ne copiez jamais
ETEXT_DESCdans un record Pascal - Déclarez le callback d’annulation
cdeclavec un résultatBooleand’un octet, et ne laissez jamais une exception s’en échapper - Libérez le texte de l’itérateur avec
TessDeleteText; ne libérez jamais l’itérateur de page obtenu depuis l’itérateur de résultats - Attendez-vous à une échéance coopérative : initialisation des modèles et analyse de mise en page peuvent la dépasser
- Utilisez l’adaptateur tesseract.exe quand vous avez besoin d’une terminaison dure ou d’une isolation de crash
L’adaptateur DLL Tesseract, les adaptateurs process et le moteur OCR intégré se livrent tous avec le composant HotPDF Delphi PDF pour Delphi, C++Builder et Free Pascal ; voyez la page produit HotPDF pour les éditions et les téléchargements