TerminateThread a l’air du moyen évident d’arrêter un appel OCR qui tourne sur une page scannée depuis plus longtemps que votre interface n’est prête à attendre. La documentation Windows explique pourquoi ce n’en est pas un : si le thread ciblé tient le verrou de tas du processus, ce verrou n’est jamais libéré, et la prochaine allocation sur n’importe quel autre thread peut bloquer pour toujours. Une fois l’OCR dans votre propre processus, le seul arrêt sûr est coopératif, à des points de contrôle entre les étapes d’inférence, et c’est le prix du chargement des modèles ONNX une seule fois en les gardant chauds
L’alternative que la plupart des équipes Delphi essaient d’abord est un processus enfant. Un worker Python par page peut être tué à tout moment, ce qui est séduisant, mais chaque appel démarre un interpréteur, importe son runtime, et charge les modèles de détection et de reconnaissance avant de lire un pixel. Imaginez un job d’archive de 500 pages : ce travail de démarrage s’exécute 500 fois, et le déploiement inclut désormais un environnement Python à côté d’un exécutable natif
Un PDF cherchable depuis des scans avec HPDFCreateRapidOCRDLLOCREngine
HotPDF exécute RapidOCR en process via HPDFCreateRapidOCRDLLOCREngine, déclarée dans l’unité HPDFRapidOCRRecognition. La factory charge HotPDFRapidOCR.dll, initialise une seule fois les modèles ONNX de détection, de classification d’angle optionnelle et de reconnaissance, et renvoie un IHPDFOCREngine. Ce moteur se branche sur THotPDF.ApplyLoadedOCRTextLayer exactement comme les autres moteurs OCR : le document rend chaque page, la DLL exécute l’inférence CPU dessus, et le résultat est validé comme couche de texte Unicode invisible. Pas de Python, pas de processus enfant. L’adaptateur est livré pour les builds Delphi, C++Builder et FPC/Lazarus sous Windows
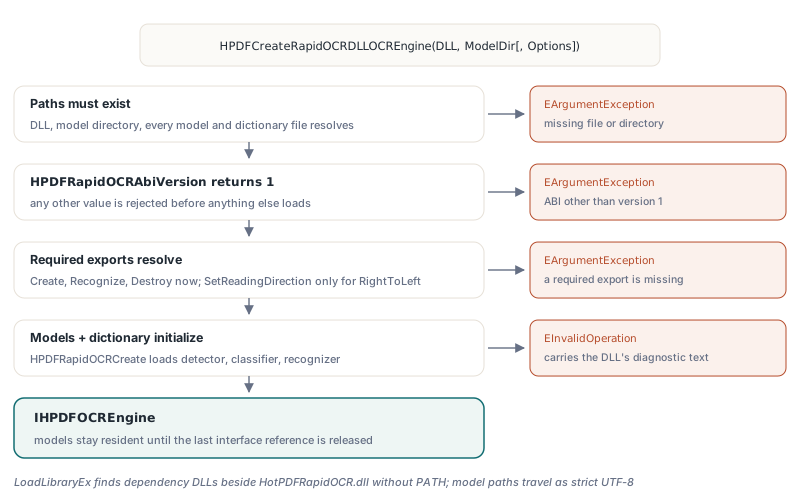
La validation a lieu dans la factory, avant que toute page ne soit touchée. Chaque fichier modèle et dictionnaire doit se résoudre, HPDFRapidOCRAbiVersion doit renvoyer 1, et les exports requis doivent exister avant que HPDFRapidOCRCreate ne construise les modèles. Les erreurs de configuration lèvent EArgumentException ; un modèle qui refuse de se charger lève EInvalidOperation avec le diagnostic propre de la DLL, par exemple un dictionnaire qui ne correspond pas au modèle de reconnaissance
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Les modèles se chargent ici, hors de toute échéance de reconnaissance.
  // Les noms relatifs de THPDFRapidOCRDLLOptions.Default se
  // résolvent par rapport au dossier de modèles
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // liste de pages vide = toutes les pages ; SkipPagesWithText est vrai par défaut
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default désigne ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx et ppocr_keys_v1.txt, avec un thread CPU, une limite d’entrée de 16 777 216 pixels et une échéance de 60 000 ms par appel de reconnaissance. Pour les autres scripts, THPDFRapidOCRDLLOptions.ForLanguage garde ces défauts et échange contre <profile>/recognition.onnx plus <profile>/dictionary.txt pour l’un des neuf profils, du chinois traditionnel et du cyrillique à l’arabe et au devanagari. Chaque moteur lit une langue ; choisissez le profil par page ou par document. La raison pour laquelle le modèle et le dictionnaire voyagent toujours en paire est traitée dans les modèles multilingues RapidOCR et les dictionnaires CTC dans HotPDF
Le moteur se déclare comme RapidOCR (native DLL) dans Info.EngineName. Journalisez cette chaîne. Quand le même service fait aussi tourner l’adaptateur process OCR Tesseract externe ou le moteur OCR intégré à appariement de gabarits, c’est le moyen le plus rapide de savoir quel reconnaisseur a produit une page mauvaise
Pourquoi l’ABI C ne parle-t-elle qu’en int32_t et octets UTF-8 ?
La frontière HotPDFRapidOCR.dll utilise des entiers à largeur fixe, des pointeurs bruts et des longueurs en octets explicites, parce que Delphi, C++Builder et Free Pascal ne partagent rien avec MSVC au-delà de la convention d’appel C. Une std::string, un std::vector ou une exception C++ transporte une disposition mémoire et un modèle de déroulement qui appartiennent à un compilateur et à une bibliothèque runtime donnés, et laisser l’un d’eux traverser vers du code Pascal finit en pile corrompue ou en bloc de tas libéré par le mauvais allocateur
La version d’ABI 1 tient en une courte liste de règles. Chaque export est cdecl et renvoie un statut int32_t : 1 pour le succès, 0 pour l’échec. Toute fonction qui peut échouer prend un tampon de diagnostic dont l’appelant est propriétaire et sa taille en octets, et la DLL y écrit un message UTF-8 terminé par NUL et tronqué pour tenir. À l’intérieur de la DLL, chaque corps d’export est dans un try avec à la fois catch (const std::exception &) et catch (...). Une erreur ONNX Runtime, une assertion OpenCV ou un dictionnaire malformé devient statut 0 plus texte
| Export | Rôle | Quand l’adaptateur le résout |
|---|---|---|
HPDFRapidOCRAbiVersion | Renvoie 1 ; toute autre valeur est rejetée | Juste après le chargement de la DLL |
HPDFRapidOCRCreate | Charge les modèles de détection, de classification optionnelle, de reconnaissance et le dictionnaire | Dans la factory |
HPDFRapidOCRRecognize | Traite un bitmap et émet un callback par ligne de texte | Dans la factory |
HPDFRapidOCRDestroy | Libère l’instance de modèles | Dans la factory |
HPDFRapidOCRSetReadingDirection | Ordre de lignes droite à gauche optionnel | Seulement quand RightToLeft est activé |
L’export de sens de lecture est résolu paresseusement à dessein, si bien qu’une DLL construite sans lui sert quand même toute requête gauche à droite. L’adaptateur charge la bibliothèque avec LoadLibraryEx et des flags de recherche qui couvrent le propre dossier de la DLL plus les répertoires sûrs par défaut ; des dépendances ONNX Runtime ou OpenCV placées à côté de HotPDFRapidOCR.dll se trouvent sans toucher PATH. Les chemins de modèles et de dictionnaires traversent la frontière en UTF-8, et la DLL les convertit avec MultiByteToWideChar en mode strict avant d’ouvrir les fichiers via les API à caractères larges. Un répertoire de modèles sous C:\Users\Łukasz ou un nom d’utilisateur cyrillique s’ouvre normalement
Une règle vit dans les fichiers de build plutôt que dans l’en-tête. La DLL lie ONNX Runtime et OpenCV statiquement, et le projet CMake choisit par défaut la CRT release statique (/MT). Mélangez avec des bibliothèques statiques compilées contre /MD et vous récoltez des erreurs d’édition de liens si vous avez de la chance, deux tas indépendants sinon. Provisionnez des bibliothèques construites pour le même mode CRT que la DLL
Que se passe-t-il entre un TBitmap et une ligne de texte ?
HotPDF remet à la DLL une copie BGR de haut en bas indépendante de la page rendue, et la DLL renvoie un callback par ligne reconnue. Le texte de ce callback est emprunté : le pointeur n’est valable que jusqu’au retour du callback, si bien que l’adaptateur le copie sur place
Côté Delphi, l’instantané vient d’un TBitmap privé forcé en pf24bit et lu avec GetDIBits en utilisant un biHeight négatif. Cela donne des lignes de haut en bas alignées sur quatre octets, et le stride voyage vers la DLL en argument explicite. Côté FPC, l’adaptateur lit via CreateIntfImage. Le bitmap de l’appelant n’est jamais modifié. Les contrôles de taille s’exécutent avant l’allocation de la copie : au plus 32 767 pixels par côté, et pas plus de MaxPixels au total, à 16 777 216 par défaut et montable à 67 108 864
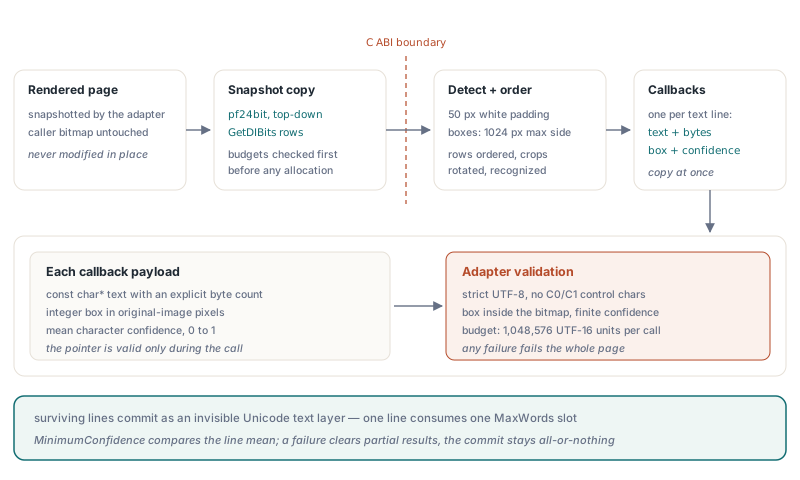
À l’intérieur de la DLL, l’image reçoit une bordure blanche de 50 pixels, les régions de texte sont détectées avec le grand côté réduit à 1 024 pixels au plus, et les boîtes sont triées en lignes horizontales. Avec le classificateur d’angle activé, une découpe n’est tournée de 180 degrés que si le score tête-en-bas dépasse 0,9, ce qui empêche une prédiction faible de retourner des mots courts. Chaque ligne arrive ensuite comme un const char*, un compte d’octets, une boîte entière en pixels de l’image d’origine et la confiance moyenne des caractères. L’adaptateur est strict sur ce qu’il accepte :
- L’UTF-8 est décodé avec
MB_ERR_INVALID_CHARS, si bien qu’une séquence d’octets malformée fait échouer la page au lieu de planter des caractères de remplacement dans une couche cherchable - Les caractères de contrôle C0 et C1 sont rejetés ; les lignes ne contenant que des espaces sont sautées
- La boîte doit tenir dans le bitmap, et la confiance doit être une valeur finie de 0 à 1
- Le texte compte dans le
MaxTextCodeUnitsde la requête, avec un plafond dur de 1 048 576 unités UTF-16 par appel ; les caractères hors du plan multilingue de base coûtent deux unités - Une exception Pascal à l’intérieur du callback y est attrapée, stockée et transformée en retour 0, ce qui arrête la DLL ; le message stocké devient
Info.Diagnostic
Deux de ces détails comptent quand vous réglez la sortie. L’unité est la ligne, pas le mot : chaque ligne prend un emplacement MaxWords, Info.AcceptedWordCount et Info.DroppedWordCount comptent des lignes, et un résultat de recherche met en surbrillance toute la boîte de la ligne. Et MinimumConfidence est comparé à la confiance moyenne des caractères de la ligne, si bien qu’un caractère taché parmi vingt propres fait rarement couler la ligne. Monter le seuil à 0,7 ou 0,8 abandonne des lignes entières, jamais des caractères isolés. Une page vide réussit avec zéro ligne, et tout échec jette les résultats partiels pour que le commit multipage reste tout-ou-rien
Un moteur, une copie des modèles, un appelant à la fois
Chaque moteur DLL RapidOCR possède exactement une instance de modèles pour toute sa durée de vie, et les appels Recognize sur ce moteur sont sérialisés par une section critique. C’est détenir la référence IHPDFOCREngine qui garde les modèles en mémoire, si bien que le travail par lots doit créer le moteur une fois et le réutiliser sur chaque document
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // scans droits : aucun modèle classificateur chargé
  Models.Threads := 4;                   // 1..64, borné aux processeurs actifs
  Models.TimeoutMilliseconds := 120000;  // par appel Recognize, coopératif
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // dernière référence libérée : modèles détruits, puis DLL déchargée
Threads règle à la fois les comptes de threads intra-op et inter-op de chaque session ONNX du moteur, et la DLL le borne au nombre de processeurs actifs. Deux threads partageant un moteur n’exécutent jamais l’inférence en parallèle ; le second attend. Cette attente n’est pas un EnterCriticalSection aveugle. L’adaptateur tente le verrou avec TryEnterCriticalSection, dort 25 ms entre les tentatives, et vérifie à chaque fois le token d’annulation et l’échéance, si bien qu’une requête en file peut toujours être annulée
L’horloge de l’échéance démarre à l’entrée dans Recognize, avant la prise du verrou. Le temps passé en file derrière une autre page compte dans TimeoutMilliseconds. Avec quatre threads workers sur un moteur et une échéance de 60 secondes, la quatrième page peut expirer sans jamais atteindre le modèle. Donnez plutôt à chaque worker son propre moteur. Cela coûte une copie des modèles en mémoire par moteur, et cette mémoire achète des timeouts prévisibles et du parallélisme réel ; partager un seul moteur n’a de sens que quand les requêtes sont assez rares pour ne presque jamais faire la file
Pourquoi un appel OCR natif ne peut-il pas être tué en pleine inférence ?
Un appel RapidOCR natif ne peut pas être tué en pleine inférence parce qu’il tourne sur votre thread, dans votre processus, au milieu d’une session ONNX Runtime qui n’offre aucune API d’interruption pour un Run en cours. L’annulation dans l’adaptateur DLL est coopérative. La DLL appelle un callback d’abandon avant et après la détection, après la classification de chaque découpe, et après chaque ligne reconnue, et s’arrête au premier point de contrôle où le callback renvoie 0. Un Run déjà commencé finit d’abord
Les options forcées sont pires qu’attendre. TerminateThread laisserait le verrou de tas du CRT, le thread pool d’ONNX Runtime et tout état OpenCV dans la condition qui est la leur au moment du tir. Appeler FreeLibrary pendant qu’un appel s’exécute encore décharge du code qui est sur la pile. Ni l’un ni l’autre ne peut être rendu sûr, donc l’adaptateur ne tente jamais. Une échéance expirée revient en otlsEngineError avec un diagnostic de dépassement ; un token annulé revient en otlsCancelled :
// Le token est créé par l’appelant et partagé avec le thread UI,
// qui appelle Token.Cancel quand l’utilisateur appuie sur Stop
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // arrêté au prochain point de contrôle d’étape ou de ligne ; document inchangé
        Writeln('Cancelled');
      otlsEngineError:
        // inclut une échéance coopérative expirée et les diagnostics natifs
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // une limite de page, pixel, mot ou contenu dans Options a été atteinte
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
C’est le vrai compromis entre les adaptateurs process et la DLL en process, et aucun des deux ne gagne toutes les lignes :
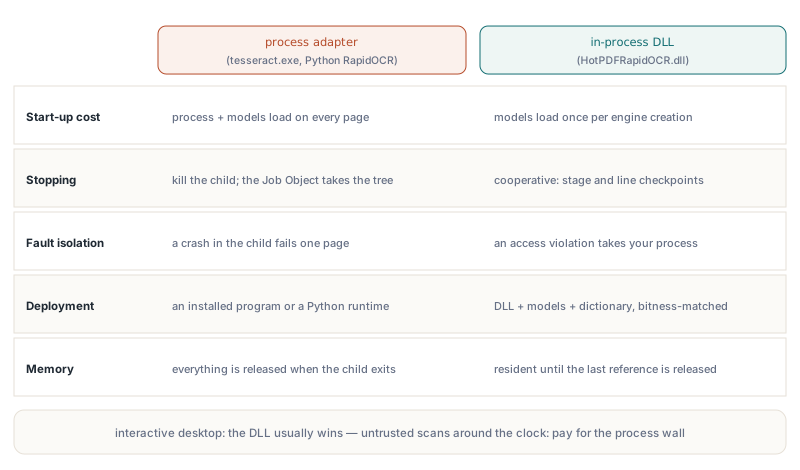
- Coût de démarrage : les adaptateurs Tesseract et RapidOCR Python lancent un processus et chargent les modèles pour chaque page ; la DLL charge les modèles une fois par moteur
- Arrêt : un processus enfant peut être terminé carrément, et le worker Python tourne dans un Job Object kill-on-close pour que tout son arbre de processus parte avec lui ; la DLL s’arrête aux points de contrôle d’étape et de ligne
- Confinement des pannes : un crash de
tesseract.exefait échouer une page ; une violation d’accès à l’intérieur de la DLL emporte votre processus - Déploiement : les adaptateurs process ont besoin d’un programme installé ou d’un environnement Python ; la DLL a besoin d’elle-même, de ses modèles et de son dictionnaire, appariés à l’architecture de l’application
- Mémoire : un adaptateur process libère tout quand l’enfant se termine ; un moteur DLL garde ses modèles résidents jusqu’à ce que la dernière référence d’interface disparaisse
Choisissez la DLL pour une application bureau interactive qui OCRise une page à la fois et a besoin d’un bouton Stop réactif qui revient en moins d’une étape d’inférence. Pour un serveur qui avale des scans non fiables jour et nuit, payez le coût de démarrage par page et gardez la frontière de processus ; une image forgée qui fait planter un reconnaisseur ne doit coûter qu’une page, et avec un processus enfant c’est le cas
Construire HotPDFRapidOCR.dll et choisir les modèles
HotPDFRapidOCR.dll se construit depuis les sources C++ de Native/RapidOCR avec MSVC, C++17, un Windows SDK et CMake 3.20 ou plus récent. Le helper tools/Build-HotPDFRapidOCR.ps1 prend le répertoire des sources natives, d’ONNX Runtime et d’OpenCV plus -Platform Win32 ou Win64, et écrit le résultat dans Lib/Native/RapidOCR/<Platform>/. Construisez les deux si vous livrez les deux. Une application Delphi 32 bits ne peut pas charger une DLL 64 bits, et les bibliothèques statiques que vous provisionnez doivent correspondre à l’architecture cible ainsi qu’au mode CRT
Les modèles ont leurs propres règles de compatibilité. Le détecteur est un détecteur de texte DB. Le reconnaisseur accepte les modèles CTC en agencement NCHW avec une hauteur d’entrée fixe de 32 ou 48, et utilise 48 quand le modèle déclare une hauteur dynamique. Le format de modèle doit être l’un de ceux que l’ONNX Runtime lié statiquement comprend ; des exports plus récents comme PP-OCRv5 peuvent exiger un runtime plus récent, et un modèle illisible échoue à l’initialisation avec un diagnostic. tools/Install-RapidOCRModels.ps1 installe des packs PP-OCRv3 et PP-OCRv4 vérifiés contre des hash SHA256 épinglés, avec un détecteur et un classificateur partagés sous les noms de fichiers qu’attend Default. Restez sur ces packs à moins de contrôler aussi le build du runtime
Le dictionnaire doit être en UTF-8 sans BOM, dans exactement l’ordre de caractères du modèle, et son compte d’entrées doit correspondre aux classes de sortie du modèle. Les fins de ligne CRLF conviennent. Quand un modèle embarque sa propre liste de caractères en métadonnées, l’initialisation du modèle compare chaque entrée et sa position au fichier dictionnaire, si bien qu’un dictionnaire qui a juste la bonne longueur échoue quand même. La DLL ne télécharge jamais un modèle manquant
HotPDF livre l’adaptateur RapidOCR natif avec les adaptateurs OCR process, le moteur de rendu de pages qui les alimente et l’écrivain de couche de texte Unicode invisible, le tout dans un composant VCL natif unique pour Delphi et C++Builder. Pour les logiciels de capture et d’archivage qui doivent produire du PDF cherchable sur des machines sans Python installé, le composant HotPDF Delphi PDF ne laisse à déployer que la DLL et ses fichiers de modèles