Faites passer une facture russe dans un reconnaisseur qui charge le modèle cyrillique mais lit toujours le dictionnaire de caractères chinois, et vous récupérez des rangées de caractères Han parfaitement valides. Chaque ligne est de l’UTF-8 bien formé, chaque ligne atterrit dans la couche de texte cherchable, et une recherche sur n’importe quel mot imprimé de la page ne trouve rien. Le modèle a fait son travail. Un reconnaisseur CTC ne produit jamais de caractères, seulement des numéros de classes, et le fichier dictionnaire est la seule chose qui associe la classe 1 204 à un glyphe
Trois défaillances proches parentes se cachent à côté, et une démo en écriture latine ne montre aucune d’entre elles : chaque ligne qui perd son dernier caractère, du texte anglais qui arrive sans espacement entre les mots, et des boîtes de texte arabes rendues dans l’ordre gauche à droite. Chacune remonte à une règle de dictionnaire, une frontière de boucle ou un ordre de tri facile à obtenir presque juste. Les quatre démarrent au même endroit : l’étape qui transforme un tag de langue en un modèle et un dictionnaire
Profils de langue RapidOCR dans HotPDF : un tag, une paire épinglée
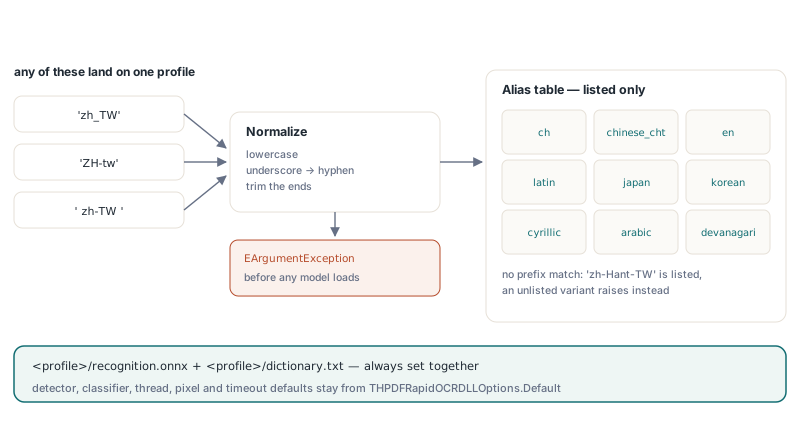
Dans HotPDF, THPDFRapidOCRDLLOptions.ForLanguage transforme un tag de langue en options qui pointent vers <profile>/recognition.onnx et <profile>/dictionary.txt sous votre répertoire de modèles. Tout le reste vient de THPDFRapidOCRDLLOptions.Default : le détecteur partagé, le classificateur d’angle optionnel, un thread, un budget de 16 777 216 pixels par requête et un timeout de 60 secondes. Le tag est mis en minuscules, les underscores deviennent des tirets et les espaces environnants sont rognés, si bien que 'zh_TW', 'ZH-tw' et ' zh-tw ' aboutissent au même profil
Le rapprochement se fait contre une liste d’alias explicite, sans préfixe. 'zh-Hant-TW' et 'zh-MO' sont acceptés parce qu’ils sont listés ; 'pt-AO' ne l’est pas, et ForLanguage lève EArgumentException avant l’ouverture du moindre fichier. Cette sévérité est délibérée. Une règle par préfixe enverrait en silence 'zh-Hant-SG' ou quelque tag futur vers le profil qui partage ses deux premières lettres, et avec le chinois, les deux premières lettres ne disent pas le script
| Profil | Langues | Tags d’exemple | Ordre des boîtes dans une ligne |
|---|---|---|---|
ch | Chinois simplifié et anglais | zh, zh-CN, zh-Hans, chi_sim | Gauche à droite |
chinese_cht | Chinois traditionnel | zh-TW, zh-HK, zh-Hant, chi_tra | Gauche à droite |
en | Anglais | en, en-US, en-GB, eng | Gauche à droite |
latin | Français, allemand, espagnol, portugais, italien, néerlandais, turc | fr, de, es-419, pt-BR, tr | Gauche à droite |
japan | Japonais | ja, ja-JP, jpn | Gauche à droite |
korean | Coréen | ko, ko-KR, kor | Gauche à droite |
cyrillic | Russe, ukrainien, bulgare, biélorusse | ru, ru-RU, uk, bg | Gauche à droite |
arabic | Arabe, persan, ourdou | ar, ar-SA, fa, ur | Droite à gauche |
devanagari | Hindi, marathi, népalais | hi, mr, ne | Gauche à droite |
L’adaptateur ne télécharge jamais rien. Les fichiers modèles sont provisionnés une fois avec le helper livré avec, par exemple tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, ou -Language All pour les neuf profils. Le helper place le détecteur et le classificateur partagés aux noms de fichiers racine qu’attend Default, et chaque profil dans son propre dossier. La création de moteur, la frontière DLL et le threading sont traités dans l’article sur la DLL RapidOCR in-process ; les fichiers en place, un scan en chinois simplifié devient cherchable comme ceci
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, détecteur et classificateur partagés
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // les modèles se chargent ici ; réutilisez le moteur entre les documents
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // liste de pages vide = toutes les pages ; SkipPagesWithText laisse les pages avec texte tranquilles
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Deux nombres de cette sortie méritent une lecture attentive. Le pipeline natif produit un résultat par ligne de texte détectée, donc AcceptedWordCount compte des lignes ici, et MinimumConfidence est comparé à la confiance moyenne des caractères de la ligne entière : une ligne dont la moyenne vaut 0,45 est abandonnée d’un bloc. UniqueScalarCount donne le nombre de scalaires Unicode distincts que la couche de texte a dû associer à sa police et à sa table ToUnicode. Une page de texte chinois courant doit pousser ce chiffre bien au-delà des quelques dizaines de scalaires qu’exige une page latine ; un comptage de territoire latin sur un scan chinois signifie en général que le mauvais profil est chargé
Pourquoi ne changer que le modèle de reconnaissance produit-il du charabia ?
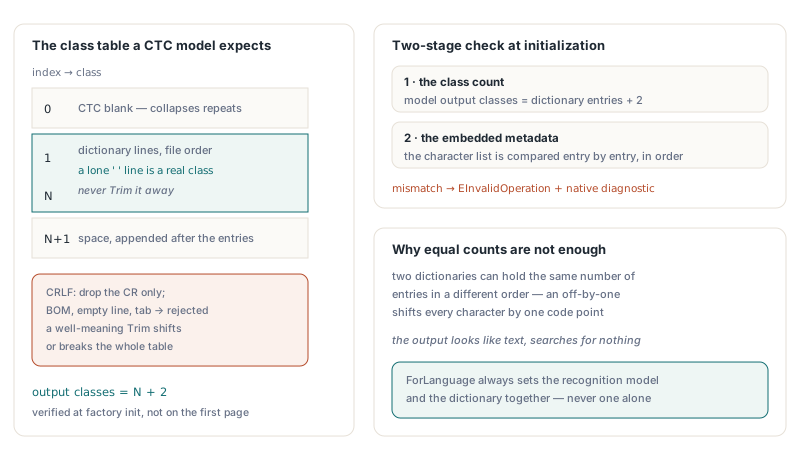
Parce que le modèle et le dictionnaire sont les deux moitiés d’une même table de correspondance, et que seul le dictionnaire sait ce que signifient les indices. Pointez RecognitionModel vers cyrillic/recognition.onnx pendant que CharacterDictionary désigne toujours le fichier chinois, et le modèle émet des indices cyrilliques valides que l’ancien dictionnaire traduit en caractères Han aléatoires. ForLanguage définit toujours les deux champs ensemble. Les options bâties à la main doivent suivre la même règle : ne jamais changer l’une sans l’autre
Le garde-fou évident, comparer la taille du dictionnaire à la largeur de sortie du modèle, est nécessaire et reste insuffisant. Deux dictionnaires peuvent avoir le même nombre d’entrées dans un ordre différent, et un décalage d’une position décale chaque caractère d’un cran. La DLL RapidOCR de HotPDF vérifie donc deux fois pendant que la factory initialise le reconnaisseur. Le compte de classes en sortie du modèle doit égaler les entrées du dictionnaire plus deux. Ensuite, si le fichier ONNX embarque une liste de métadonnées character, chaque ligne du dictionnaire est comparée à celle-ci dans l’ordre. Le moindre écart fait lever EInvalidOperation à HPDFCreateRapidOCRDLLOCREngine avec le diagnostic natif, si bien que l’erreur surgit au démarrage et non dans l’archive d’un client
Le « plus deux » vient de l’agencement des classes. La classe 0 est le blank CTC, les classes 1 à N sont les lignes du dictionnaire dans l’ordre du fichier, et la classe finale est une espace. Certains dictionnaires portent aussi leur propre entrée espace unique, et cette ligne doit survivre exactement telle quelle. C’est là qu’un Trim bien intentionné fait de vrais dégâts : il transforme l’entrée espace en chaîne vide et décale ou casse la table. La DLL retire un retour chariot final pour que les fichiers CRLF se chargent, et rejette une BOM UTF-8, une ligne vide, ou une entrée contenant une tabulation ou un retour chariot égaré
Si vous maintenez vos propres dictionnaires, un contrôle préventif dans votre script de build ou de déploiement attrape ces problèmes avant que le moteur ne le fasse. La fonction ci-dessous est votre propre code, écrit pour refléter les règles ci-dessus
// Votre propre helper, pas une API HotPDF : construit la table de classes CTC
// qu’attend un reconnaisseur et rejette les défauts de dictionnaire que rejette la DLL
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // retour à la ligne en fin de fichier
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // classe 0 : blank CTC
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF : retire seulement le CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // jamais de Trim : ' ' est une classe
  end;
  Result[Last + 2] := ' ';                       // classe finale : espace
  // Length(Result) doit égaler le compte de classes en sortie du modèle
end;
Décodage CTC glouton et ses trois pièges de frontière
Le décodage CTC glouton choisit la classe au score le plus haut à chaque pas de temps, réduit les répétitions consécutives en un seul caractère et abandonne le blank. C’est le blank qui permet à une lettre réellement doublée de survivre. Un modèle de reconnaissance lit une ligne de texte comme une séquence de fines tranches verticales, et pour chaque tranche il produit une probabilité pour chaque classe. Une ligne contenant AA中 peut produire la séquence argmax A A blank A 中 space : les deux premiers pas A se réduisent en un seul, le blank le sépare du A suivant, et la sortie est AA中 avec l’espace finale intacte. Sans la règle du blank, book et bok se décoderaient identiquement
Un décodeur trop court invite les erreurs de décalage d’une unité, et chaque erreur produit son symptôme reconnaissable. Arrêtez la boucle argmax interne une classe trop tôt et la classe espace ne peut jamais gagner, si bien que chaque ligne anglaise ou latine revient en un seul long mot et que la recherche d’expression cesse de fonctionner. Arrêtez la boucle externe un pas de temps trop tôt et le dernier caractère de chaque ligne disparaît, ce qui sur une étiquette de deux caractères fait la moitié du texte. Oubliez de laisser un blank réarmer le garde-fou de répétition et les caractères doublés se réduisent : ll dans hello, ou le redoublement 谢谢. Si vous écrivez un décodeur pour un pipeline personnalisé, ces trois cas forment un jeu de tests compact. Le décodeur HotPDF couvre la dernière classe et le dernier pas, garde les répétitions séparées par un blank, et rejette les scores non finis ou hors de 0 à 1, plus tout compte de classes en désaccord avec le dictionnaire
// Illustration pour votre propre pipeline, pas une API HotPDF : décodage CTC
// glouton avec de bonnes frontières. Scores tient Steps * Classes
// probabilités, une ligne par pas de temps
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // la classe 0 est le blank CTC
  for Step := 0 to Steps - 1 do             // inclure le dernier pas de temps
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // inclure la dernière classe (espace)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // un blank réarme le garde-fou de répétition
  end;
end;
La recherche par faisceau avec un modèle de langue peut résoudre certaines tranches ambiguës où le décodage glouton se trompe, pour un vrai coût en vitesse et un second jeu de fichiers à versionner. Pour les documents imprimés rendus à 300 DPI, le décodage glouton est le bon défaut, et le décodeur est le mauvais endroit pour compenser ce que le modèle ne voit pas. Cela vaut aussi pour les tables de substitution de caractères. Si un modèle lit une lettre accentuée comme sa lettre de base, rapiécer la sortie avec une table de remplacement répare une langue et en casse une autre. Un caractère faux dans une couche cherchable est pire qu’un caractère manquant, parce que la recherche trouve le mauvais document au lieu de n’en trouver aucun, si bien que le texte reconnu part dans le PDF exactement comme le modèle l’a produit
Comment les lignes de texte sont-elles ordonnées pour l’arabe de droite à gauche ?
La DLL trie les boîtes de texte détectées de haut en bas, regroupe les boîtes en une ligne quand elles se chevauchent verticalement d’au moins la moitié de la hauteur de la plus petite boîte, et ordonne chaque ligne de gauche à droite, ou de droite à gauche quand RightToLeft est activé. Les caractères à l’intérieur d’une ligne reconnue ne sont jamais inversés. Le regroupement en lignes compte parce que les détecteurs coupent souvent une ligne visuelle en plusieurs boîtes, une étiquette et une valeur séparées par un large écart par exemple, et un tri brut par coordonnée haute les entrelacerait avec la ligne suivante dès que leurs sommets diffèrent d’un pixel ou deux
Le profil arabe est le seul pour lequel ForLanguage définit RightToLeft := True, ce qui fait ordonner à la DLL chaque ligne selon les bords droits des boîtes, à partir de la marge droite. C’est tout l’effet. Le texte que le modèle renvoie pour une ligne est déjà en ordre logique Unicode, l’ordre dans lequel un lecteur arabe lit et tape, et c’est aussi l’ordre qu’attendent l’extraction de texte PDF et la recherche. Inverser la chaîne pour qu’elle « ait l’air juste » dans le débogueur Delphi casserait la recherche, le copier-coller et les lecteurs d’écran. L’affichage bidirectionnel et le façonnage des glyphes relèvent du visualiseur PDF
Un moteur sert un profil de langue, et il n’y a pas de détection de script automatique. Un document qui mêle des scripts a besoin d’un moteur par profil, chacun appliqué à ses propres pages. ApplyLoadedOCRTextLayer prend une liste de pages explicite et valide chaque appel comme sa propre transaction, si bien qu’un échec sur les pages arabes annule cet appel sans toucher la couche chinoise déjà écrite
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // lève EArgumentException pour un tag non listé, avant tout chargement de modèle
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // de la marge pour des pages A3 à 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // profil chinese_cht
  Arabic := CreateRapidEngine('ar-SA');   // profil arabic, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
La ligne MaxPixels est là pour une raison. Le budget par défaut de 16 777 216 pixels par requête couvre A4 et US Letter à 300 DPI avec de la marge. Une feuille A3 à 300 DPI représente environ 3508 par 4961 pixels, à peu près 17,4 millions, si bien que la requête est refusée et que Info.Diagnostic signale une requête ou un budget de pixels invalide. Montez MaxPixels jusqu’au plafond de 67 108 864, ou abaissez THPDFOCRTextLayerOptions.DPI pour les grands formats. L’ordre de droite à gauche passe par l’export DLL HPDFRapidOCRSetReadingDirection, que l’adaptateur ne recherche que quand RightToLeft est activé ; un build de la DLL sans cet export sert quand même les profils de gauche à droite, et créer un moteur arabe avec lui lève EArgumentException en nommant l’export manquant
Packs de modèles épinglés et ce qu’une paire personnalisée doit passer
La DLL RapidOCR de HotPDF lie un ONNX Runtime construit statiquement, si bien qu’elle lit les versions de format de fichier ONNX que ce runtime comprend et rien de plus récent. Des exports de modèles récents peuvent viser un format plus récent ; un tel fichier est rejeté à la création du moteur avec un diagnostic natif. Cet appariement explique pourquoi chaque pack de langue pointe vers un reconnaisseur et un dictionnaire précis qui se chargent et passent les vérifications de classes sous le runtime embarqué, et pourquoi les packs ne sont jamais « latest »
Install-RapidOCRModels.ps1 fait respecter l’appariement sur disque. Chaque fichier de son manifeste porte un hash SHA256. Un fichier existant avec un hash différent arrête l’installation et reste en place pour que vous le déplaciez ou le supprimiez, et chaque téléchargement est écrit sous un nom temporaire et ne rejoint sa position qu’une fois son hash vérifié. Cela bloque la version silencieuse du problème de dictionnaire : quelqu’un copie à la main un recognition.onnx plus récent dans un dossier de profil, le compte de classes correspond par chance, et le premier signe d’ennui est un client qui dit que la recherche ne trouve pas des mots qu’il voit parfaitement. Si vous installez avec -SkipClassifier, mettez UseAngleClassifier := False dans les options, parce que Default attend le fichier classificateur et que la création du moteur vérifie son existence
Le reconnaisseur vérifie aussi la forme d’entrée du modèle au chargement. Il accepte une entrée flottante NCHW avec une hauteur fixe de 32 ou 48 pixels, ou une hauteur dynamique, qu’il exécute à 48. Un modèle exporté avec toute autre hauteur fixe fait échouer la création du moteur avec « Unsupported recognition model input or output shape »
Pour un script qu’aucun des neuf profils ne couvre, RecognitionModel et CharacterDictionary peuvent pointer vers vos propres fichiers, et chaque vérification ci-dessus s’applique toujours. Une paire inadaptée échoue à la création du moteur, dans votre run de test. Pour les pages où aucun profil RapidOCR ne convient, l’adaptateur Tesseract pour un PDF cherchable se branche sur le même appel ApplyLoadedOCRTextLayer, et pour les formulaires ASCII imprimés par machine le moteur OCR intégré à appariement de gabarits n’a besoin d’aucun fichier modèle
Les profils de langue, l’adaptateur RapidOCR natif et la couche de texte OCR sont tous inclus dans le HotPDF Delphi PDF Component pour les projets Delphi, C++Builder et FPC/Lazarus sous Windows