Un tuyau qui ne signale jamais de fin de fichier est un bug étrange à traquer dans une fonctionnalité OCR. Un thread de votre application lit la sortie standard d'un programme auxiliaire et attend que ReadFile échoue avec ERROR_BROKEN_PIPE. Un autre thread lance tesseract.exe via CreateProcess avec bInheritHandles à True, parce que c'est ainsi qu'on remet à un processus enfant un fichier pour sa sortie d'erreurs. L'extrémité d'écriture du tuyau du helper était héritable, si bien que Tesseract détient désormais une copie, et le thread lecteur se bloque jusqu'à ce que Tesseract finisse sa page — ce qui, sur un scan à 300 DPI avec deux modèles de langue chargés, n'est pas immédiat
Un reconnaisseur externe apporte plus que le blocage : ce que l'enfant peut voir, que faire d'une sortie à moitié valide, et comment transformer des boîtes de pixels en texte PDF cherchable. Le moteur OCR intégré à appariement de gabarits couvre volontairement les lettres et chiffres ASCII imprimés par machine. Les noms accentués, les contrats chinois et les archives multilingues demandent des modèles de langue entraînés, et Tesseract est le candidat habituel parce que c'est un programme en ligne de commande que vous pouvez installer à côté de votre exécutable
Brancher Tesseract dans la couche de texte OCR de HotPDF
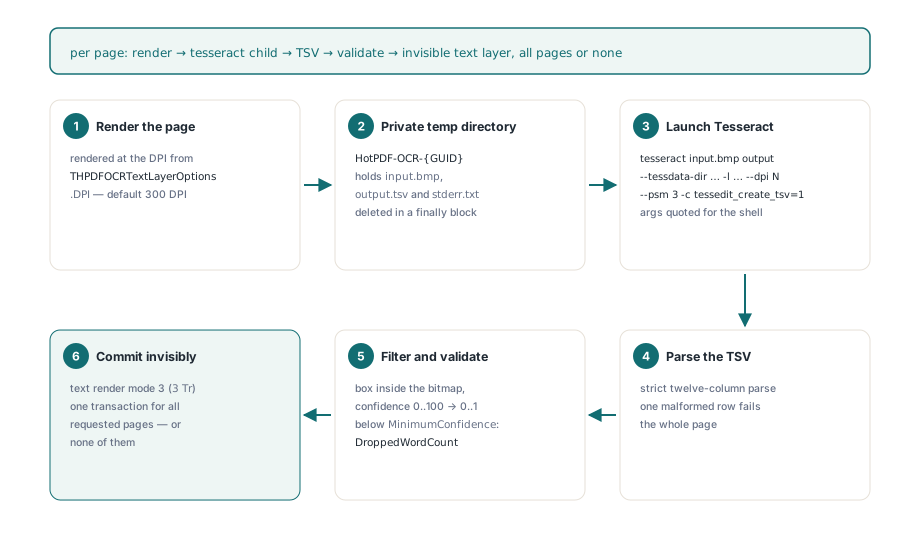
HotPDF enveloppe un exécutable Tesseract installé localement comme un IHPDFOCREngine via HPDFCreateTesseractOCREngine dans l'unité HPDFTesseractRecognition. Vous remettez ce moteur à THotPDF.ApplyLoadedOCRTextLayer, qui rend chaque page demandée, lance Tesseract une fois par page, filtre les mots et écrit une couche de texte Unicode invisible pour toutes les pages demandées en une seule transaction, ou pour aucune. La correspondance de coordonnées, la rotation, le filtrage par confiance et le commit sont le pipeline que le moteur intégré emploie déjà ; seule la reconnaissance change
La factory lève EArgumentException avant que toute page ne soit touchée. L'exécutable et le répertoire tessdata doivent exister, le timeout doit se tenir entre 1 et 3 600 000 millisecondes, et la langue ne peut contenir que des lettres ASCII, des chiffres, _ et +, parce qu'elle finit sur une ligne de commande : eng+chi_sim est légitime, une valeur avec des guillemets ou des espaces est une injection qui attend de se produire. Une seconde surcharge prend un enregistrement THPDFTesseractOptions. Son Default donne --psm 3, --oem 3, 60 secondes par page et un plafond de 16 777 216 pixels, et il rejette tpsOSDOnly et tpsAutoOnly, les deux modes qui ne renvoient aucun mot
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16 777 216 px
  TessOptions.TimeoutMilliseconds := 120000;    // vaut pour chaque page
  // lève EArgumentException pour un exécutable ou un dossier tessdata manquant,
  // un identifiant de langue mauvais, ou des options hors de leurs plages
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // modèles joints par '+'
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // une liste de pages vide signifie toutes les pages ; les pages portant déjà du texte sont sautées
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Faites l'arithmétique des pixels une fois. Une page A4 à 300 DPI fait environ 2 481 par 3 508 pixels, à peu près 8,7 millions, et passe. Une page A3 à la même résolution fait environ 3 508 par 4 961, proche de 17,4 millions, si bien qu'elle échoue avec un diagnostic de budget de pixels et que l'exécution se termine en otlsEngineError. La surcharge qui ne prend qu'un timeout n'applique aucun plafond de pixels du tout. Pour un service qui accepte des fichiers de l'extérieur, gardez la surcharge à options et montez MaxPixels (jusqu'à 67 108 864) ou abaissez délibérément THPDFOCRTextLayerOptions.DPI quand de grands formats sont attendus
Par page, le moteur crée un répertoire privé HotPDF-OCR-{GUID} sous le chemin temporaire, enregistre le bitmap comme input.bmp et lance tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, en ajoutant --oem quand un mode moteur est réglé. Les chemins sont quotés avec les règles Windows pour les antislashs et les guillemets embarqués, et --dpi porte la résolution de rendu pour que Tesseract ne la devine jamais. Tesseract et ses fichiers .traineddata ne sont pas livrés ; les provisionner est le travail de l'application. Sur nos propres machines de test Linux, le reconnaisseur tourne depuis un bundle au niveau utilisateur du binaire, de sa fermeture de bibliothèques partagées et du dossier tessdata, parce que compter sur /usr/bin/tesseract ne fonctionne que là où quelqu'un a installé le paquet système
Pourquoi une ligne TSV cassée vide-t-elle toute la page ?
L'adaptateur Tesseract fait échouer la page entière à la première ligne malformée, parce qu'une liste de mots à moitié analysée produit une couche de texte en désaccord avec l'image, et rien dans le PDF enregistré ne dit quels mots ont disparu. La sortie doit se décoder en UTF-8 strict sans NUL embarqué. La première ligne doit égaler l'en-tête à douze colonnes de Tesseract, de level à text, une fois une BOM optionnelle retirée. Chaque ligne doit se découper en exactement douze champs, et la découpe s'arrête après la onzième tabulation, si bien qu'une tabulation dans le texte reconnu atterrit dans le champ texte au lieu de créer une treizième colonne, où le contrôle des caractères de contrôle ci-dessous la rejette alors
Seules les lignes de niveau 5 sont des mots ; les lignes de page, bloc, paragraphe et ligne sont sautées, tout comme les mots vides ou purement blancs. Un mot contenant un caractère de contrôle (sous U+0020, ou de U+007F à U+009F) fait échouer la page. Le reste exige une géométrie entière, une confiance analysée avec un formatage invariant pour qu'une application en locale allemande lise quand même 93.5, une boîte entièrement dans le bitmap, et une confiance de 0 à 100. Un mot valide suivi d'une ligne cassée donne zéro mot
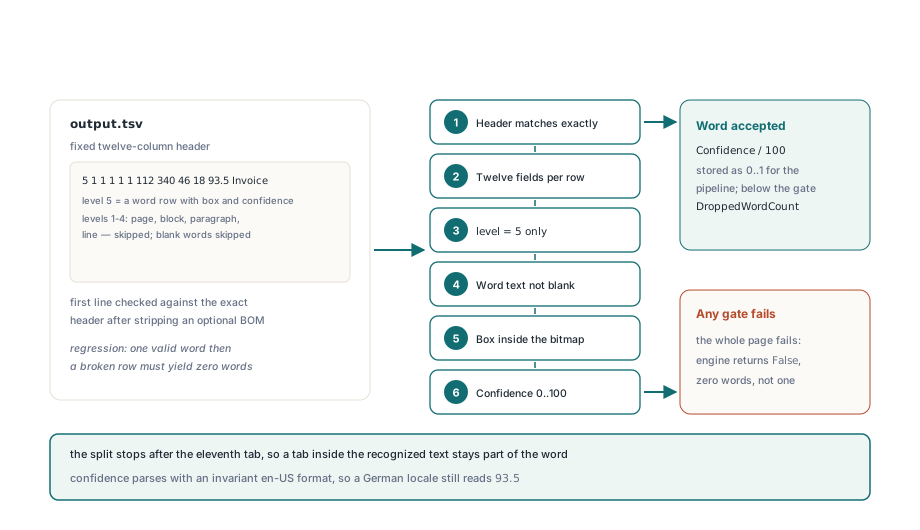
Une ligne étrange fait donc échouer toute l'exécution et laisse chaque page intacte. C'est le bon compromis. Une relance est bon marché ; un PDF consultable où la recherche d'un numéro de facture rate la seule page qui compte a tendance à refaire surface des mois plus tard, entre les mains de quelqu'un d'autre
La dernière étape rencontre aussi un défaut auquel on ne s'attend pas. Tesseract rapporte la confiance de 0 à 100, le pipeline divise par 100, et THPDFOCRTextLayerOptions.MinimumConfidence vaut 0,5 par défaut, si bien que tout mot en dessous de 50 atterrit dans Info.DroppedWordCount au lieu de la page. Sur un scan propre ce plancher est sensé. Sur un fax bruité il peut retirer une grande part du texte, alors comparez Info.ReceivedWordCount avec Info.AcceptedWordCount avant de l'abaisser
Relancer l'OCR sur un fichier qui porte déjà du texte
SkipPagesWithText vaut True par défaut, et cela surprend les gens la seconde fois. Supposez qu'un lot ait été traité avec eng et exige maintenant eng+deu : chaque page porte déjà du texte invisible, si bien que Info.SkippedPageCount égale le compte de pages. HotPDF marque le flux de contenu qu'il écrit comme sa propre couche OCR, et ReplaceExistingOCRTextLayer emploie cette marque pour reconnaître ces pages à nouveau, en abandonnant l'ancienne couche et en gardant le contenu de page d'origine
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // remplace notre couche antérieure
Options.UseOptionalContentGroup := True;      // couche nommée 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Un fichier OCRisé par un pilote de scanner ne porte pas une telle marque, si bien que ses pages comptent toujours comme des pages avec du texte. Désactiver SkipPagesWithText empilerait une seconde couche invisible sur la première, et chaque résultat de recherche apparaîtrait deux fois. Laissez ces fichiers tranquilles
Quels handles le processus Tesseract hérite-t-il ?
Le processus enfant Tesseract hérite d'exactement deux handles de HotPDF : un ouvert sur NUL pour l'entrée et la sortie standard, et un pour stderr.txt dans le répertoire privé. Le blocage de tuyau ci-dessus vient de CreateProcess lui-même : bInheritHandles = True est requis pour passer des handles standard, et à lui seul il passe chaque handle héritable de l'hôte, y compris tuyaux, fichiers et événements ouverts par du code sans rapport. HotPDF emploie STARTUPINFOEX avec une liste d'attributs portant PROC_THREAD_ATTRIBUTE_HANDLE_LIST et le drapeau EXTENDED_STARTUPINFO_PRESENT. bInheritHandles reste True, mais seuls les handles listés traversent
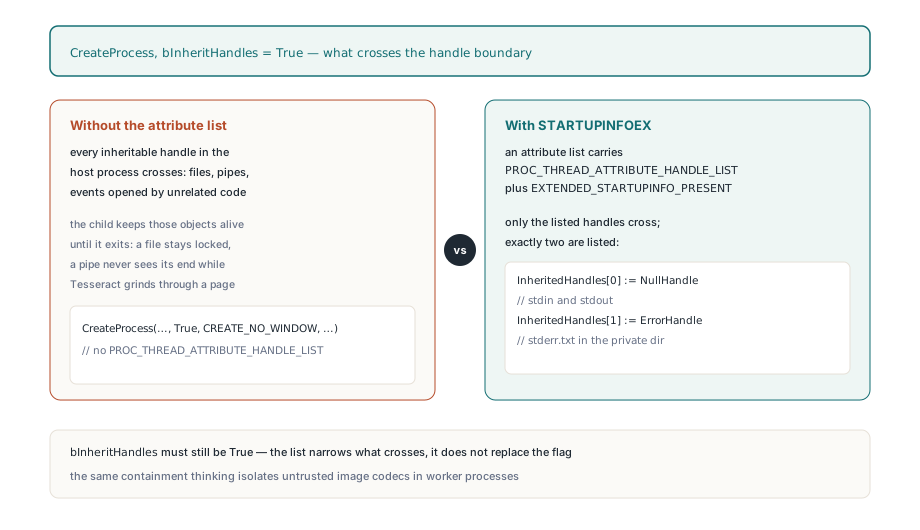
Le même motif appartient à tout autre processus enfant que votre application lance, puisqu'un seul lanceur qui hérite de tout suffit à bloquer chaque lecteur de tuyau du processus :
// Motif pour vos propres appels CreateProcess (fragment : NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir et ProcessInfo sont déclarés ailleurs).
// Les RTL Delphi anciennes ne déclarent pas les fonctions de liste d'attributs ; ajoutez vos
// propres déclarations externes depuis kernel32 si le compilateur ne les trouve pas
// Vérifiez chaque résultat BOOL dans du code de production
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // créé avec bInheritHandle = True
  HandleList[1] := ErrorHandle;        // de même
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... réglez dwFlags et hStdInput / hStdOutput / hStdError comme d'habitude ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // toujours requis avec une liste de handles
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // après la sortie de l'enfant : DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Les scripts ponts ajoutent un détail Windows de plus. Un lanceur Python peut démarrer un second processus d'interpréteur, et terminer le processus que vous avez créé laisse celui-là tourner. Quand on remet au moteur un chemin de script, comme c'est le cas de l'adaptateur RapidOCR ci-dessous, HotPDF démarre l'enfant suspendu, l'affecte à un job object avec JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE puis le relance, si bien que fermer le job termine tout l'arbre. La même idée de confinement anime l'isolation des codecs d'images PDF dans des processus workers, où l'enfant n'est pas fiable ; ici l'enfant est fiable, mais votre processus n'est pas le seul code à détenir des handles dedans
Annulation, timeouts et commit tout-ou-rien
IHPDFOCREngine.Recognize renvoie un seul Boolean, et False couvre à la fois « Tesseract a échoué » et « l'utilisateur a appuyé sur Annuler ». L'adaptateur interroge le token et son timeout toutes les 25 millisecondes pendant que Tesseract tourne, et sur annulation il nettoie et renvoie False. Pris au pied de la lettre, cela se lirait otlsEngineError, si bien que ApplyLoadedOCRTextLayer contrôle le token d'abord chaque fois que Recognize renvoie False. La reconnaissance et la construction du contenu se terminent pour chaque page demandée avant que la transaction du document ne s'ouvre, si bien qu'une annulation à la page 40 sur 50 rapporte otlsCancelled et laisse les 50 pages telles que chargées. Les autres limites suivent le même style :
- Le timeout court depuis le début de chaque appel
Recognize, si bien que le défaut de 60 000 ms est une limite par page - Un enfant encore en train de tourner au timeout ou à l'annulation est terminé et attendu jusqu'à 5 secondes ; le répertoire privé est retiré dans un bloc
finally, avec suppression relancée jusqu'à une seconde parce que les fichiers de sortie peuvent rester verrouillés brièvement après la fin du processus output.tsvest plafonné à 64 Mio etstderr.txtà 1 Mio, vérifiés pendant que l'enfant tourne et après sa sortie- Les mots et unités de code UTF-16 par page sont plafonnés par ce qui reste de
MaxWordsPerPage,MaxTotalWordsetMaxTextCodeUnits; dépasser fait échouer l'exécution au lieu de tronquer la liste - Un code de sortie non nul revient avec jusqu'à 4 096 caractères de
stderr.txt, le moyen le plus rapide d'apprendre qu'un fichier.traineddatamanque
À quoi ressemble la couche de texte invisible dans la page
HotPDF écrit les mots en mode de rendu de texte 3 (ni remplissage ni contour, §9.3.6 de l'ISO 32000-1), si bien que le scan reste visible pendant que la recherche et la copie travaillent sur les mots. Le flux de contenu ouvre BT avec 3 Tr ; chaque mot reçoit une matrice Tm à sa ligne de base, une taille de fonte égale à la hauteur de boîte en pixels fois 72 sur la DPI de rendu, et un échelonnement Tz qui étire la série jusqu'à la largeur de boîte. Cet étirement garde une surbrillance de recherche sur le mot dans l'image
Le TSV a des boîtes mais pas de lignes de base, si bien que chaque ligne de base est placée à un cinquième de la hauteur de boîte au-dessus du bord bas. Entre mots voisins sur une ligne de gauche à droite dans les scripts à espaces comme le latin ou le cyrillique, une espace étirée comble l'écart, si bien que le texte copié garde ses coupures de mots ; le chinois n'en obtient pas. Les glyphes passent par une fonte Type0 partagée non embarquée à encodage Identity-H et un CMap ToUnicode généré, un CID par scalaire Unicode distinct, voilà comment le chinois, le latin accentué et les caractères hors plan de base survivent à la copie et à la recherche. Une série tient jusqu'à 65 535 scalaires distincts, et comme l'ISO 19005 exige des fontes embarquées, la sortie PDF/A demande une fonte conforme embarquée séparément. Pour contrôler un résultat, enregistrez, rechargez et lancez le chemin ordinaire de l'extraction de texte d'un PDF chargé en Delphi ; si les mots attendus reviennent sur les pages attendues, la couche est réelle
RapidOCR et la DLL native sur le même contrat
Pour les scans en chinois simplifié, HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) réutilise le même lanceur de processus et le même analyseur TSV. Le chemin du script pont suit l'exécutable Python et la langue est fixée à chi_sim. HotPDF livre le pont comme tools/OCR/rapidocr_tsv.py ; il exige les paquets rapidocr et onnxruntime, des modèles ONNX locaux et un fichier de fonte, refuse les téléchargements automatiques, et écrit un TSV à la Tesseract ; une surcharge THPDFRapidOCROptions règle les fichiers de modèles, les comptes de threads et un plafond de pixels. La factory générique derrière les deux adaptateurs, HPDFCreateLocalTSVOCREngine dans HPDFLocalTSVRecognition, accepte tout programme qui prend les arguments à la Tesseract et écrit le TSV à douze colonnes, et elle hérite de la liste de handles, du timeout, de l'annulation et des budgets
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) charge pour sa part l'API C de Tesseract en process, se déclare Tesseract (native DLL), vérifie d'entrée que chaque fichier .traineddata demandé existe, et projette annulation et timeout sur le propre moniteur de progression de Tesseract. Il économise un démarrage de processus et un aller-retour BMP par page ; l'exécutable garde les crashes et la croissance mémoire du reconnaisseur hors de votre espace d'adressage. Pour un outil de bureau travaillant sur les scans de l'utilisateur lui-même, la DLL convient. Pour un service qui avale des documents d'inconnus, le moteur en ligne de commande est le choix le plus sûr. Dans les deux cas la reconnaissance tourne sous Windows, une page à la fois, sur le bitmap rendu, alors redressez et nettoyez les scans difficiles avant qu'ils n'atteignent le moteur
Les adaptateurs OCR, l'écrivain de couche de texte, le moteur de rendu qui les alimente et l'extraction qui contrôle la sortie vivent tous dans un composant VCL natif unique pour Delphi et C++Builder. Si votre application de capture ou d'archivage a besoin d'une sortie PDF consultable, le composant HotPDF Delphi PDF couvre tout sauf le moteur OCR que vous installez vous-même