Dans une police TrueType qui conserve l'ordre de glyphes Macintosh standard, le mot « Total » peut se trouver dans un flux de contenu PDF sous la forme <0037005200570044004F> Tj. Ces cinq valeurs de deux octets sont des numéros de glyphes à l'intérieur de la police embarquée, et rien dans la chaîne ne dit qu'elles dessinent T, o, t, a et l. Lisez ces octets comme de l'UTF-16 et vous obtenez la chaîne 7RWDO, tandis que la page affiche bien Total à l'écran, car dessiner un glyphe ne réclame qu'un mappage code-vers-glyphe, alors que retrouver du texte exige un mappage code-vers-Unicode que le fichier n'a peut-être jamais porté
Pourquoi le texte extrait donne-t-il du charabia ?
Un flux de contenu enregistre des codes de caractères, et leur sens vit entièrement dans la police. Les opérateurs Tj et TJ (ISO 32000-1 §9.4.3) transportent des chaînes d'octets interprétées à travers la police que le Tf précédent a sélectionnée : l'octet 0x41 est la lettre A sous WinAnsi, un glyphe arbitraire dans une police de sous-ensemble, ou la moitié d'un CID de deux octets dans une police CJK composite. ISO 32000-1 §9.10 traite l'extraction de texte comme exactement ce problème de décodage, qui ramène chaque code vers l'Unicode à partir de ce que fournit le dictionnaire de la police, et il dit franchement qu'un fichier conforme n'est pas tenu de fournir assez d'informations pour y arriver
Cette clause se cache derrière chaque rapport du style « le copier-coller depuis ce PDF produit du charabia ». Un producteur qui embarque une police de sous-ensemble sans table /ToUnicode a écrit un fichier valide qui s'affiche correctement. Les glyphes sont tous là. Ce qui manque, c'est la carte inverse, que l'extracteur doit reconstruire à partir d'indices secondaires : l'encodage déclaré par la police, les noms de glyphes, les collections de caractères publiées par Adobe, la table cmap à l'intérieur du programme de police embarqué. Combien de ces indices une API essaie, et ce qu'elle vous rend quand tous échouent, voilà ce qui sépare les bibliothèques d'extraction en pratique
Le texte dans l'ordre de lecture avec ExtractLoadedPageText
HotPDF Delphi Component renvoie le texte d'une page chargée dans l'ordre de lecture via function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Les index de pages partent de zéro, le résultat est un UnicodeString Delphi natif, et la fonction retourne False quand la page n'a aucun flux de contenu lisible au lieu de lever une exception. Elle marche sur tout PDF que vous chargez : la facture qu'un client a envoyée par mail, le rapport qu'un bureau de numérisation a livré, le contrat produit par un logiciel dont plus personne ne peut dire le nom
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // renvoie le nombre de pages
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Pour tout le document dans une seule chaîne, ExtractLoadedPagesText(PageRange, PageSeparator) prend une plage à base un comme '1,3-5,7-' (une chaîne vide signifie toutes les pages) et place PageSeparator, un saut de page #12 par défaut, entre les pages. Les gros documents passent mieux par ExtractLoadedPagesTextToStream, qui écrit en UTF-8 page par page dans un TStream et retourne le nombre de pages traitées
Le texte garde ce que la page montre. Les glyphes dont le centre de boîte tombe hors de la zone visible (le crop box à l'intérieur du media box) sont laissés de côté, si bien que les traits d'imprimeur d'une page rognée ne fuient pas dans votre index. Le texte à l'intérieur des Form XObjects que la page peint est inclus, découpé au /BBox de chaque formulaire. Un caractère peint deux fois au même endroit, la vieille astuce pour simuler du gras, n'est lu qu'une fois ; gras simulé et glyphes dupliqués dans l'extraction de texte détaille comment ce cas est détecté
Les sauts de ligne suivent une règle géométrique simple. Une nouvelle ligne démarre quand l'origine du glyphe franchit la direction d'écriture de plus de la moitié de la hauteur du texte, en prenant la plus grande des hauteurs ascent-to-descent de ce glyphe et du glyphe précédent, en unités de page. Mesurer la boîte du glyphe plutôt que l'opérande de taille de Tf est le point qui compte : quantité de producteurs dimensionnent le texte via la matrice de texte et passent 1 à Tf, et un seuil construit sur cet opérande casserait à chaque exposant élevé et mettrait chaque caractère de texte pivoté sur sa propre ligne. Les espaces entre mots marchent pareil. Là où un producteur sépare les mots en déplaçant la position du texte par un ajustement TJ ou un Td au lieu d'afficher un espace, un espace est ajouté dès que l'écart après la propre largeur du glyphe précédent dépasse 0,15 de la hauteur du glyphe, et jamais entre deux caractères chinois, japonais ou coréens. Les codes que le décodeur ne résout pas deviennent des espaces, si bien que les frontières de mots survivent même quand des glyphes isolés ne survivent pas. Le texte horizontal sort dans l'ordre du flux de contenu ; les séquences CJK verticales sont regroupées en colonnes lues de droite à gauche, de haut en bas. Espaces entre mots et sauts de ligne dans le texte de page couvre ces seuils
Grille, colonnes ou ordre de structure
Quand la position porte du sens (tableaux, formulaires, listings de code, tout ce que vous comptez comparer, grepper ou analyser par colonne), ExtractLoadedPageTextLayout est le meilleur appel. Il regroupe les glyphes en lignes de base, trie chaque ligne de base selon X, et reproduit les espaces horizontaux et verticaux sur une grille de caractères monospace dimensionnée d'après l'avance médiane des glyphes de la page et la taille de police. Les grands écarts sur une ligne de base deviennent des suites d'espaces, les grands écarts entre lignes de base deviennent des lignes vides
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Les colonnes, l'indentation et l'alignement des tableaux survivent sous
  // forme d'espaces et de lignes vides sur une grille de caractères
end;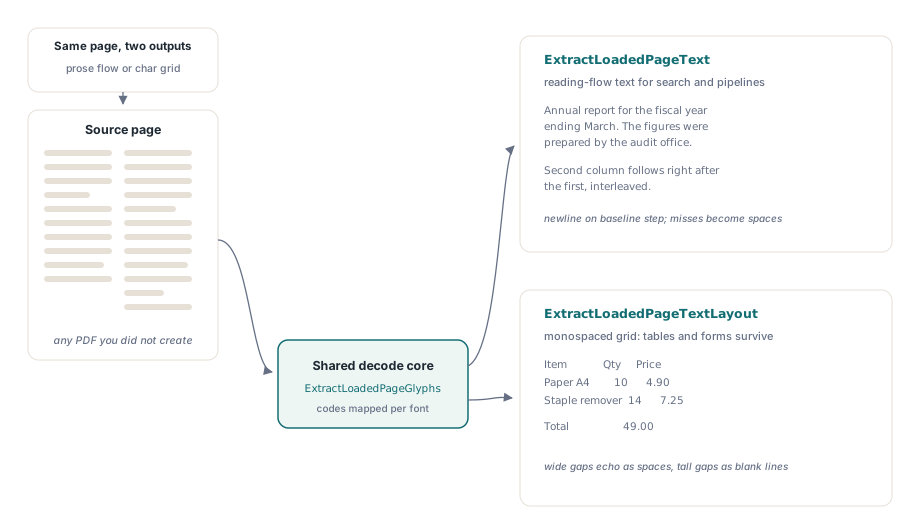
Les deux appels décodent par le même mécanisme, si bien que choisir l'un ne coûte rien en fidélité. Ce que la grille ne fera jamais, c'est refluer la prose : un article à deux colonnes sort avec les deux colonnes côte à côte, fidèlement, ce qui convient à un diff et pas à un résumeur. Deux autres appels couvrent ce manque. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) scinde chaque ligne partout où l'écart entre glyphes voisins dépasse le multiplicateur fois l'avance médiane (3,0 par défaut) et sépare les morceaux par une tabulation. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) parcourt l'arbre de structure d'un PDF balisé (ISO 32000-1 §14.8.4) et retourne les passages de contenu marqué dans l'ordre de création ; elle retourne False quand la page n'a pas d'arbre de structure exploitable, et UntaggedGlyphCount vous dit combien de glyphes elle n'a pas pu placer
Pour du texte destiné à un humain ou à un modèle de langage, essayez d'abord l'ordre de structure et revenez à ExtractLoadedPageText en repli. L'arbre de structure est le seul ordre que l'auteur a déclaré volontairement, et chaque méthode géométrique n'est qu'une supposition à côté. Gardez la grille pour les travaux où les colonnes sont des données. L'extraction de texte dans l'ordre de structure détaille la façon dont le contenu marqué est apparié à l'arbre
Comment HotPDF décode les codes de caractères en Unicode
HotPDF Delphi Component résout chaque code de caractère à travers une chaîne de replis ordonnée par priorité, et une stratégie qui ne sait pas répondre passe le code à la suivante. La CMap /ToUnicode de la police (ISO 32000-1 §9.10.3) passe d'abord, car c'est le seul mappage que le producteur a écrit spécifiquement pour l'extraction. Viennent ensuite les noms de glyphes d'un tableau /Differences de /Encoding, lus via l'Adobe Glyph List ; puis la CMap /Encoding elle-même, embarquée en flux ou nommée, où un nom Uni…-UTF16 signifie que le code est déjà de l'UTF-16. Les polices composites continuent à travers les collections de caractères Adobe (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) du CID vers l'Unicode, puis à travers /CIDToGIDMap vers la table cmap du programme de police embarqué, lue en sens inverse du glyphe vers l'Unicode. Les polices simples retombent sur les tables WinAnsi, MacRoman, Standard et MacExpert et enfin sur cette même cmap embarquée. Un code qui épuise la chaîne se résout en 0
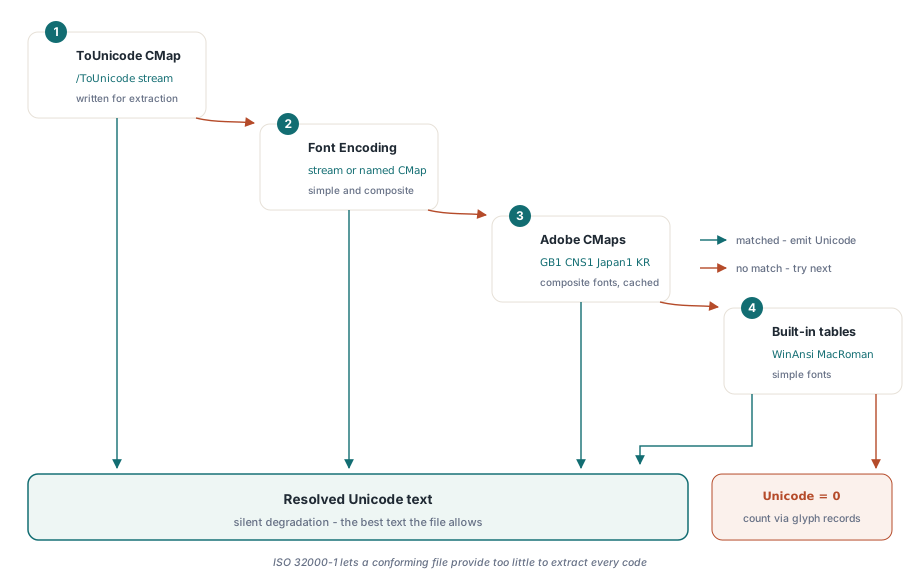
L'étape de la cmap embarquée est celle qui sauve bien des polices de sous-ensemble livrées sans /ToUnicode : le programme de police contient en général encore sa propre cmap Unicode, et la lire en sens inverse récupère la plus grande partie du texte. C'est toutefois une reconstruction. Deux caractères Unicode qui partagent un même glyphe reviendront tous les deux comme celui que la cmap liste, alors traitez le texte récupéré comme bon pour la recherche et l'indexation, et vérifiez-le avant de l'utiliser comme enregistrement légal
Les données des collections Adobe vivent sur disque. HotPDF livre les fichiers CMap et cid2code.txt dans son dossier resources\CMap, analyse chaque fichier au plus une fois par processus et met le résultat en cache ; la carte Adobe-GB1 à elle seule pèse environ 2 Mo de texte que vous ne voulez pas analyser à chaque page. Les CMaps prédéfinies existent aussi en tables intégrées, si bien qu'une police encodée avec une CMap nommée comme UniGB-UTF16-H décode quand même sans le dossier. Les tables CID-vers-Unicode des polices CJK Identity-H en ont besoin, elles. La propriété CMapResourcePath nomme le dossier qui contient les sous-dossiers de collections ; laissée vide, HotPDF cherche resources\CMap à côté de l'exécutable et un ou deux niveaux au-dessus
Pdf := THotPDF.Create(nil);
try
  // Dossier qui contient Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Posez le chemin explicitement dans tout service, module ISAPI ou DLL de plugin. Dans ces hôtes, ParamStr(0) nomme le processus hôte, rarement le dossier où vous avez déployé, et un dossier manquant ne lève rien ; les pages CJK reviennent simplement avec des trous là où les tables de collections auraient rempli. La mise en forme des écritures complexes avec HotPDF rencontre le même clivage code-versus-glyphe au moment de l'écriture
Deux pièges de syntaxe CMap
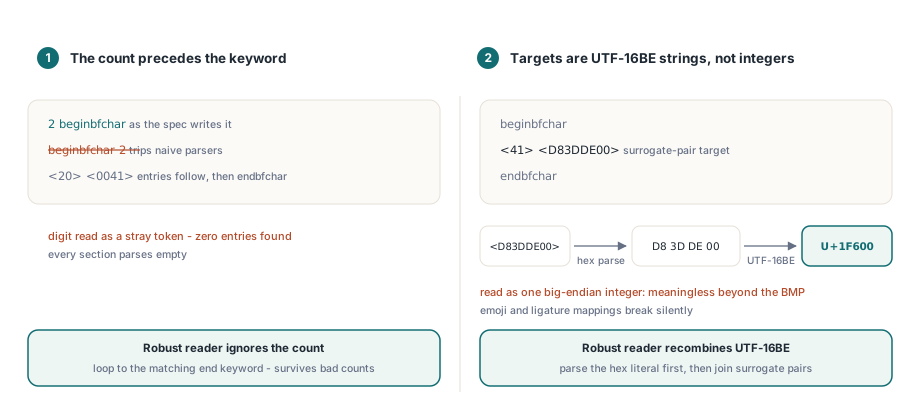
Les fichiers CMap semblent triviaux à analyser, et deux détails font trébucher la plupart des premières tentatives. Le nombre d'enregistrements vient avant le mot-clé de section : une section se lit 2 beginbfchar, jamais beginbfchar 2. Un analyseur qui attend le nombre après le mot-clé avale le chiffre comme un jeton parasite puis trouve zéro entrée dans chaque section. Le lecteur de HotPDF ignore totalement le nombre et boucle jusqu'au endbfchar ou endbfrange correspondant, ce qui encaisse aussi les fichiers réels dont les nombres déclarés sont faux
Le second piège est que les cibles bfchar et bfrange sont des chaînes UTF-16BE. La destination <D83DDE00> signifie U+1F600, une paire de substitution qu'il faut recombiner en un seul point de code, et lire ces quatre octets comme un entier big-endian donne une valeur sans sens pour chaque caractère hors du plan multilingue de base, emoji compris. HotPDF analyse d'abord le littéral hexadécimal en octets bruts puis recombine les unités de code UTF-16BE, ce qui gère aussi les cibles multi-caractères que produisent les mappages de ligatures, comme un glyphe fi qui correspond à deux lettres
Compter les glyphes non résolus avec ExtractLoadedPageGlyphs
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) expose les enregistrements de glyphes sous les appels de texte sous la forme d'un THPDFGlyphArray. Chaque THPDFGlyphRecord porte le Code brut, sa CodeByteWidth (1, 2 ou 4, décidée par le codespacerange de la CMap), le point de code Unicode résolu plus une UnicodeSequence pour les ligatures, le FontKey et le FontSize actifs, l'origine X et Y en espace utilisateur, l'Advance, un quad de glyphe à quatre coins, et GlyphEndX / GlyphEndY, la fin de la propre largeur du glyphe dont part la règle d'espace entre mots. C'est assez pour du surlignage positionné ou un algorithme de mise en page à vous
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Compter les enregistrements Unicode = 0 est le moyen honnête de juger un document avant de faire confiance à son texte en aval. Attendez-vous à ce que le compte diffère légèrement de ce que voient les appels de texte. Cet appel retourne chaque glyphe du propre flux de contenu de la page, y compris ceux hors du crop box et les doublons peints pour le faux gras, et ne descend pas dans les Form XObjects. Chaque enregistrement stocke aussi TokenIndex, ItemIndex et ByteOffset, qui rattachent le caractère à son opérande source ; la recherche et le remplacement dans un PDF existant se construit sur ces trois champs
Certains fichiers n'ont pas de texte à donner. Une page numérisée est une grande image sans opérateurs de texte, si bien que l'extraction renvoie correctement une chaîne vide, et la route à suivre est l'OCR, en commençant par l'extraction des images de page du PDF chargé. Les documents chiffrés s'extraient normalement une fois ouverts avec LoadFromFile(FileName, Password), car les flux sont déchiffrés avant que l'interpréteur les lise. Les flux de polices et de contenu passent par la même chaîne de filtres que le reste du document chargé, et un flux /ToUnicode indécodable retombe sur la stratégie suivante tandis que le reste de la page s'extrait. Le même lecteur d'objets sert l'édition des métadonnées des documents chargés, si bien qu'une seule passe d'entrée peut lire le texte et corriger les métadonnées
L'extraction dans l'ordre de lecture, en grille, par colonnes et dans l'ordre de structure, plus l'accès au niveau glyphe, arrive toute entière dans le HotPDF Delphi Component pour Delphi et C++Builder en Object Pascal pur, sans DLL externes ni services de texte du système, si bien que quand un fichier bizarre atterrit dans votre file, vous pouvez entrer dans le décodeur et voir quelle stratégie a répondu pour chaque code