Vous avez un PDF sur le disque, un client l’a scanné à partir d’une pile de factures, et votre travail consiste à ressortir les images de page sous forme de bitmaps pour un passage OCR. Vous chargez le fichier, vous repérez les XObjects image, puis vous découvrez la partie dont personne ne vous avertit : les octets de ces flux ne sont pas des pixels. Ce sont un codestream JPEG, ou un blob JPEG 2000 compressé en ondelettes, ou un ruban fax Group 4, ou un raster indexé derrière une palette et un filtre Flate. L’objet image connaît sa largeur et sa hauteur, mais les échantillons réels restent enfermés dans le filtre choisi par le producteur. Obtenir un TBitmap exploitable signifie annuler ce filtre, et PDF offre à peu près huit manières différentes d’enfermer les octets
C’est précisément le manque que ExtractLoadedImage comble dans HotPDF, le composant PDF VCL natif pour Delphi et C++Builder. Il énumère les XObjects image d’un document que vous avez chargé, indique ce qu’est chacun d’eux, puis décode ceux qu’il peut en un bitmap 24 bits. L’élément intéressant n’est pas la surface de l’API, qui tient en trois méthodes. C’est la raison pour laquelle un chemin de décodage séparé doit exister, et ce qu’il peut ou non reconvertir en pixels
Pourquoi les images chargées ne sont pas déjà décodées
Le chargeur de HotPDF est bâti autour d’une fidélité en passage direct. Quand vous appelez LoadFromFile, les flux d’image sont conservés exactement tels qu’ils apparaissent dans le fichier source : le filtre d’origine, les octets compressés d’origine, le dictionnaire d’origine. C’est volontaire. Le but d’un chargement de document est le plus souvent de copier des pages, fusionner des fichiers, appliquer un tampon, modifier des autorisations et réécrire le résultat, et pour tout cela la solution la moins coûteuse et la plus sûre consiste à laisser chaque flux d’image intact. Décoder chaque image en raster au chargement gaspillerait mémoire et CPU pour un travail dont la plupart des appels n’ont jamais besoin, et réencoder à l’enregistrement dégraderait des images qui auraient dû être copiées à l’identique
La conséquence est que le graphe d’objets chargé ne porte aucun pixel. Un XObject image dont le /Filter est /DCTDecode contient des octets JPEG ; HotPDF n’a jamais exécuté de décodeur JPEG dessus, parce que rien dans le chemin de copie et de réécriture n’en avait besoin. Donc, lorsque vous voulez réellement des pixels, l’API d’extraction doit faire le décodage elle-même, depuis zéro, pour le filtre que cette image particulière utilise. C’est la même raison pour laquelle les codecs de la voie d’encodage sont indépendants du chargeur : l’article sur ajouter des images JPEG 2000 à des PDF dans Delphi décrit comment le moteur JPX se branche sur la création, et ce moteur n’a tout simplement pas été relié au chemin de lecture avant que l’API d’extraction en ait besoin
L’API à trois méthodes
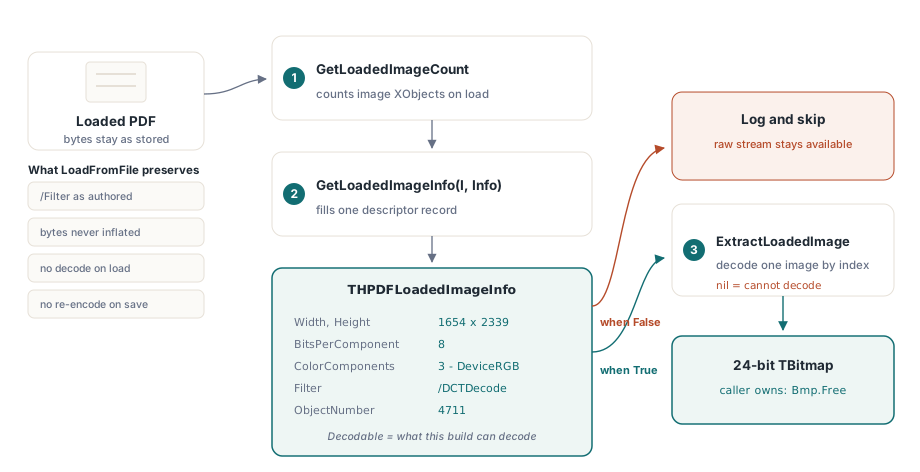
La surface est réduite. GetLoadedImageCount renvoie le nombre de XObjects image contenus dans le document chargé. GetLoadedImageInfo remplit un enregistrement descripteur pour l’un d’eux à partir de son index. ExtractLoadedImage renvoie le bitmap décodé, ou nil lorsqu’il ne peut pas décoder cette image. L’énumération est basée sur un index et reste stable pour un chargement donné : en interne, elle parcourt la table des objets indirects et collecte chaque flux dont le /Subtype résout à /Image, de sorte que l’index passé à GetLoadedImageInfo est le même que celui passé à ExtractLoadedImage
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // filtre ou espace colorimétrique non supporté
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // le bitmap appartient à l'appelant
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
// On trie chaque image avant de se lancer dans un décodage
var
Pdf: THotPDF;
Info: THPDFLoadedImageInfo;
I: Integer;
begin
// ... Pdf loaded ...
for I := 0 to Pdf.GetLoadedImageCount - 1 do
begin
if not Pdf.GetLoadedImageInfo(I, Info) then
Continue;
if Info.Decodable then
// ExtractLoadedImage(I) will return a TBitmap
else
// filtre/espace colorimétrique non supporté : on logue l'objet et on passe
Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
[I, Info.ObjectNumber, Info.Width, Info.Height,
String(Info.Filter), String(Info.ColorSpace)]));
end;
end;Deux détails de contrat comptent ici. D’abord, le TBitmap renvoyé vous appartient et vous devez le libérer ; le document ne le met pas en cache et n’en devient pas propriétaire. Ensuite, vérifiez Decodable avant d’appeler, puis vérifiez le résultat par rapport à nil après l’appel. La méthode ne lève pas d’exception sur un filtre non pris en charge, elle renvoie nil, et un nil silencieux dans une boucle de traitement est exactement le genre de chose qui fait disparaître une page dans un lot de mille sans que personne ne s’en rende compte
Lire le descripteur avant de décoder
THPDFLoadedImageInfo vous dit ce qu’est une image sans engager un décodage complet. Ses champs viennent directement du dictionnaire image : Width et Height en échantillons, BitsPerComponent, ColorSpace et ColorComponents décrivant l’interprétation après décodage (1 pour le gris, 3 pour RGB, 4 pour CMYK), Filter comme compression nommée, IsImageMask pour les masques pochoir, ObjectNumber pour l’objet indirect sous-jacent, et Decodable
Ce dernier indicateur est le plus honnête. Decodable vaut True seulement quand la version en cours peut réellement transformer cette combinaison précise de filtre et d’espace colorimétrique en bitmap. Il encode la vraie matrice de prise en charge, pas un espoir : une image dont le Filter n’est pas compris par la version en cours renvoie Decodable = False, et vous pouvez vous en servir pour journaliser, ignorer ou retomber sur l’extraction du flux brut par vous-même. Traitez-le comme une précondition, pas comme une suggestion
Un détail d’implémentation piège les gens qui construisent le descripteur à la main. THPDFLoadedImageInfo contient deux champs AnsiString, Filter et ColorSpace. Ce sont des types gérés avec comptage de références, donc le réflexe qui consiste à remettre un enregistrement à zéro avec FillChar(Info, SizeOf(Info), 0) est faux ici : cela écrase la référence de chaîne sans la décrémenter, ce qui fuit ou corrompt. HotPDF initialise l’enregistrement champ par champ exactement pour cette raison, et si vous reproduisez ce modèle dans votre propre code, faites la même chose
Un répartiteur, huit chemins de filtre
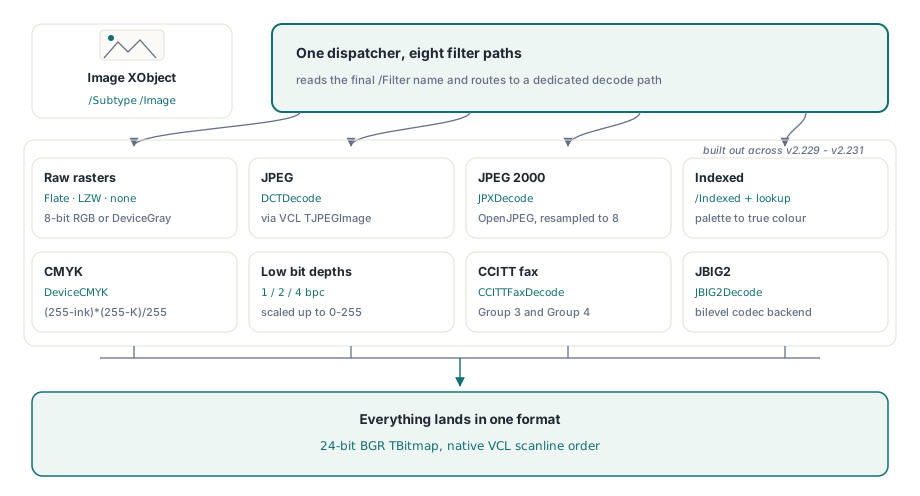
Si cette fonctionnalité a été livrée en plusieurs versions plutôt qu’en une seule, c’est parce que PDF n’a pas de format image. Il a des filtres, et le §8.9.5 de l’ISO 32000-1 permet à un XObject image d’en nommer n’importe lequel dans /Filter, tandis que l’interprétation des échantillons est gouvernée séparément par /BitsPerComponent, /ColorSpace et un tableau /Decode facultatif. ExtractLoadedImage lit le nom du filtre et route vers un décodeur dédié pour chaque cas. L’ensemble pris en charge, construit de la version v2.229 à v2.231, couvre désormais huit chemins distincts
- Rasters bruts (FlateDecode, LZWDecode ou sans filtre) en DeviceRGB ou DeviceGray 8 bits. Les octets se décompressent en un raster compact, et la seule transformation est un échange de canaux, traité ci-dessous
- DCTDecode (JPEG). Le codestream est confié au
TJPEGImagede la VCL, qui résout la géométrie et la couleur, et le résultat est affecté dans un bitmap 24 bits - JPXDecode (JPEG 2000). Décodé via le backend OpenJPEG, le même moteur que celui décrit dans l’article sur JPEG 2000, les composantes à grande profondeur de bits étant rééchantillonnées vers 8 bits
- Couleur indexée. La palette est lue dans le tableau
[/Indexed base hival lookup]et chaque échantillon est développé via la table de recherche vers la couleur vraie - DeviceCMYK. Les échantillons à quatre canaux sont convertis en RGB avec la formule standard de l’encre sur blanc
- DeviceGray et indexé en dessous de 8 bits à 1, 2 ou 4 bits par composante, dépaqueté échantillon par échantillon et mis à l’échelle de la plage 0–255
- CCITTFaxDecode, les filtres fax Group 3 et Group 4, décodés par un backend T.4/T.6 dédié
- JBIG2Decode, le filtre bilevel à fort taux de compression, décodé via le backend JBIG2 enregistré que l’article sur la compression JBIG2 native couvre côté encodage
Tout finit au même endroit : un bitmap BGR 24 bits, parce que c’est ce que stocke nativement un TBitmap VCL et ce que tout consommateur en aval attend
Les transformations qui modifient les pixels sans bruit
Deux de ces chemins impliquent une transformation qu’il est facile de rater subtilement, et qui mérite d’être comprise même si vous ne touchez jamais le décodeur vous-même. La première est l’échange d’ordre des couleurs. Un raster PDF DeviceRGB stocke les échantillons dans l’ordre rouge-vert-bleu, ligne supérieure en premier. Un scanline 24 bits VCL les stocke dans l’ordre bleu-vert-rouge. Donc décoder une simple image RGB n’est pas un memcpy ; les premier et troisième octets de chaque pixel sont échangés en entrant dans le scanline. Si vous inversez cela, les rouges et les bleus se permutent, ce qui paraît acceptable sur une image de test en niveaux de gris et catastrophique sur une image couleur. Quant à l’ordre des lignes, il se propage directement : les rasters PDF orientés du haut vers le bas s’alignent avec le ScanLine[0] VCL comme première ligne visuelle en haut, donc aucun retournement vertical n’est nécessaire
La seconde concerne le CMYK. Les images PDF DeviceCMYK transportent quatre encres, et la conversion vers RGB est un calcul par canal, pas une table de correspondance : chaque canal de sortie vaut (255 - ink) * (255 - K) / 255. C’est une approximation de périphérique, pas une conversion gérée par couleur via un profil ICC, donc le résultat est assez bon pour l’affichage et la ré-rasterisation, mais ce n’est pas la bonne voie si vous avez besoin d’une couleur exacte pour l’impression. Si votre flux exige de la fidélité, considérez le bitmap extrait comme un aperçu et gardez le flux CMYK original pour le pipeline géré en couleur
Le chemin Indexed cache son propre piège d’analyse. La palette d’un espace colorimétrique /Indexed peut être stockée sous forme de chaîne littérale ou de chaîne hexadécimale, et HotPDF conserve la valeur d’une chaîne hexadécimale comme le texte hexadécimal lui-même, pas comme des octets déjà décodés. Donc, lorsque la palette est une chaîne hexadécimale, la table de recherche doit d’abord passer par une conversion hex vers octets ; une chaîne littérale est déjà du binaire brut. Omettre cette branche et une image indexée à quatre couleurs ressort en charabia, parce que chaque entrée de palette est lue avec le mauvais alignement d’octets
Chaînes de filtres : le dernier filtre est propre à l’image
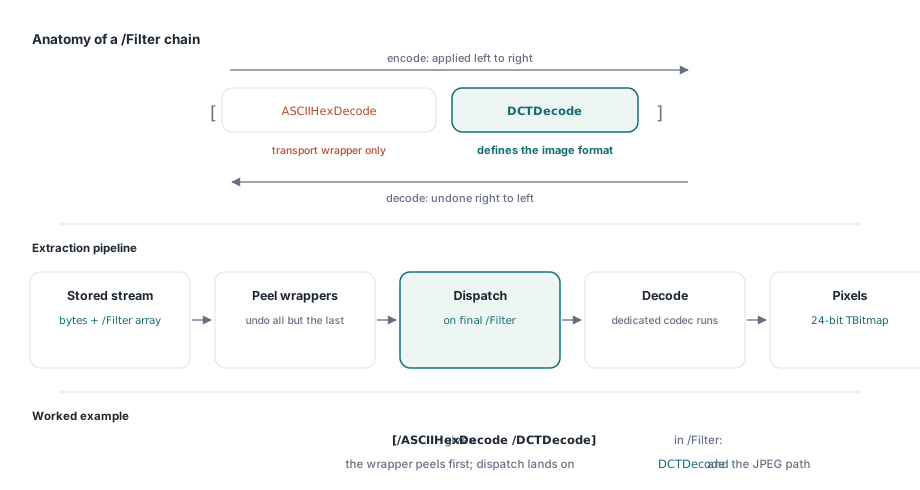
Un nom /Filter unique est le cas simple. PDF autorise aussi une chaîne de filtres, dans laquelle le flux a été passé successivement par plusieurs filtres, listés dans l’ordre dans un tableau /Filter tel que [/ASCII85Decode /FlateDecode] ou [/ASCIIHexDecode /DCTDecode] (ISO 32000-1 §7.4). La sémantique est précise : à l’encodage les filtres s’appliquent de gauche à droite, donc au décodage il faut les annuler de droite à gauche, et le dernier filtre du tableau est celui qui définit réellement le format de l’image. Les filtres qui précèdent ne sont que des encodages de transport autour de lui
L’extracteur traite cela en pelant les couches. Avant qu’un décodeur d’image n’entre en jeu, chaque filtre de la chaîne sauf le dernier est appliqué pour produire l’entrée attendue par le filtre final, puis seulement ensuite le routage se fait sur ce dernier filtre. Ainsi, [/ASCII85Decode /DCTDecode] est d’abord désencodé en ASCII85, puis le résultat est envoyé vers le chemin JPEG ; [/FlateDecode] autour d’un raster brut est d’abord décompressé, puis traité par le chemin raster. C’est ce qui permet aux huit décodeurs de rester simples. Aucun n’a à connaître les enveloppes de transport ASCII85 ou hexadécimal, parce qu’au moment où un décodeur voit les octets, ces enveloppes ont déjà disparu. Cela signifie aussi qu’une chaîne dont le dernier filtre n’est pas pris en charge échoue proprement au stade du dispatch, et non à mi-chemin du décodage
Où s’arrête l’extraction, et quoi faire ensuite
Restez honnête sur les limites. Une image dont le filtre final n’appartient pas à l’ensemble pris en charge renvoie nil, tout comme une image dont l’espace colorimétrique n’est pas interprétable par la version en cours. Les masques souples et l’alpha ne sont pas reconstruits dans le bitmap ; vous obtenez l’image de base, pas le résultat composité. Les profondeurs au-delà de 8 bits pour JPEG 2000 sont ramenées vers le bas, ce qui est volontairement destructif et inadapté si vous réarchivez plutôt que si vous affichez. Et un masque d’image, pochoir 1 bit sans couleur propre, est bien décrit par le descripteur mais reste quelque chose de différent d’une image picturale ; si vous le decodez en vous attendant à une photo, vous serez surpris
Quand l’extraction ne suffit pas, le flux brut est toujours là dans le graphe d’objets chargé, filtre compris, et vous pouvez le sortir octet par octet pour le confier à un codec spécialisé de votre cru. C’est le repli que le design en passage direct préserve volontairement : les octets d’origine ne sont jamais jetés, donc le pire des cas consiste à les décoder vous-même plutôt qu’à découvrir que les données ont disparu. Pour la plupart des travaux réels, toutefois, les huit filtres pris en charge couvrent ce que les scanners, suites bureautiques et moteurs de rapports émettent réellement, et une boucle sur GetLoadedImageCount avec un garde Decodable transforme un PDF chargé en dossier de bitmaps en quelques lignes
L’API d’extraction d’images chargées, avec l’ensemble des filtres de décodage décrits ici, est fournie dans le HotPDF Delphi Component pour Delphi et C++Builder