Un parser se bloque sur un PDF malformé quand une branche lit un octet, refuse de le traiter et retourne sans déplacer le curseur. La boucle appelante ne voit ni progrès ni raison de s'arrêter, alors elle tourne à l'infini. HotPDF a livré exactement ce défaut dans trois parsers indépendants, tous atteignables à partir d'entrées de moins de cinquante octets
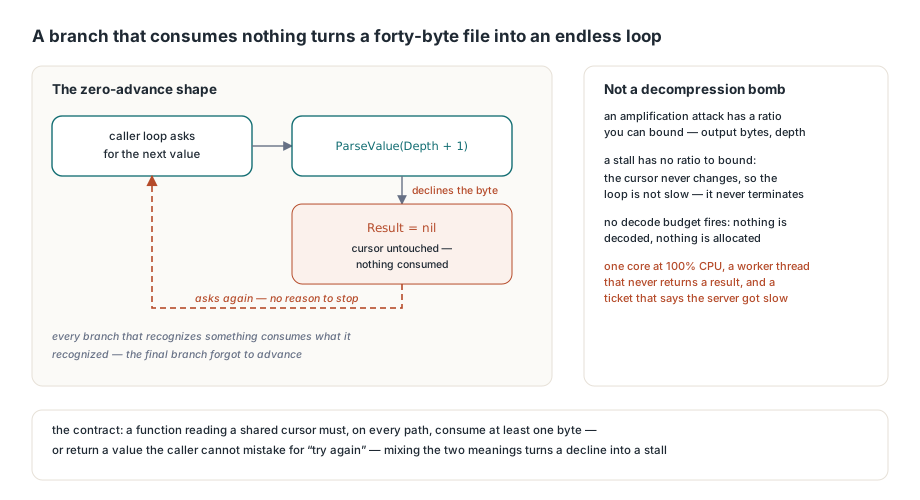
C'est une classe de déni de service qui mérite d'être nommée à part, parce qu'elle ne ressemble pas à celle contre laquelle tout le monde se protège déjà. Pas de décompression, pas de croissance d'allocation, pas de pression mémoire pour déclencher un watchdog. Le processus reste simplement à cent pour cent de CPU sur un seul cœur avec une poignée d'octets dans un buffer. Si vous avez ajouté un budget de décodage après avoir lu l'article sur l'amplification des filtres imbriqués et les bombes PDF, ce budget ne se déclenchera pas ici : rien n'est décodé, rien n'est alloué. Défaut différent, correctif différent
Pourquoi un fichier de quarante octets coûte-t-il plus cher qu'une bombe de décompression ?
Parce que le coût n'a aucun rapport avec la taille de l'entrée. Une attaque par amplification a un ratio que vous pouvez borner : plafonnez les octets de sortie, plafonnez la profondeur de récursion, et le pire cas devient fini. Une boucle sans progression n'a aucun ratio à borner. La condition de boucle dépend d'un curseur qui ne change jamais, donc elle n'est pas lente, elle ne se termine pas, et aucun plafond basé sur la taille en amont ne l'attrapera. C'est aussi ce qui la rend particulièrement vicieuse en exploitation. Un crash vous donne une stack, une sortie de mémoire vous donne une ligne de log, et un parser bloqué vous donne un thread de travail qui ne retourne jamais de résultat, une requête qui n'expire jamais parce que rien en aval ne sait qu'elle a commencé, et un ticket qui dit que le serveur a ralenti mardi. La cause structurelle a toujours la même forme. Un tokenizer ou un parser de valeur enchaîne des branches pilotées par l'octet courant. Chaque branche qui reconnaît quelque chose consomme ce qu'elle a reconnu. Puis il y a une branche finale, ou une garde avant la chaîne, qui retourne pour les octets que personne n'a réclamés, et l'auteur la traite comme un chemin d'erreur plutôt que comme une étape de scan. Les chemins d'erreur retournent une valeur ; les étapes de scan avancent le curseur. Quand une fonction doit faire les deux, c'est l'avancement qu'on oublie
Le parser d'objets : deux délimiteurs que personne n'a consommés
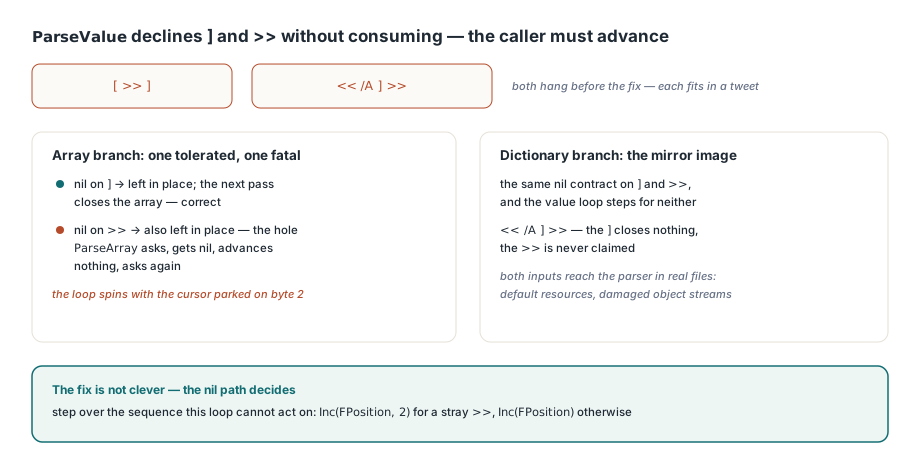
Dans HPDFParser, la méthode THPDFSpanObjectParser.ParseValue commence par refuser deux séquences d'octets sans détour. Selon la section 7.3 d'ISO 32000-1, une valeur ne peut pas commencer par ] ni par >>, puisque ces séquences ferment un conteneur au lieu d'ouvrir une valeur, donc ParseValue retourne nil pour les deux sans les consommer. C'est le contrat correct, et il met toute la responsabilité de l'avancement sur l'appelant. La branche tableau n'en a honoré que la moitié : sur un résultat nil, elle vérifiait ], le laissait en place pour que le passage suivant ferme le tableau, et enjambait tout le reste — sauf que la vérification était écrite de telle sorte qu'un >> isolé restait aussi en place. Du coup [ >> ] bloque, parce que ParseArray demande une valeur, reçoit nil, n'avance pas et redemande. La branche dictionnaire avait le trou en miroir, et << /A ] >> bloque de la même façon. Les deux entrées sont assez valides pour atteindre le parser et assez courtes pour tenir dans un tweet
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Avant le correctif, aucun des deux appels ci-dessous ne retournait
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Le correctif n'a rien d'ingénieux, et c'est justement le propos : le chemin nil doit décider explicitement laquelle des deux séquences non consommées la boucle courante peut traiter, et enjamber l'autre
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue retourne nil pour ']' et '>>' sans les consommer.
  // Le ']' termine le tableau au passage suivant, mais un '>>' isolé
  // dans un tableau doit être enjambé, sinon l'analyse n'avance jamais
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Autre chose mérite l'attention ici. THPDFSpanObjectParser.RecordError se contente d'incrémenter ErrorCount dans THPDFParserViewStatistics ; il ne plafonne rien. Le parser fixe HPDFParserMaximumDepth à 64 pour borner l'imbrication, mais n'a aucun plafond équivalent sur le nombre d'erreurs, et un compteur que personne ne lit jamais est un coupe-circuit raté. Même avec l'avancement rétabli, une entrée qui produit une erreur par octet va ronger un gros objet à un rythme qui mérite une sortie anticipée plutôt qu'un parcours complet. Vérifiez Valid dans l'enregistrement de statistiques après chaque analyse et traitez un ErrorCount élevé comme une raison de ne plus faire confiance à l'objet, pas seulement comme un diagnostic
La même forme dans le tokenizer CMap et le lecteur XFDF
HPDFCMapReader.NextToken portait le même défaut dans sa branche de repli. La fonction retourne un TCMapTok et traite <, ( et / dans des branches dédiées ; tout le reste retombe dans « lire jusqu'à un espace ou un délimiteur ». Quand l'octet de départ est lui-même un délimiteur de l'ensemble de la section 7.2.2 d'ISO 32000-1, cette boucle s'exécute zéro fois, le token revient vide, et l'appelant redemande le même token. Des six caractères qui peuvent atterrir là, seul [ était intercepté plus tôt par la gestion bfrange, donc un ), >, ], { ou } isolé n'importe où dans un CMap ToUnicode suffisait à bloquer l'extraction de texte
// mot-clé ou nombre : lire jusqu'à un espace ou un délimiteur
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Un délimiteur qu'aucune branche ci-dessus ne réclame (un ')', '>',
// '[', ']', '{' ou '}' isolé) laisserait P en place et retournerait
// un mot-clé vide, donc l'appelant redemanderait le même token à l'infini
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
Le côté XFDF avait une variante d'origine différente et au même effet. HPDFXFDFXml.ParseElement affecte Result := P en haut, alors que P pointe encore sur le < ouvrant, et n'incrémente son curseur local qu'ensuite, donc chaque sortie anticipée qui suit retourne la position d'entrée sauf si elle écrase Result d'abord. Une déclaration de doctype selon la section 2.8 de XML 1.0, ou n'importe quoi d'autre sans nom de balise analysable comme <1a>, empruntait une sortie qui ne mettait jamais Result à jour, et la boucle d'éléments enfants recevait la position qu'elle avait passée. La boucle d'attributs en comptait trois autres, puisque ReadName, le saut d'espaces et la gestion de = refusent tous un octet qui n'est ni un caractère de nom, ni un espace, ni l'un de =, >, /, et aucun d'eux ne le consommait. La réparation CDATA voisine déplaçait une responsabilité plutôt que d'ajouter une garde : une section CDATA selon la section 2.7 de XML 1.0 commence par <, donc la boucle enfant la confiait autrefois à ParseElement, qui lisait alors un nom de balise dans le contenu de la section. La reconnaître dans la boucle enfant avec IsCDATAStart et copier les octets dans le buffer de texte jusqu'à IsCDATAEnd est le bon découpage, et l'ancien saut était aussi d'un octet trop court, puisque le marqueur fait huit octets en comptant depuis le !
Des compteurs déclarés qui survivent aux données
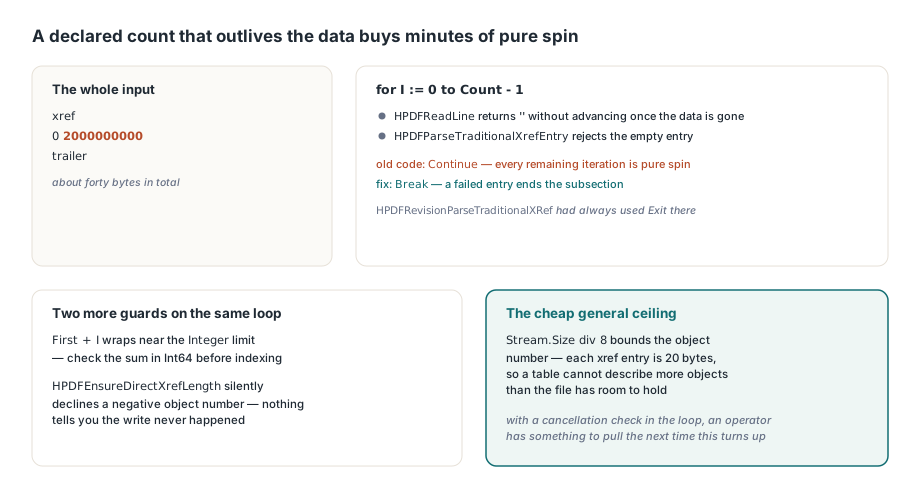
Une version ultérieure a fait ressortir le même motif depuis la direction opposée, et c'est la variante la plus susceptible d'exister dans votre propre code. L'en-tête d'une sous-section de table de références croisées selon la section 7.5.4 d'ISO 32000-1 est une paire first count, et les deux parsers xref traditionnels de HotPDF bouclaient dessus avec for I := 0 to Count - 1 en utilisant Continue plutôt que Break quand une entrée échouait à être analysée. Cela se lit comme une tolérance pour une mauvaise ligne. Ce n'en est pas une : HPDFReadLine retourne une chaîne vide sans avancer dès que les données sont épuisées, et HPDFParseTraditionalXrefEntry rejette immédiatement une entrée vide, donc chaque itération restante du compteur déclaré est de la pure rotation à vide. L'arithmétique est impitoyable — l'en-tête xref\n0 2000000000\ntrailer plus un habillage minimal représente environ quarante octets, et il achète des dizaines de secondes d'un cœur occupé sans aucun contrôle d'annulation dans la boucle. L'indice se trouvait dans la même unité, parce que HPDFRevisionParseTraditionalXRef avait toujours utilisé Exit à cet endroit. Quand deux fonctions analysent la même grammaire et ne s'accordent pas sur la question de savoir si une entrée en échec termine la sous-section, l'une des deux est une branche qui a cessé de recevoir les correctifs, la même signature que celle qu'on retrouve dans la gestion des références croisées hybrides où une table traditionnelle et un flux décrivent les mêmes objets
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Sans cela, un compteur déclaré plus grand que la table ferait
  // tourner ici sans qu'il reste de données à lire
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First vient de l'en-tête de sous-section, donc la somme déborde
  // pour un départ déclaré près de la limite du Integer, et l'aide
  // de croissance refuse silencieusement un index négatif
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... enregistrer l'entrée ...
end;
Les deux bornes qui suivent le Break appartiennent à la même réparation. HPDFEnsureDirectXrefLength refuse de faire grandir le tableau pour un numéro d'objet négatif sans rien en dire, et First + I déborde pour un départ déclaré près de la limite du Integer, donc un index négatif atteint les écritures en dessous. Le plafond sur les numéros d'objets de Stream.Size div 8 est la réponse générale bon marché, puisque aucune table de références croisées traditionnelle ne peut décrire plus d'objets que le fichier n'a de place pour en contenir, et tout en-tête qui prétend le contraire décrit un fichier qui n'existe pas. Si vous réparez à la main une table endommagée, le même raisonnement s'applique depuis l'autre côté, c'est le territoire couvert par les notes sur le diagnostic et la réparation des PDF édités à la main
Comment prouver qu'un correctif de blocage fonctionne vraiment ?
En exécutant l'ancien code, pas en le relisant. Un blocage est l'une des rares classes de défauts où un correctif se vérifie avec un signal binaire et sans instrumentation, parce que le processus retourne ou ne retourne pas, et raisonner sur le flux de contrôle est exactement la compétence qui a produit le bug en premier lieu. La mécanique vaut la peine d'être copiée. Extrayez la révision d'avant correctif des unités modifiées dans un répertoire scratch, puis compilez une petite sonde avec le chemin de recherche d'unités plaçant ce répertoire devant la vraie bibliothèque : dcc32 -U<scratchdir>;<Lib> probe.dpr. Le compilateur prend les anciennes sources pour ce qu'il trouve en premier et les sources courantes pour tout le reste, donc un seul binaire de sonde exerce l'ancien parser contre le reste de la bibliothèque. Lancez-le sous un timeout — quarante secondes, c'est généreux — et traitez le code de sortie 124 comme l'assertion. Retirez ensuite les unités du répertoire scratch une à une et recompilez. Les trois blocages se sont reproduits de cette façon, chacun attribuable à une unité précise, et tous les trois ont disparu une fois la source corrigée de retour dans le chemin, au prix d'une compilation par unité
Deux pièges valent la peine d'être connus avant d'essayer. Le chemin de recherche d'unités est silencieusement permissif : donnez à -U un chemin au style Unix depuis un shell, comme $PWD, et le compilateur ignore ce répertoire sans un mot, ce qui signifie que votre sonde a compilé contre les sources courantes et réussi pour la mauvaise raison. Convertissez d'abord le chemin au format natif Windows. Le second, c'est que le répertoire scratch ne transporte pas les fichiers include, donc il faut aussi -I<Lib> pour HotPDF.inc, sinon la compilation échoue d'une façon qui ressemble à un problème de source plutôt que de chemin. Et soyez honnête sur ce que la méthode ne vous donne pas : elle confirme qu'une entrée précise a cessé de bloquer sur une compilation précise, et ne dit rien des entrées auxquelles vous n'avez pas pensé. Les défauts sans progression se trouvent par fuzzing ou en lisant chaque branche de chaque tokenizer, pas par des tests de régression écrits après coup
Quoi auditer dans vos propres parsers
La règle réutilisable est un contrat, pas une case à cocher. Toute fonction qui lit un curseur partagé doit, sur chaque chemin y compris ses chemins d'échec, soit consommer au moins un octet, soit retourner une valeur que l'appelant ne peut pas confondre avec « réessaie ». Mélanger ces deux sens dans un même nil ou un même token vide, c'est ce qui transforme un refus en blocage. Auditez donc la forme plutôt que le symptôme. Trouvez chaque boucle dont la terminaison dépend d'un curseur que possède une autre fonction, et demandez ce qui se passe quand cette fonction refuse l'octet courant. Trouvez chaque branche de repli écrite comme « lire jusqu'à X » et demandez ce qu'elle fait quand le curseur est déjà sur X. Trouvez chaque boucle bornée par un compteur venu du fichier plutôt que des données, et faites en sorte qu'un élément en échec termine la boucle au lieu de sauter une itération. Là où la même grammaire est analysée à deux endroits, faites un diff, parce que l'un des deux aura reçu un correctif que l'autre n'a pas. Et mettez un contrôle d'annulation dans toute boucle qui peut tourner sur un nombre d'itérations fourni par l'appelant, pour que l'opérateur ait quelque chose à tirer quand le prochain de ces cas se pointera en production
Les parsers décrits ici sont livrés dans le HotPDF Delphi Component actuel pour Delphi et C++Builder, avec les enregistrements de statistiques et les limites de profondeur exposés pour que votre propre durcissement puisse s'appuyer dessus