HotPDF peut enregistrer un document chargé sous une forme de diagnostic conçue pour être lue et modifiée par un humain, puis réparer le fichier après que vous l'avez édité. SaveLoadedDocumentDiagnostic écrit le document avec un ordre de dictionnaire déterministe, chaque objet comme un objet indirect normal, sans flux d'objets, sans flux de table de références croisées et sans linéarisation. RepairDiagnosticDocument reconstruit ensuite les décalages d'octets, les longueurs de flux, la table de références croisées et le trailer que votre édition a invalidés
Cette paire existe pour un seul flux de travail : comprendre ou corriger ce qui se trouve réellement à l'intérieur d'un PDF. Tout développeur ayant déboggué un problème de rendu a voulu ouvrir le fichier, changer un nombre dans un dictionnaire, et regarder le résultat. Dans un PDF normal, c'est impossible, car le contenu est compressé dans des flux d'objets et chaque octet que vous insérez décale des offsets qu'une table de références croisées enregistre exactement
Qu'est-ce qui rend un enregistrement de diagnostic différent ?
Six réglages changent ensemble. Les clés de dictionnaire sont écrites dans un ordre déterministe, si bien que deux enregistrements du même document produisent des fichiers comparables. Le mode de sortie diagnostic annote la structure. La réécriture complète est forcée, si bien que rien n'est repris comme une révision incrémentale non modifiée. La linéarisation est désactivée, puisqu'un fichier linéarisé est organisé pour un visualiseur web plutôt que pour un lecteur humain. Les flux de références croisées sont désactivés, si bien que la table est en texte brut. Et les flux d'objets sont désactivés, si bien qu'aucun objet n'est caché dans un conteneur compressé
Le résultat est un fichier dont l'en-tête porte un marqueur de diagnostic aux côtés de la signature %PDF- habituelle, et dont vous pouvez parcourir le corps dans n'importe quel éditeur. Les objets apparaissent les uns après les autres, les dictionnaires sont lisibles, et les flux de contenu se trouvent là où vous pouvez les trouver. L'outil de réparation vérifie la présence de ce marqueur et refuse les fichiers qui en sont dépourvus, car la structure compacte d'un PDF normal n'est pas quelque chose qu'un réparateur par plages d'octets devrait tenter d'interpréter

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Lisible, un objet par bloc, rien de caché dans des flux d'objets
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Pourquoi l'édition casse-t-elle le fichier, et qu'est-ce qui doit être reconstruit ?
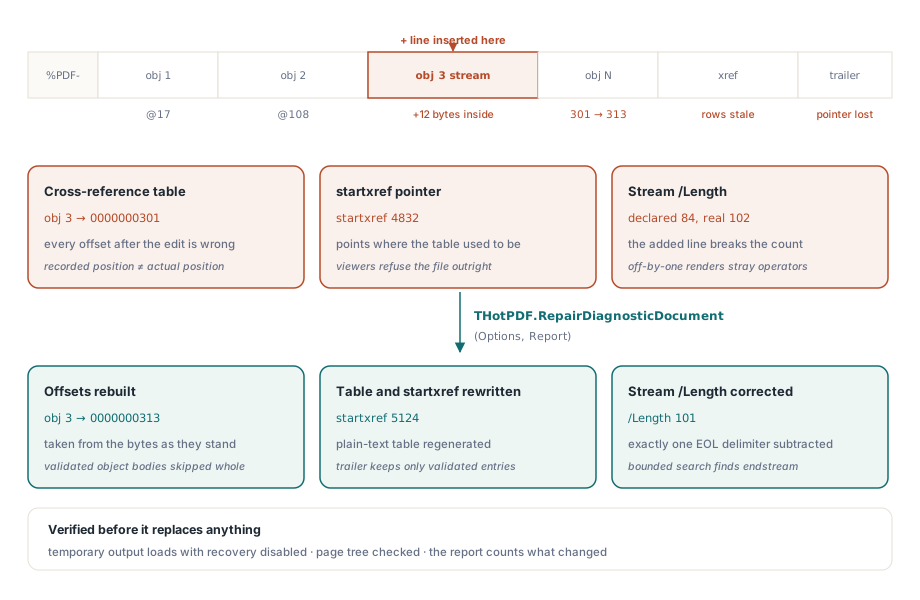
Trois éléments d'un PDF encodent des positions ou des comptes d'octets. La table de références croisées associe chaque numéro d'objet à un décalage d'octet. La valeur startxref à la fin du fichier pointe vers la table. Et chaque dictionnaire de flux porte un /Length indiquant combien d'octets occupe le corps du flux
Changez un caractère n'importe où avant la fin du fichier et les décalages qui suivent deviennent faux. Ajoutez une ligne à un flux de contenu et son /Length devient faux également. La plupart des visualiseurs refuseront le fichier, et ceux qui le récupèrent le font en balayant, ce qui masque l'erreur plutôt que de la corriger. La réparation reconstruit les trois éléments à partir de ce que les octets disent réellement désormais
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // charge le résultat avant de le remplacer

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Copier les octets, ne pas resérialiser
La décision de conception qui rend cet outil fiable est qu'il ne charge jamais le document pour le réécrire intégralement. Il copie les plages d'octets des objets qu'il a validés, ne change que les valeurs /Length qui sont erronées, et reconstruit la table, le trailer et le startxref autour d'eux
Charger puis resérialiser serait bien plus facile à implémenter et changerait discrètement des choses. Une syntaxe d'objet inconnue serait normalisée, les échappements de chaîne seraient réécrits dans la forme préférée de l'écrivain, et les charges utiles de flux déjà encodées pourraient être réencodées. Pour un outil de débogage, c'est inacceptable : vous avez édité un nombre, et le diff doit montrer un nombre, pas mille changements de formatage accidentels. Si vous voulez savoir exactement ce qui a changé entre deux fichiers, c'est un problème de comparaison, traité dans comparer deux fichiers PDF par structure et par pixels

Les deux règles d'analyse qui empêchent les faux objets
Un scanner par plages d'octets fait face à un piège évident : un texte qui ressemble à un en-tête d'objet peut apparaître à l'intérieur d'une charge utile de flux ou d'une chaîne. Un balayage naïf émettrait une ligne de table de références croisées pointant vers le milieu d'un flux de contenu, et le fichier résultant serait cassé d'une manière nouvelle et plus déroutante encore
HotPDF évite cela en sautant l'intégralité de la plage d'octets de chaque objet validé, en utilisant son décalage de fin enregistré, si bien que rien à l'intérieur du corps d'un objet n'est jamais considéré comme candidat. Entre les objets, seuls les espaces blancs et les commentaires PDF sont autorisés ; tout le reste signifie que la région n'est pas comprise et que ses octets ne doivent pas être intégrés dans la sortie
Les longueurs de flux exigent le même soin. La longueur réelle de la charge utile exclut le délimiteur de fin de ligne qu'un écrivain insère avant endstream. Quand la longueur déclarée tombe exactement sur le marqueur, cette déclaration est acceptée. Quand ce n'est pas le cas, le réparateur effectue une recherche bornée de la paire endstream et endobj et soustrait exactement un délimiteur, un CR, un LF ou un CRLF. Se tromper d'un seul octet ici produit un fichier qui s'ouvre et affiche une page avec un opérateur parasite à la fin de son flux de contenu
Ce que le trailer est autorisé à conserver
Le trailer reconstruit n'est pas une copie de l'ancien. /Size, /Prev et /XRefStm décrivent tous la mise en page antérieure du fichier et sont recalculés ou supprimés. Seules les entrées dont les cibles ont été validées survivent : /Info, /ID et /Encrypt. Et /Root doit se résoudre en exactement un objet Catalog — ni zéro, ni plusieurs, ce que produit typiquement un fichier assemblé par copier-coller de blocs d'objets
La sécurité de sortie est gérée comme il se doit pour un outil qui travaille sur des fichiers auxquels les gens tiennent. Le résultat est écrit dans un fichier temporaire du répertoire cible, puis vérifié en le chargeant via le chemin normal avec la récupération de références croisées désactivée, si bien qu'un fichier qui ne s'ouvre que grâce à la récupération compte comme un échec. Ce n'est qu'une fois l'arbre des pages vérifié que le fichier temporaire remplace atomiquement la cible. Une réparation échouée n'écrase jamais une sortie existante
Budgets et codes d'échec honnêtes
Trois limites bornent le travail : octets en entrée, nombre d'objets candidats et numéro d'objet maximal, avec pour valeurs par défaut 8 Gio, deux millions et deux millions. Le plafond du numéro d'objet compte plus qu'il n'y paraît, car une table éparse avec quelques objets numérotés dans les milliards gonflerait sinon énormément la table de références croisées reconstruite. Les tables de références croisées classiques rejettent également les décalages qui nécessiteraient plus de dix chiffres décimaux, ce qui est une limite de format plutôt qu'un choix d'implémentation
Les échecs rapportent un statut précis plutôt qu'un booléen : arguments invalides, source trop volumineuse, pas un fichier de diagnostic, limite d'objets dépassée, objet invalide, objet dupliqué, catalogue manquant, trailer invalide, erreur de sortie, ou validation échouée. Chacun correspond à une correction différente. Un objet dupliqué signifie que vous avez collé un bloc d'objet deux fois. Un catalogue manquant signifie généralement que l'objet portant /Type /Catalog a été endommagé. Validation échouée signifie que la structure est désormais cohérente mais que l'arbre des pages ne se charge pas, ce qui est typiquement un tableau /Kids édité de façon désynchronisée par rapport à son /Count
Deux notes pratiques bouclent la boucle. Conservez le fichier de diagnostic, pas seulement le fichier réparé, afin que la prochaine édition parte d'une base lisible. Et n'envoyez pas de sortie diagnostic aux utilisateurs finaux : elle est plus volumineuse qu'un enregistrement normal puisque rien n'est compressé dans des flux d'objets, et la voie de production pour un fichier compact est le chemin d'enregistrement ordinaire décrit dans flux d'objets et mises à jour incrémentales. Quand l'objectif est de trouver ce qui ne va pas plutôt que de le changer, la voie automatisée dans l'automatisation des rapports de préflight répond plus vite que la lecture des octets
L'enregistrement diagnostic, la réparation, le préflight et la comparaison opèrent tous sur le même modèle de document chargé en Delphi et C++Builder ; la liste complète des fonctionnalités se trouve sur la page du composant PDF HotPDF Delphi