Ouvrez un PDF produit par Microsoft Word ou Excel, parcourez-le, rien ne semble inhabituel. Chargez-le dans un programme Delphi, lisez le nombre de pages, le chiffre est correct. Ré-enregistrez-le ensuite avec le chiffrement activé et l'étape d'enregistrement lève une exception, ou le fichier produit s'ouvre sur un avertissement de référence croisée endommagée. Le fichier n'a jamais été corrompu. C'est un fichier à références hybrides (hybrid-reference file), et la structure même qui permet à une visionneuse vieille de quinze ans de l'ouvrir est celle qui met en échec un chargeur qui cesse de lire trop tôt
C'est l'une des façons les plus courantes pour qu'un pipeline PDF qui a réussi tous les tests internes rencontre un fichier qu'il ne peut pas traiter de bout en bout (round-trip). Les entrées ont toutes été générées en interne, elles n'ont donc jamais été hybrides. Le premier fichier hybride arrive le jour où un client fait suivre une facture exportée à partir d'un tableur
Ce que Word et Excel écrivent réellement
L'ISO 32000-1 décrit la disposition des références hybrides au §7.5.8.4. Une application qui souhaite des fonctionnalités PDF 1.5 telles que les flux d'objets (object streams), tout en laissant un lecteur PDF 1.4 ouvrir le fichier, écrit les informations de référence croisée deux fois. Il y a une table de références croisées classique, les lignes ASCII de largeur fixe qui terminaient chaque PDF jusqu'à la version 1.4, et il y a un flux de références croisées (cross-reference stream) qui indexe le reste. Le trailer de la section classique porte une entrée /XRefStm dont la valeur est le décalage en octets (byte offset) de ce flux
La répartition du travail est délibérée. Les objets qu'un ancien lecteur doit pouvoir atteindre, le catalogue et l'arborescence des pages entre autres, sont adressables depuis la table classique. Les objets rangés dans des flux d'objets compressés sont marqués libres dans la table classique, avec une entrée de type f, si bien qu'un lecteur 1.4 les saute sans jamais buter sur une structure qu'il ne peut pas analyser. Leurs emplacements réels ne figurent que dans le flux de références croisées. La signature d'un tel fichier se lit dans sa queue : une courte section classique limitée aux objets dont un lecteur ancien a besoin, dont le trailer pointe vers le /XRefStm où résident les véritables données de récupération
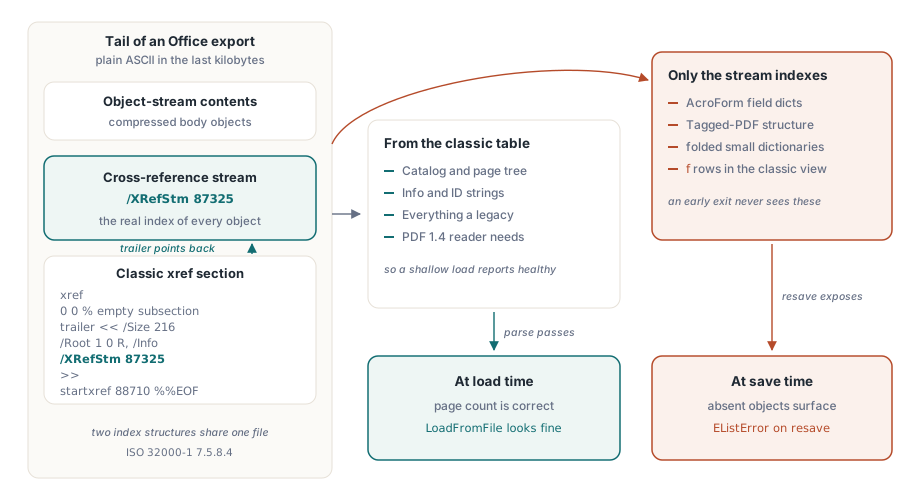
/XRefStm de son trailer mène au flux qui détient le reste de l'index des objetsPourquoi un nombre de pages correct ne prouve rien
Parce que le catalogue et l'arborescence des pages sont accessibles à partir de la table classique de manière intentionnelle, un chargeur qui ne lit que cette table trouve /Root, parcourt l'arborescence des pages et signale le bon nombre de pages. Tout ce dont un ancien lecteur a besoin est présent, le fichier semble donc sain. Les objets qui ont disparu sont ceux qui sont regroupés dans des flux d'objets : les dictionnaires de champs AcroForm, les éléments de structure PDF balisés (tagged-PDF), la longue traîne de petits dictionnaires qui n'ont jamais eu à être visibles pour une ancienne visionneuse
Vous ne remarquez pas l'écart jusqu'à ce que quelque chose touche ces objets, et un ré-enregistrement complet les touche tous. Parcourir le document pour le re-chiffrer ou le réécrire est précisément l'opération qui demande chaque numéro d'objet à tour de rôle, c'est pourquoi le symptôme fait surface au moment de l'enregistrement (save time) plutôt qu'au moment du chargement (load time), loin de sa cause
Le piège est un détecteur qui voit xref et s'arrête
Le moyen économique (cheap way) de décider comment un fichier est indexé est de suivre startxref et d'inspecter les premiers octets qu'il pointe. Le mot-clé xref signifie une table classique ; un objet flux (stream object) signifie un flux de références croisées. Ce test est correct pour tout fichier qui s'engage sur un seul schéma. Il est faux pour un fichier hybride, dont startxref vise une section classique dans le seul but de satisfaire les anciens lecteurs, tandis que le /XRefStm dans le trailer de cette section est l'endroit où la majeure partie du document est réellement indexée. Un détecteur qui renvoie "classique" sur le premier xref qu'il rencontre ne lit jamais /XRefStm, et chaque objet qui ne vit que dans le flux devient invisible
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // les pages sont accessibles depuis la table classique
    // inspectez ou modifiez le document chargé ici
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // a besoin de chaque objet, y compris ceux des flux
  finally
    Pdf.Free;
  end;
end;
Exécutez cette séquence sur un chargeur bâti autour du détecteur à sortie anticipée et le chargement semble correct ; c'est au ré-enregistrement que les objets absents se manifestent. La solution n'est pas de lire plus d'octets au départ ; c'est de reconnaître le trailer hybride et de suivre le /XRefStm avant de déclarer la lecture du fichier terminée
L'ordre de fusion (Merge order) n'est pas négociable
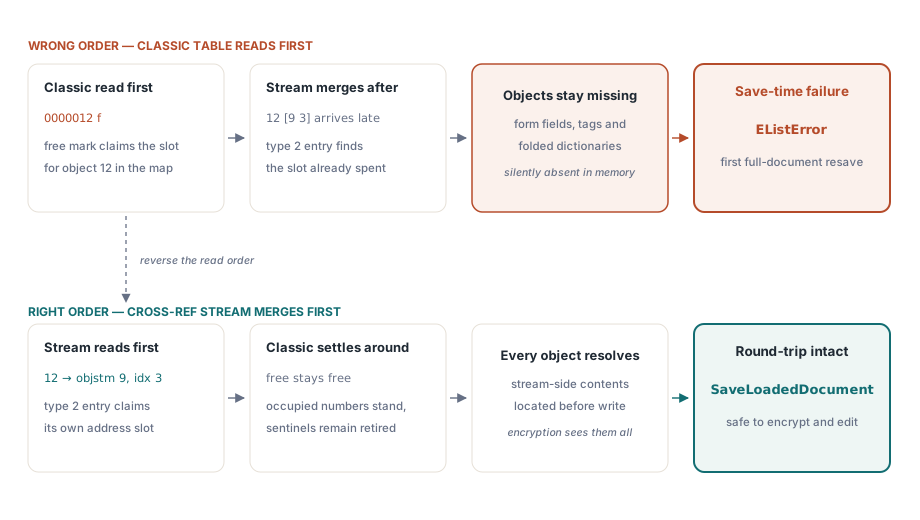
Une fois les deux index lus, ils ne peuvent être combinés que dans une seule direction. Le flux de références croisées doit être fusionné en premier, avec les entrées classiques remplies autour de lui. La raison en est la petite tromperie au cœur du format. Un fichier hybride marque ses objets compressés comme libres dans la table classique afin que les anciens lecteurs les ignorent. Un chargeur qui honore une politique de type "le premier vu gagne" (first-seen-wins) et lit la table classique en premier enregistrera ces numéros d'objet comme libres, puis rejettera les entrées de flux qui les localisent réellement, car les emplacements (slots) sont déjà pris. Inversez l'ordre et les entrées de type 2 du flux, chacune étant un numéro de flux d'objets (object-stream number) plus un index, gagnent les emplacements qu'elles sont censées posséder, et les entrées classiques s'installent autour d'elles
La même discipline empêche une ancienne révision de ressusciter un objet supprimé. Les mises à jour incrémentielles s'enchaînent vers l'arrière via /Prev, et une entrée libre de type 0 est une sentinelle indiquant qu'une section plus récente a retiré un numéro d'objet. Une section ultérieure plus ancienne dans la chaîne ne doit pas être autorisée à écraser cette sentinelle avec un emplacement obsolète (stale location). Traitez le premier vu (first-seen) comme faisant autorité pour les marqueurs libres et l'objet supprimé reste supprimé ; traitez-le sans précaution et l'historique du fichier lui-même réanime le contenu que la dernière révision a supprimé
Comment les deux vues divergent
Tout ce qui précède suppose que les deux index sont d'accord. À la sortie de Word, c'est le cas : chaque vue décrit le même document dans le périmètre qu'elle déclare. Les ennuis commencent quand le fichier passe entre les mains d'un outil qui n'en comprend qu'une. Les utilitaires d'apposition de tampons sont les suspects habituels. L'un ajoute une mise à jour incrémentielle de style classique avec quelques objets nouveaux, une nouvelle section xref, un lien /Prev vers la section précédente et un trailer tout neuf. Si ce trailer abandonne le /XRefStm, la vue flux se retrouve orpheline. S'il recopie l'ancienne valeur telle quelle, la vue flux décrit toujours le document tel qu'il était avant l'apposition du tampon. Dans les deux cas, les index divergent
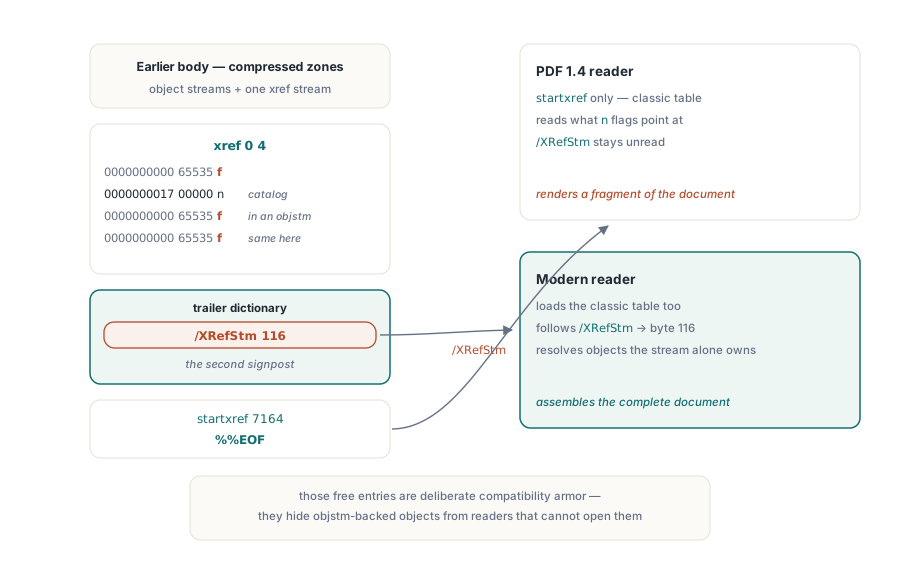
La signature est facile à repérer quand on la connaît. Les objets visibles par une vue sont absents ou périmés dans l'autre. Un lecteur qui résout via le flux tombe sur la version d'avant modification d'un objet mis à jour, ou ne trouve aucune entrée pour un objet ajouté. Un lecteur qui ne se fie qu'à la table voit la modification mais perd tous les objets compressés que le flux seul pouvait localiser. Les utilisateurs décrivent ça comme des champs de formulaire présents dans une visionneuse et disparus dans une autre, des annotations que le passage du tampon semble avoir supprimées, ou des résolutions qui tombent sur un objet complètement faux
Adobe Acrobat est ce qui rend ces fichiers si coûteux à traquer. Quand l'index déclaré contredit les octets, Acrobat reconstruit en général silencieusement les données de référence croisée en scannant les en-têtes d'objets, si bien que celui qui a produit le fichier cassé l'ouvre, ne voit rien d'anormal et le fait suivre. La défaillance surgit plus tard et ailleurs — un validateur preflight, un service de signature, une tâche d'ingestion d'archives — n'importe quel consommateur qui se fie à la structure déclarée et signale des objets manquants ou une incohérence de référence croisée. « Il s'ouvre très bien dans Acrobat » : c'est ainsi que commence à peu près chaque ticket de désynchronisation hybride
Ce que cela signifie dans HotPDF
Le moteur résout les fichiers à références hybrides pour vous, et il le fait sur chaque chemin qui doit analyser les données de référence croisée. Chargez un document avec LoadFromFile ou LoadFromStream, effectuez vos modifications, puis appelez SaveLoadedDocument ; ou lancez une opération ponctuelle telle que EncryptFile, qui lit une entrée et écrit une sortie. Dans les deux cas, la récupération lit le /XRefStm, fusionne la section de flux devant les entrées classiques et résout les objets qui vivent dans des flux avant que l'écriture ne les énumère. Le chemin de chiffrement AES-256 est celui où cela se voit le plus clairement : chiffrer un document réécrit chaque objet et exige donc que chaque objet ait déjà été localisé
// Opération ponctuelle : lisez l'entrée hybride, écrivez une copie chiffrée AES-256
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
Le détail qui vaut la peine d'être retenu se situe en amont de l'API. Les fichiers qui arrivent de Word, Excel, PowerPoint et d'une longue liste de pipelines "Enregistrer au format PDF" sont couramment hybrides, de sorte qu'un chargeur que vous n'exercez que contre la sortie de votre propre générateur peut ne jamais en rencontrer lors des tests. Alimentez (Seed) vos fixations de test (fixtures) avec des documents exportés depuis de véritables applications Office, et non seulement avec des fichiers produits par votre propre code
Vérification d'un fichier que vous suspectez
Deux inspections règlent la question rapidement. Ouvrez le fichier dans une vue hexadécimale et lisez les octets après le dernier startxref ; un fichier hybride montre une courte section classique dont le dictionnaire de trailer contient /XRefStm. Ou comparez le nombre d'objets qu'une analyse complète (full parse) signale avec le numéro d'objet le plus élevé que /Size déclare dans le trailer. Un grand écart (large gap) signifie que des objets se cachent dans des flux que le chargeur n'a pas ouverts, ce qui est le même manque (shortfall) qui se transforme plus tard en un échec au moment de l'enregistrement
La queue (tail) d'une exportation Excel typique rend la première vérification concrète. Tout ce qui se trouve après le mot-clé final xref est du simple ASCII, la signature est donc lisible directement depuis une vue hexadécimale (décalages illustratifs, annotations ajoutées)
xref
0 16                         % objets 0-15 : ce dont un lecteur ancien a besoin
0000000000 65535 f
0000000017 00000 n
...                          % 14 lignes de plus ; le reste vit dans des flux d'objets
trailer
<< /Size 216                 % un de plus que le plus grand numéro d'objet utilisé
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % décalage en octets du flux de références croisées
>>
startxref
88710                        % pointe sur la section classique ci-dessus
%%EOF
La clé /XRefStm dans le trailer est le signe révélateur. La section classique au-dessus d'elle liste 16 des 216 numéros d'objet que le fichier utilise ; tout ce qui est rangé dans des flux d'objets en est absent ou y est marqué libre. Un détecteur qui s'arrête au mot-clé xref n'a vu, à ce stade, que cet index partiel. Quand vous préférez scripter la vérification plutôt que de contrôler à l'œil, le marqueur se trouve dans les derniers kilo-octets du fichier, donc une lecture arrière bornée suffit. Si le fichier a ensuite reçu des mises à jour incrémentielles, la queue contient plus d'un trailer, et celui qui compte est le dernier
// Renvoie le décalage /XRefStm du trailer le plus récent de la queue du
// fichier, ou -1 si le marqueur est absent (non hybride, ou pas un PDF)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P, Q: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // le trailer vit dans la queue du fichier
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // lecture arrière bornée : 2 Ko max
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := 0;                               // garder le dernier marqueur : mises à jour
  Q := Pos(AnsiString('/XRefStm'), Tail); // les mises à jour apposent des trailers plus récents
  while Q > 0 do
  begin
    P := Q;
    Q := Pos(AnsiString('/XRefStm'), Tail, P + 1);
  end;
  if P = 0 then
    Exit;                               // pas de marqueur hybride dans la queue
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // saute les blancs après la clé
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Utilisation : un résultat non négatif donne l'octet où commence le flux
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Traitez la sonde comme un triage, pas comme un analyseur : elle indique quels fichiers d'un lot méritent qu'on s'y arrête avant qu'une tâche de ré-enregistrement ne s'exécute, et rien de plus
Pointez-la sur un dossier d'entrées réelles et les fichiers se répartissent en trois groupes. Un fichier purement classique possède un mot-clé trailer dans sa queue mais pas de /XRefStm, la sonde renvoie donc -1. Un fichier entièrement engagé dans les flux de références croisées renvoie lui aussi -1, correctement : il n'a aucun mot-clé trailer, ses clés de trailer vivant dans le dictionnaire du flux. Seule la disposition doublement indexée produit un décalage. Si votre rapport de triage doit distinguer les deux premiers groupes, cherchez trailer dans la même queue avant de la jeter ; un appel de Pos de plus suffit
Avant de laisser la sonde tourner sans surveillance, renforcez-la à deux endroits. Un décalage n'est qu'une affirmation. Placez-vous à cet endroit et vérifiez qu'un objet dont le dictionnaire dit /Type /XRef s'y trouve réellement, car un fichier endommagé ou tronqué peut encore porter la clé alors que le flux qu'elle désigne a disparu. Ce fichier mérite un compartiment différent de celui d'un hybride sain. La vérification tient en quelques lignes par-dessus la même gestion de fichier
// Offset est la valeur renvoyée par FindXRefStm ; FS est un TFileStream
// ouvert de la même façon, Head un AnsiString (Min vient de System.Math)
if Offset >= FS.Size then
  Exit(False);                          // la clé a survécu, pas le flux
FS.Position := Offset;
SetLength(Head, Integer(Min(Int64(512), FS.Size - Offset)));
FS.ReadBuffer(Head[1], Length(Head));
Result := (Pos(AnsiString('/Type /XRef'), Head) > 0) or
  (Pos(AnsiString('/Type/XRef'), Head) > 0);  // la syntaxe PDF autorise les deux écritures
Faites ensuite de la fenêtre de 2 Ko un paramètre. Deux kilo-octets couvrent la production Office ordinaire, mais un dictionnaire de trailer inhabituellement gros peut repousser le marqueur hors de portée, et élargir la fenêtre vaut mieux que classer le fichier en classique par accident
Router les fichiers hybrides dans un pipeline
La détection paie quand elle change la destination suivante d'un fichier. Et cette destination dépend de ce que le pipeline s'apprête à en faire
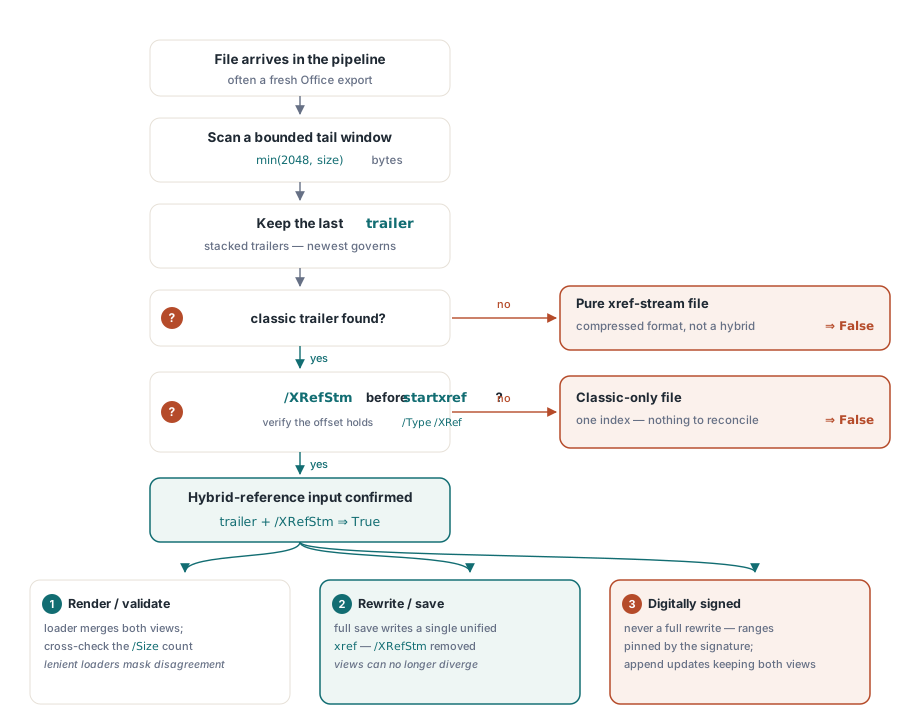
Les fichiers qui ne sont que lus, rendus ou validés doivent aller vers un chargeur qui résout les deux vues. Le PDFium Component analyse la chaîne /XRefStm au chargement, si bien que la table d'objets que voit votre code est déjà la version fusionnée, et les vérifications de notre article sur la validation des flux d'objets et de références croisées s'appliquent telles quelles. Quand un hybride désynchronisé est assez abîmé pour refuser le chargement, le moteur le signale par son code d'erreur de chargement, et FPDF_ERR_FORMAT est celui que produit un dégât structurel. Un chargement propre est une preuve plus faible. PDFium est tolérant par conception et reconstruit sans mot dire la plupart des fichiers incohérents, donc un succès prouve que le fichier était récupérable et ne dit rien de l'accord, ou non, de ses deux vues. Pour cette question-là, revenez à la comparaison entre ce que trouve un parcours complet des objets et le /Size du trailer
Les fichiers que le pipeline modifie sont une autre histoire. Notre préférence ici est sans détour : leur faire perdre leur statut hybride, tout simplement. Chargez le document avec HotPDF et enregistrez-le intégralement, et la sortie porte une référence croisée unique et cohérente sous une seule forme. Pas de /XRefStm, pas de seconde vue susceptible de dériver, chaque objet possédé par exactement une entrée d'index. Cette normalisation est ce qu'il vous faut avant une ingestion d'archives, avant un RIP ou un service de signature strict en aval, et après toute modification appliquée à une entrée hybride. Elle repose entièrement sur la fusion flux-d'abord décrite plus haut, puisqu'un enregistrement complet ne peut écrire que les objets que le chargement a réussi à localiser
Les documents signés font exception. Une réécriture complète déplace chaque octet, ce qui invalide toute signature calculée sur les plages d'octets d'origine. Une modification d'un hybride signé doit passer par une véritable mise à jour incrémentielle qui maintient les deux vues en phase, et un fichier signé qu'il suffit de lire doit traverser le pipeline sans être touché
Le côté rédacteur (writer's side) de cette histoire, la façon dont les flux d'objets et les références croisées compressées sont produits en premier lieu, est couvert dans notre article sur les flux d'objets et les mises à jour incrémentielles. Lorsque le fichier hybride en question est également très volumineux, les techniques de chargement de la présentation de l'API Direct File pour les flux de travail PDF volumineux vous permettent de l'inspecter sans le lire entièrement en mémoire. Les deux se marient naturellement avec la récupération décrite ici, qui est fournie dans le cadre du Composant HotPDF pour Delphi et C++Builder aux côtés des API de chargement, d'édition, de chiffrement et de signature couvertes ailleurs sur ce blog