"value":-.25 est ce que produit un écrivain JSON quand il copie tel quel un jeton de nombre PDF parfaitement légal, et un parseur RFC 8259 strict abandonne au point qui suit le signe moins. Ses voisins +1.5 et 007.5 du même tableau PDF échouent de la même façon. Transformer des nombres PDF en JSON veut dire ré-épeler chaque jeton chiffre par chiffre, écrire null pour NaN et Infinity, et garder la virgule décimale régionale hors de la sortie
Quatre orthographes que PDF accepte et que JSON rejette
Les deux grammaires se disputent quatre petits détails. ISO 32000-1 §7.3.3 laisse un nombre commencer par un signe plus, omettre la partie entière (.5), finir sur un point nu (4.) et porter des zéros initiaux (007.5). RFC 8259 §6 n'autorise rien de cela. Un nombre JSON a un signe moins optionnel, une partie entière qui vaut 0 ou commence par un chiffre de 1 à 9, et au moins un chiffre après tout point décimal. Les producteurs ont droit aux formes PDF, et les générateurs qui impriment les nombres avec leur propre code de formatage, ainsi que les fichiers que quelqu'un a corrigés à la main dans un éditeur de texte, les utilisent
La collision devient plus vive dans une bibliothèque qui respecte le texte source. PDF Library for Delphi (PDFlibPas) garde les caractères exacts qu'elle a parsés pour chaque nombre réel, si bien qu'une valeur de couleur calibrée se sauvegarde inchangée au lieu d'être arrondie aux quatre décimales par défaut ; le raisonnement se trouve dans la préservation de la précision décimale PDF parsée. Le tokenizer corrige déjà .5 en 0.5 et 4. en 4.0 pendant la lecture, et les entiers sont rebâtis depuis leur valeur, si bien que +3 revient en 3. Trois orthographes atteignent encore l'écrivain verbatim : un point de tête signé (-.25), un plus explicite sur un réel (+1.5) et des zéros initiaux (007.5)
Un écrivain qui colle ces caractères stockés directement dans le JSON produit un fichier qui a l'air très bien dans un éditeur. L'ennui commence au retour. SetObjectJSON renvoie 0, et LastErrorCode rapporte PDFLIB_ERROR_OBJECT_JSON_INVALID, qui vaut 105
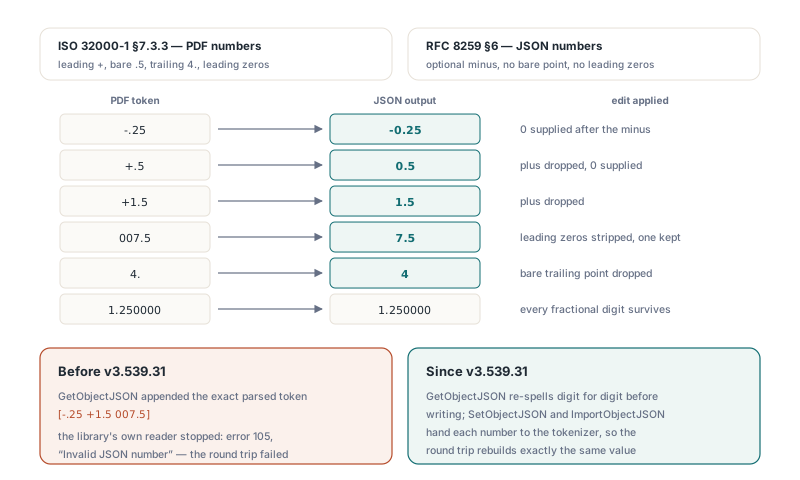
L'aller-retour ci-dessous est la façon la plus rapide de voir ce que GetObjectJSON émet réellement. Chaque nombre arrive enveloppé en {"type":"number","value":...}, et les trois jetons épineux sortent en -0.25, 1.5 et 7.5
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  JSON: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('legacy-drawing.pdf', '') = 0 then
      raise Exception.Create('load failed');

    // L'objet 12 est un tableau écrit [-.25 +1.5 007.5]
    JSON := Lib.GetObjectJSON(12, 0);
    if JSON = '' then
      raise Exception.CreateFmt('export failed, error %d',
        [Lib.LastErrorCode]);
    // Chaque élément se lit {"type":"number","value":-0.25} et ainsi de suite

    // SetObjectJSON renvoie 1 en cas de succès ; passez 0 pour Options
    if Lib.SetObjectJSON(12, JSON, 0) = 0 then
      raise Exception.CreateFmt('round trip rejected, error %d',
        [Lib.LastErrorCode]);

    Lib.SaveToFile('legacy-drawing-roundtrip.pdf');
  finally
    Lib.Free;
  end;
end;
Ré-épeler le jeton au lieu de le recalculer
GetObjectJSON édite les caractères stockés au lieu de formater le Double parsé. Elle lit un signe optionnel, ramasse les chiffres de part et d'autre d'un unique point décimal, puis ne fait que les retouches que JSON exige : le plus part, les zéros initiaux sont réduits à un, une partie entière vide devient 0, un point final nu est abandonné, et un signe moins est remis devant. Un jeton qui contient tout autre caractère, ou aucun chiffre du tout, est formaté depuis sa valeur parsée avec dix décimales à la place, et cette voie écrit null quand la valeur n'est pas finie
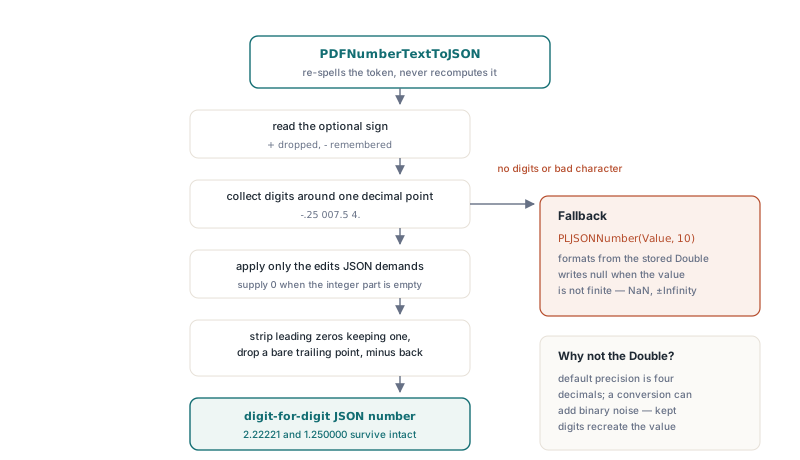
-.25devient-0.25, et+.5devient0.5+1.5devient1.5007.5devient7.5, tandis que0.75reste tel quel4.devient4si un tel jeton atteint jamais l'écrivain2.22221et1.250000gardent chaque chiffre fractionnaire, zéros finaux compris
Formater depuis le Double aurait tenu en une ligne, et elle aurait été fausse de deux façons. La précision de sortie par défaut du document est de quatre décimales, si bien que 2.22221 perdrait un chiffre. Monter la précision ne le sauve pas non plus : 0.1 n'a pas de forme binaire exacte, et une conversion à 17 chiffres significatifs imprime 0.10000000000000001. Garder les chiffres d'origine veut dire que SetObjectJSON et ImportObjectJSON, qui remettent chaque nombre JSON au tokenizer PDF, rebâtissent exactement la valeur que le fichier a déclarée
Cette promesse couvre la valeur. Les octets sont une autre affaire. Après une ré-importation, -.25 est stocké et sauvegardé en -0.25 ; les deux orthographes sont égales au sens du §7.3.3, pourtant un diff au niveau octet signale le changement. Sur un document dont les plages d'octets sont couvertes par une signature, nous ne ferions pas passer des objets par un cycle d'export et d'import du tout, à moins que le plan ne soit de signer à nouveau ensuite
Que signifie null dans la sortie de GetDocumentJSON ?
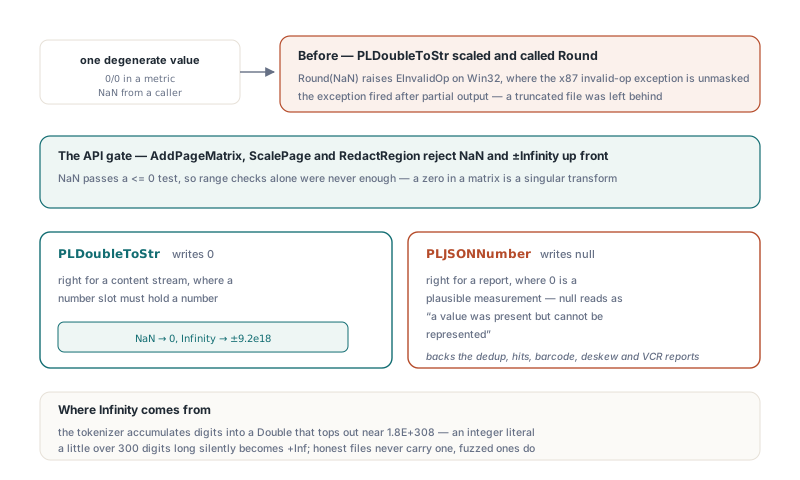
GetDocumentJSON écrit null pour tout nombre NaN ou infini, parce que RFC 8259 §6 n'a de syntaxe pour ni l'un ni l'autre. Infinity est plus facile à produire qu'on ne le croit. Le tokenizer PDF accumule les chiffres par multiplications répétées dans un Double, qui plafonne près de 1,8 × 10308, si bien qu'un littéral entier un peu plus long que 300 chiffres devient +Inf pendant l'analyse. Les producteurs ordinaires n'écrivent jamais un tel littéral ; les fichiers fuzzés et hostiles le font, et voilà pourquoi un entier de 400 chiffres appartient au même corpus de test que les cas de le durcissement d'un parseur PDF Pascal contre les fichiers malveillants
Le contrôle de finitude doit venir d'abord. GetDocumentJSON imprime les valeurs intégrales sous MaxInt comme entiers et tout le reste avec le Str(D:0:6) de Pascal, ce qui va très bien pour 1,25 et est fatal pour +Inf, parce que Str écrit alors le texte +Inf et aucun consommateur JSON ne l'analysera. Le formatage à six décimales marque aussi ce qu'est le JSON de document : une vue d'ensemble du fichier entier. Quand vous avez besoin des chiffres exacts d'un objet, demandez GetObjectJSON pour cet objet
Le null est délibérément avec perte, et il partage son orthographe avec autre chose. Un objet null PDF sort aussi en null dans le JSON de document, si bien qu'un consommateur ne peut pas distinguer "le fichier a dit null" de "le fichier a dit un nombre trop grand pour un Double" en regardant cette seule valeur. GetObjectJSON les distingue : l'objet null PDF est écrit en {"type":"null"}, et un nombre garde son enveloppe "type":"number". Le code qui lit le JSON de document devrait accepter null partout où un nombre peut apparaître, journaliser le numéro d'objet, et traiter le fichier comme suspect au lieu de substituer 0
Pourquoi un seul NaN peut-il avorter un export SVG ou JSON ?
Un formateur de nombres qui met à l'échelle son entrée et appelle Round tombe sur Round(NaN), et sur Win32, où Delphi laisse l'exception invalid-operation du x87 démascarquée, cela lève EInvalidOp. L'exception se déclenche après que l'écrivain a déjà émis une partie de sa sortie. Une seule mesure dégénérée, un 0/0 à l'intérieur d'une métrique ou un NaN passé par un appelant, laisse un fichier tronqué sur le disque
PLDoubleToStr dans PDFlibExtra, le formateur invariant qu'utilise la bibliothèque pour les flux de contenu, le SVG, le XML, le CSV et la plus grande partie de son JSON, renvoie 0 pour NaN. Sa branche entière borne la valeur mise à l'échelle à ±9,2 × 10¹⁸ comme la branche fractionnaire, si bien qu'Infinity sort aussi comme un littéral fini. Dans un flux de contenu, c'est le bon choix. Un emplacement d'opérande doit tenir un nombre, et un lecteur qui rencontre +Inf au milieu d'un chemin n'a rien de sensé à dessiner
Dans un rapport, zéro est le mauvais choix, et nous y tenons fermement : 0 est un angle de redressement ou une erreur de pixel parfaitement plausible, si bien que l'écrire pour "pas de réponse" corrompt les données sans que personne ne le remarque. Les écrivains de rapports utilisent PLJSONNumber(Value, Decimals) de la même unité à la place, qui écrit null pour NaN ou Infinity et des chiffres invariants sinon. GetSimilarImageDeduplicationReportJSON, GetAnnotationHitsJSON et les rapports de codes-barres, de redressement, de texte structuré et de PDF/VCR passent tous par elle, si bien qu'un angle de redressement non fini atteint le consommateur en null
La même fonction est publique, si bien que votre propre JSON à côté de celui de la bibliothèque peut suivre la même règle. Le croquis ci-dessous bâtit un petit enregistrement de redressement ; la forme de l'enregistrement est la nôtre, l'appel de formatage est celui de la bibliothèque
uses
  SysUtils, PDFlibTypes, PDFlibExtra;

// Votre propre écrivain de rapport, avec la règle de nombres de la bibliothèque
function SkewReportJSON(Page: Integer; Angle, Confidence: Double): string;
var
  B: PLStringBuilder;
begin
  B := PLStringBuilder.Create(128);
  try
    // Formatez chaque Double en texte d'abord ; PLJSONNumber écrit null
    // pour NaN ou Infinity et emploie toujours un point décimal
    B.Append('{"page":').Append(Page)
     .Append(',"angle":').Append(string(PLJSONNumber(Angle, 4)))
     .Append(',"confidence":').Append(string(PLJSONNumber(Confidence, 4)))
     .Append('}');
    // Jamais B.Append(Angle) : sur Delphi cette surcharge suit la locale de l'utilisateur
    Result := B.ToString;
  finally
    B.Free;
  end;
end;
Où la locale de l'utilisateur se faufile dans le JSON
N'importe quel formateur qui consulte les paramètres régionaux peut mettre une virgule là où le JSON demande un point. PLFloatToStr dans PDFlibExtra est un fin habillage de FloatToStr, et c'est exactement ce qu'il fait. Écrivez un champ tel que maxAcceptedMeanError avec lui sur un bureau allemand ou français et vous obtenez "maxAcceptedMeanError":1,5. Un parseur JSON lit cela comme la valeur 1 suivie d'un token égaré. Ce champ rapporte la pire erreur de pixel acceptée depuis la déduplication perceptuelle d'images, et GetSimilarImageDeduplicationReportJSON l'écrit via PLJSONNumber(Stats.MaxAcceptedMeanError, 6), si bien que le séparateur reste un point quel que soit le réglage de la machine
La seconde voie est plus discrète. Sur Delphi, PLStringBuilder est un simple alias de System.SysUtils.TStringBuilder, dont la surcharge Append(Double) formate via la locale de l'utilisateur. Les builds Free Pascal utilisent à la place une petite classe de constructeur Unicode venue de PDFlibTypes, parce que le TStringBuilder du runtime FPC n'accepte que l'ANSI. Compilez la même source avec les deux et la build Delphi peut désaccorder de la build FPC. Un test qui ne tourne que sur Free Pascal, ou que sur une machine en-US, ne verra pas la virgule
Le test ci-dessous reproduit un bureau à virgule à l'intérieur du processus et remet le rapport à un parseur strict. Choisissez une entrée qui contient vraiment des images quasi dupliquées ; sans correspondances l'erreur moyenne vaut 0, et une valeur sans partie fractionnaire cache le problème du séparateur
uses
  System.SysUtils, System.JSON, PDFlibrary;

var
  Lib: TPDFlib;
  Report: WideString;
  Parsed: TJSONValue;
begin
  // Faites que ce processus se comporte comme un bureau allemand ou français
  FormatSettings.DecimalSeparator := ',';
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('scanned-batch.pdf', '') = 0 then
      raise Exception.Create('load failed');
    // Dry run avec seuils 2, 2, 4 : le document n'est pas modifié
    Lib.GetSimilarImageDeduplicationReportJSON(2, 2, 4, Report);
    Parsed := TJSONObject.ParseJSONValue(Report);
    // Ce contrôle nil est à ajouter par vous, pas une partie de la bibliothèque
    if Parsed = nil then
      raise Exception.Create('report is not valid JSON on a comma locale');
    Parsed.Free;
  finally
    Lib.Free;
  end;
end;
Trois entrées qui méritent de rester dans la suite de tests
La gestion des nombres dans le JSON est bon marché à casser et bon marché à garder. Une page portant -.25, +1.5 et 007.5 couvre le trou de grammaire ; vérifiez que la sortie de GetObjectJSON s'analyse et que SetObjectJSON renvoie 1. Un objet tenant un entier de 400 chiffres couvre le débordement ; le JSON de document doit montrer null à cette position. Un rapport produit avec DecimalSeparator réglé sur la virgule couvre la locale. Passez chacun dans un parseur strict plutôt que de lire la sortie à l'œil, car 1,5 et 1.5 sont faciles à manquer dans une longue ligne de JSON
Le JSON d'objet, le JSON de document et les rapports d'analyse partagent ces règles de nombres entre les builds Delphi, C++Builder et Free Pascal. La page produit de PDF Library for Delphi liste les éditions et le reste de l'API au niveau objet et de rapport