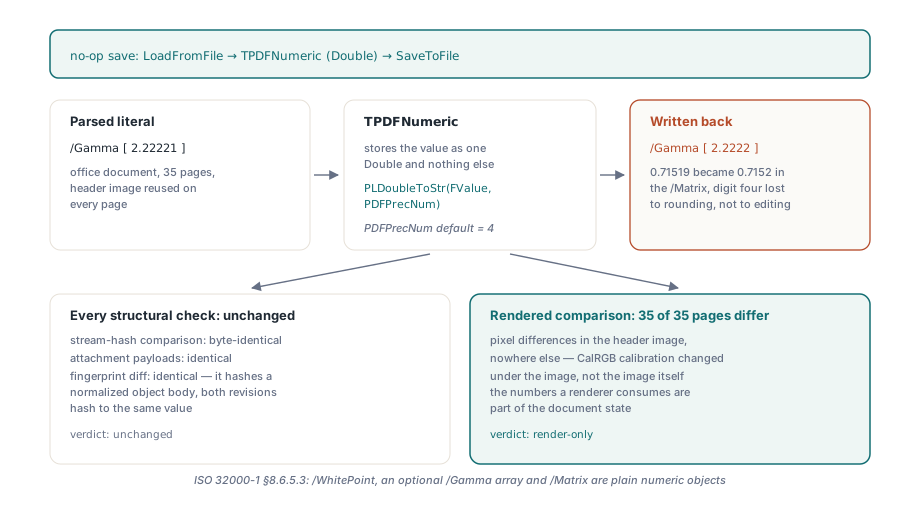
Chargez un PDF calibré, ne changez rien, sauvegardez-le sous un nouveau nom et comparez le dictionnaire d'espace de couleur : /Gamma [2.22221 2.22221 2.22221] est entré, /Gamma [2.2222 2.2222 2.2222] est sorti. L'écrivain a reformaté un nombre qu'il n'avait jamais à toucher, et la page se rend maintenant dans des couleurs légèrement différentes. Le remède est de traiter chaque décimal parsé comme deux choses à la fois, une valeur pour l'arithmétique et un littéral pour la sortie, et de continuer à émettre le littéral jusqu'à ce que quelqu'un assigne réellement une nouvelle valeur
Pourquoi une sauvegarde sans modification peut décaler les couleurs CalRGB
Les pixels bougent parce que le renderer reçoit des données de calibration légèrement différentes alors que les octets de l'image restent identiques. ISO 32000-1 §8.6.5.3 définit un espace de couleur CalRGB par un /WhitePoint obligatoire, un tableau /Gamma à trois éléments facultatif et un /Matrix à neuf éléments facultatif, et tous sont de simples objets numériques dans le dictionnaire d'espace de couleur. Faites-les passer par un Double et un formateur fixé à quatre décimales, et 2.22221 devient 2.2222 tandis qu'une entrée de matrice de 0.71519 devient 0.7152. Une valeur gamma est un exposant appliqué à chaque composante de chaque pixel qui passe par cet espace, donc le changement apparaît partout où l'espace est utilisé
Pour un fichier qui déclare un espace CalRGB pour une image d'en-tête réutilisée sur 35 pages, les 35 en-têtes se rendent avec des couleurs décalées et rien d'autre ne change sur ces pages. Les contrôles qu'on dégaine en premier reviennent propres. Un hachage des octets de flux décodés compare les données d'image, et les données d'image sont vraiment identiques ; le dégât se trouve dans un dictionnaire. Le diff de révisions décrit dans l'article sur le niveau de modification prend l'empreinte d'un corps d'objet normalisé, donc les deux révisions y hachent à la même valeur aussi. C'est une comparaison de pages rendues qui l'attrape. Pour tout pipeline qui réécrit des PDF produits par d'autres logiciels, nous mettrions une comparaison de rendu par page avant chaque contrôle structurel
À quoi un nombre réel PDF a le droit de ressembler
ISO 32000-1 §7.3.3 définit un nombre réel comme une chaîne décimale : un signe facultatif, des chiffres, un point, d'autres chiffres. Pas de notation de base. Pas de forme exponentielle. L'annexe C, qui liste les limites d'implémentation, attend qu'environ cinq chiffres décimaux significatifs de la partie fractionnaire soient honorés. Une précision de sortie par défaut de quatre se place donc déjà un chiffre en dessous de ce que la spécification dit aux lecteurs de conserver, et le fichier n'a rien fait de mal en en utilisant cinq
Près de zéro, un formateur naïf fait pire que perdre un chiffre. La façon courante d'imprimer un Double à N décimales est de multiplier par 10^N, d'arrondir à un entier et d'écrire les chiffres, et quand cet entier vaut zéro, la sortie est 0. Donnez-lui le premier opérande de 0.00001 0 0 1 0 0 cm à quatre décimales et le résultat est 0 0 0 1 0 0 cm, une matrice singulière qui fait disparaître tout ce qui est dessiné dessous. Une entrée /Matrix de -0.000012345 subit le même sort
Quand PDF Library for Delphi (PDFlibPas) doit formater lui-même un Double, il garde le nombre demandé de chiffres significatifs pour une valeur non nulle plus petite que le pas de précision au lieu d'écrire 0. À quatre décimales, 0.00001 s'écrit 0.00001 et 0.0000123 s'écrit 0.0000123 ; seules les magnitudes en dessous d'environ 5E-16 sortent encore en 0. Cela garde les nombres nouvellement écrits sains. Un nombre parsé qui n'a jamais eu besoin d'être reformaté est une autre affaire, et la bibliothèque le gère en ne le reformatant pas du tout
Comment PDFlibPas garde le littéral qu'il a parsé
TPDFStructure.Decode garde le texte source de chaque réel standard qu'il tokenise, c'est-à-dire un token avec un point décimal et sans marqueur d'exposant, juste à côté du Double converti. TPDFNumeric.Output réécrit ce texte chaque fois qu'il est présent et ne formate le Double au PDFPrecNum de la structure que lorsqu'il ne l'est pas. TPDFNumeric.SetTo jette le texte, parce qu'un nombre modifié est un nouveau nombre et doit suivre la précision de sortie courante
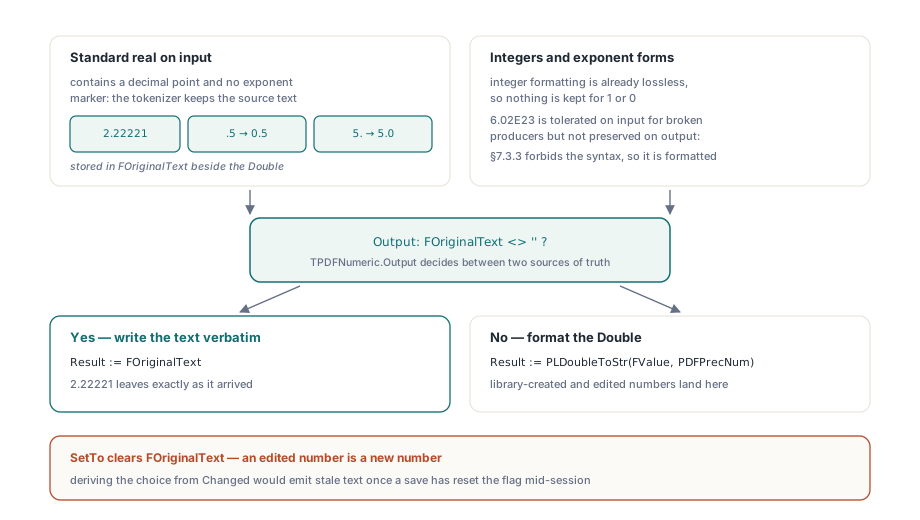
Lier la remise à zéro à SetTo était délibéré. Le raccourci tentant est d'émettre le texte d'origine sauf si le drapeau Changed de l'objet est levé, puisque ce drapeau existe déjà sur chaque objet. Mais le pipeline de sauvegarde efface Changed une fois l'objet écrit, donc une valeur modifiée, sauvegardée puis modifiée à nouveau dans la même session recommencerait à émettre son littéral périmé à la seconde sauvegarde. Effacer le texte dans l'affectation elle-même signifie que le littéral et la valeur ne peuvent jamais diverger
Quelques frontières sont intentionnelles. Les entiers ne sont pas stockés en texte parce que le formatage des entiers est déjà sans perte. Les formes exponentielles comme 6.02E23 sont acceptées en entrée par égard pour les producteurs qui les écrivent quand même, mais elles sont formatées comme tout nombre généré par la bibliothèque en sortie, puisque les recopier perpétuerait une syntaxe que §7.3.3 exclut. Le tokenizer applique aussi sa petite réparation habituelle avant de stocker le texte : un littéral à point initial comme .5 est gardé en 0.5, un littéral à point final comme 5. en 5.0. Chaque lecteur traite chaque paire comme le même nombre, et l'orthographe réparée est acceptée bien plus largement
L'extrait ci-dessous fait passer les valeurs CalRGB directement par la couche objet, pour que chaque règle se voie sans ouvrir de fichier PDF. Les lignes Assert sont des contrôles que nous suggérons d'ajouter à vos propres tests ; ce ne sont pas des appels à la bibliothèque
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Votre propre contrôle : une entrée non modifiée survit telle quelle, y compris
    // la valeur qu'un formateur naïf à quatre décimales réduirait à 0
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Une modification jette le texte d'origine et suit PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // Les nouvelles valeurs minuscules gardent leurs chiffres significatifs au lieu de devenir 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // Baisser la précision ensuite n'atteint pas l'entrée non modifiée
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Un piège quand on écrit des assertions de ce genre : le Round de Delphi utilise l'arrondi bancaire, et 0.000012345 * 1e8 vaut 1234.4999… en binaire plutôt que 1234.5. Nous sommes tombés en plein sur cette valeur en vérifiant le chemin de formatage près de zéro. Choisissez des entrées de test qui ne sont pas des milieux binaires chaque fois qu'une assertion dépend de l'arrondi du dernier chiffre
Que contrôle SetPrecision ?
TPDFlib.SetPrecision fixe les décimales des nombres que la bibliothèque écrit : les graphiques dessinés via le painter, les nombres créés depuis un Double par exemple via NewNumeric, et les valeurs parsées qui ont depuis été changées avec SetTo. Il accepte 2 à 8 et renvoie 0 pour tout ce qui sort de cette plage. Un décimal parsé que personne n'a modifié garde son texte d'entrée quel que soit le réglage, et changer le réglage après LoadFromFile ne remonte pas jusqu'à lui. Le source passé à SetObjectFromString passe par le même tokenizer et est conservé de la même façon
Notre recommandation est de laisser SetPrecision tranquille sauf si la géométrie que vous générez a besoin de pas plus fins. Le relever pour protéger les fichiers d'entrée n'apporte rien, parce qu'une entrée intacte garde déjà ses propres chiffres, et cela allonge chaque nombre que vous dessinez. Cinq décimales sont un choix raisonnable pour du dessin sous le point ; huit gonfle surtout les flux de contenu
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Gouverne les nombres écrits à partir d'ici ; les tableaux /Gamma,
    // /Matrix et /WhitePoint parsés gardent leur texte d'origine
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // les nombres dessinés utilisent cinq décimales
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Flux de contenu : les modifications gardent les opérandes, la normalisation est opt-in
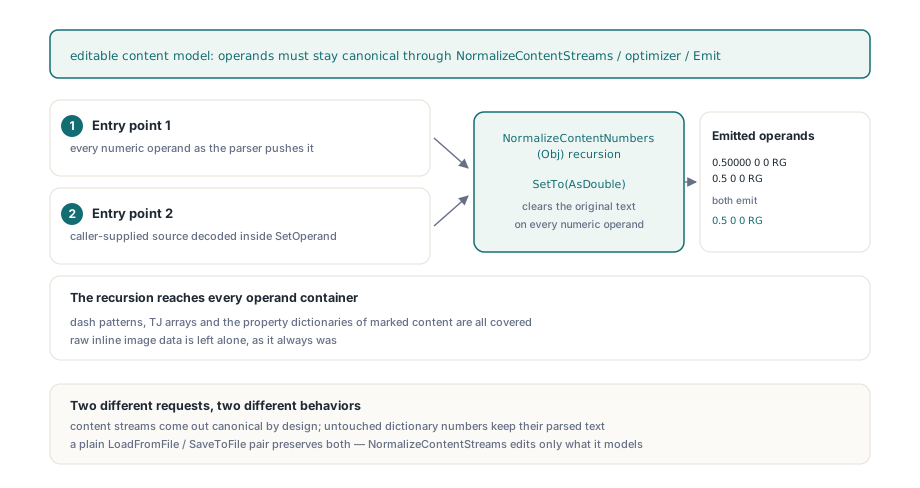
Le modèle de contenu éditable garde le texte des opérandes par défaut et ne canonise les nombres que lorsque la sortie canonique est le but de l'appel. TPDFContentProgram.CanonicalNumbers vaut False par défaut, donc une couche renvoyée par ParsePageContentLayer, le même modèle sur lequel est bâti le traqueur d'état graphique, réémet chaque opérande numérique intact exactement tel qu'écrit. Les modifications de page qui réécrivent une couche entière, dont ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths et votre propre programme réécrit avec WritePageContentLayer, ne changent que les opérandes que la modification a touchés
L'autre défaut a l'air plus propre : canoniser à chaque parse, pour que le chemin d'édition et NormalizeContentStreams produisent toujours la même orthographe. Nous pensons que c'est le mauvais défaut pour l'édition. Un appel ScalePage sur une couche contenant 0.123456 w réécrirait 0.1235 w, et chaque autre opérande de la couche serait réécrit aussi, alors que l'appelant n'a demandé qu'une mise à l'échelle. La forme canonique appartient aux opérations dont le but est une sortie comparable
Ces opérations l'obtiennent toujours. NormalizeContentStreams et l'optimiseur de contenu à la sauvegarde parsent avec CanonicalNumbers à True, parce que leur travail est une sortie stable à partir d'une entrée arbitraire ; si 0.50000 0 0 RG et 0.5 0 0 RG s'émettaient différemment, chaque comparaison en aval dériverait avec les habitudes de formatage du producteur. La canonisation descend récursivement dans les tableaux et dictionnaires, donc les motifs de tirets, les tableaux TJ et les dictionnaires de propriétés de contenu marqué sont couverts, tandis que les données brutes d'images inline sont laissées tranquilles. Les opérandes fournis via SetOperand sont canonisés quoi que dise le drapeau. Un programme de contenu porte son propre magasin de nombres fixé à quatre décimales, indépendant de SetPrecision, donc un opérande modifié ressort avec quatre. Seul Parse lit le drapeau, ce qui signifie qu'il doit être posé avant le parsing ; pour un programme que ParsePageContentLayer a déjà parsé, posez le drapeau et appelez Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Change une épaisseur de ligne ; chaque autre opérande garde son texte source
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // émis comme 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Copie canonique pour comparaison seulement, pas réécrite :
      // Parse est le seul lecteur du drapeau, donc re-parsez après l'avoir posé
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit écrit maintenant 0.50000 et 0.5 de la même façon
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Mises bout à bout, la règle pour les appelants est courte. Un simple LoadFromFile suivi de SaveToFile laisse les flux de contenu intacts et les nombres de dictionnaire intacts tels qu'ils étaient. Une page modifiée via le modèle de contenu garde le texte de chaque opérande que la modification n'a pas changé. NormalizeContentStreams, l'optimiseur qui tourne quand le contenu est compressé à la sauvegarde, et tout programme parsé avec CanonicalNumbers à True produisent des nombres canoniques par conception, et le reste du document est toujours préservé
Ce que cela coûte, et où la garantie s'arrête
Chaque TPDFNumeric porte une référence AnsiString de plus, et chaque décimal parsé garde son texte source vivant aussi longtemps que l'objet vit. Sur un document à plusieurs millions de nombres réels, c'est de la mémoire mesurable, et cela a sa place dans tout benchmark de gros documents que vous lancez. La garantie se limite aussi au document propre d'un nombre. Copier des objets entre documents, ou reconstruire des valeurs via l'API objet, produit de nouveaux nombres, et les nouveaux nombres suivent la précision de sortie
Nombres préservés et sortie identique à l'octet sont deux propriétés distinctes. Un chargement-sauvegarde d'un document intact garde les nombres de calibration que le renderer consomme, mais l'identité d'octets dépend aussi de la numérotation des objets, de la compression des flux et de l'identifiant du trailer couvert dans l'article sur l'ID PDF déterministe. Le diff d'empreintes continue de hacher le corps normalisé, ce qui veut dire que les différences d'arrondi dans les fichiers écrits par d'autres outils échappent à ce qu'il compare ; une comparaison de rendu reste le contrôle pour celles-là
La gestion numérique et la sémantique exacte de SetPrecision sont couvertes dans la référence de la losLab PDF Developer Library, avec les appels du modèle de contenu utilisés ci-dessus