PDF Library for Delphi peut fusionner des images à l'intérieur d'un PDF qui se ressemblent sans être identiques octet pour octet, via DeduplicateSimilarImages. La déduplication exacte ne fusionne que les images dont les dictionnaires et les charges utiles encodées correspondent ; celle-ci compare l'apparence réelle des images, en utilisant un hachage perceptuel plus deux seuils d'erreur de pixel, et redirige chaque référence vers un seul objet canonique
Les fichiers où cela paie sont ceux qui ont grossi par accident. Un lot scanné où chaque page porte le même logo réencodé par un scanner différent. Un rapport assemblé à partir de sources ayant chacune intégré le même graphique à une qualité JPEG légèrement différente. Un catalogue dont les miniatures ont été régénérées par deux outils. Dans chaque cas, le fichier contient de nombreuses copies d'une seule image, et la déduplication exacte ne peut en toucher aucune
Ce que « suffisamment similaire » doit signifier
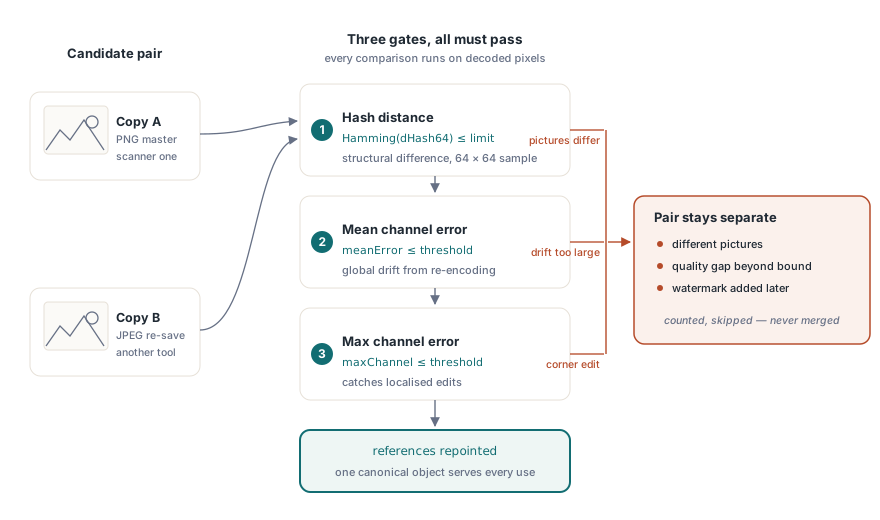
Trois seuils doivent tous être satisfaits avant que deux images soient fusionnées, et chacun attrape un type de différence distinct. La distance de hachage perceptuel borne la différence structurelle : un hachage de différence sur 64 bits est calculé à partir d'un échantillon 64 par 64 de l'image décodée, et la distance de Hamming autorisée va de 0 à 7. L'erreur moyenne par canal borne la dérive globale, ce que produit le réencodage. L'erreur maximale sur un seul canal borne la différence localisée, ce que produit une petite retouche
Exiger les trois est ce qui rend la fusion défendable. Une image qui diffère par un filigrane dans un coin a une erreur moyenne faible et une erreur maximale élevée, si bien que le seuil d'erreur maximale la rejette. Une image qui a été recompressée présente une petite erreur partout, si bien qu'elle passe. C'est exactement la distinction qu'un optimiseur de taille doit tracer
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Distance de hachage 2, erreur moyenne 2, erreur sur un canal 4.
    // Les options peuvent demander un mode simulation pour ne rien modifier
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
L'identité sémantique précède la similarité visuelle
Avant même que des pixels ne soient comparés, les images candidates doivent s'accorder sémantiquement. La bibliothèque construit une signature stable à partir du dictionnaire image complet, à l'exclusion de /Length, /Filter et /DecodeParms, si bien que dimensions, espace colorimétrique, profondeur de bits, masques, tableau /Decode, interpolation, appartenance à un contenu optionnel et métadonnées doivent tous correspondre
Cet ordre empêche toute une classe de fusions erronées. Deux images peuvent sembler identiques sur un échantillon 64 par 64 et se comporter différemment sur la page : l'une avec /Interpolate vrai et l'autre sans sera lissée différemment lors d'une mise à l'échelle, et une image appartenant à un groupe de contenu optionnel disparaîtra quand ce calque est masqué. Fusionner à travers ces frontières produit un document plus petit et faux
Seuls les Image XObjects indirects sont analysés. Les images en ligne relèvent d'une construction différente avec une économie différente, et les images qui ne peuvent pas être décodées sont ignorées de façon prudente et comptabilisées plutôt que fusionnées sur la foi — aucune preuve visuelle, aucune fusion
Comment la recherche reste bon marché
Comparer chaque image à toutes les autres est quadratique, ce qui est inacceptable sur un document contenant des milliers d'images. Le hachage est donc scindé en huit bandes de 8 bits avec un index ordonné sur chacune
Le principe des tiroirs fait le reste : si deux hachages diffèrent d'au plus 7 bits, ils doivent s'accorder exactement sur au moins une des huit bandes. Rechercher les candidats bande par bande trouve donc chaque correspondance permise sans balayage exhaustif par paires, et la limite publiée de 7 existe précisément parce que la garantie ne tient que jusqu'à cette distance
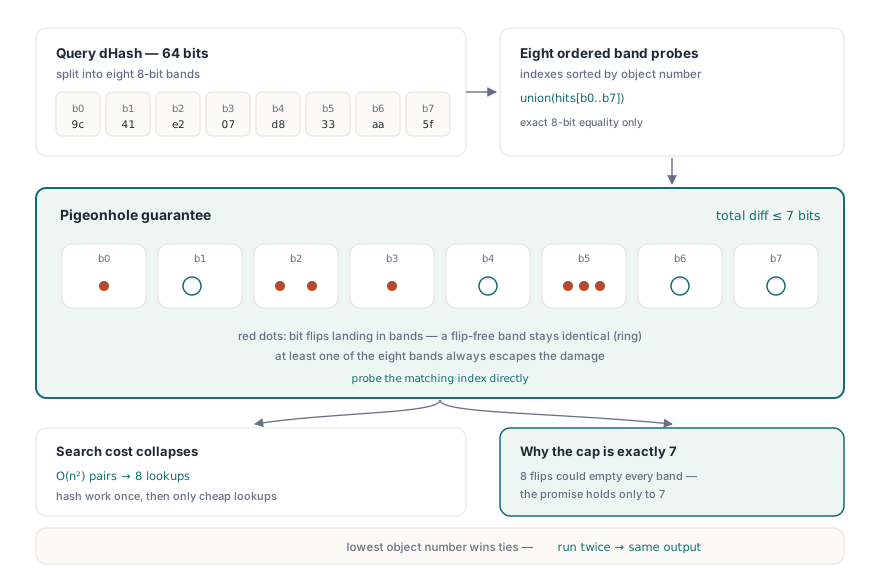
Les candidats et les correspondances de bande sont ordonnés de façon déterministe par numéro d'objet et de génération, et le plus petit numéro d'objet devient canonique. Cela rend la sortie reproductible : exécuter l'optimiseur deux fois sur la même entrée produit les mêmes choix canoniques, ce qui compte quand le résultat est comparé ou signé
Modes simulation et rapports honnêtes
Comme il s'agit d'une optimisation avec perte au sens où les images fusionnées n'étaient pas identiques, le flux de travail sensé consiste à regarder avant d'agir. L'option de simulation rapporte ce qui serait fusionné et combien de charge utile serait récupérée sans modifier le graphe d'objets, si bien qu'un traitement en lot peut journaliser l'effet et qu'un humain peut approuver les seuils une fois plutôt que par fichier
Deux remarques d'honnêteté dans le rapport méritent d'être mentionnées. Le chiffre récupérable n'estime que la charge utile encodée des flux dupliqués ; il ne compte pas les frais de dictionnaire, d'objet indirect et de table de références croisées, si bien que la réduction réelle de taille de fichier est légèrement supérieure à celle rapportée plutôt qu'inférieure. Et le rapport expose l'erreur maximale acceptée et la charge de travail de comparaison, si bien que vous pouvez voir à quel point les fusions se sont approchées de vos seuils
La grille d'échantillonnage fixe de 64 par 64 est une approximation intentionnelle, et elle a une conséquence qu'il vaut la peine d'énoncer clairement : une différence plus petite qu'une cellule d'échantillon peut passer inaperçue même à seuil zéro. Un seul mot changé sur une page scannée pourrait ne pas survivre à cet échantillonnage. Quand une preuve au niveau de l'octet est requise, utilisez plutôt la voie de déduplication exacte — elle ne fusionne que des ressources véritablement identiques et ne porte aucun jugement visuel du tout
Où cela s'inscrit dans un pipeline de réduction de taille
Ordonnez les passes par risque. Exécutez d'abord la déduplication exacte des ressources, car elle est sans perte et gratuite. Puis le sous-ensemblage de polices, également sans perte et généralement le plus grand gain isolé sur des documents riches en texte, comme traité dans l'optimisation de la taille de fichier PDF et le sous-ensemblage de polices. Puis la recompression ou le sous-échantillonnage d'images si le support cible le permet. La déduplication perceptuelle vient après ces étapes, car c'est la seule dont le résultat dépend d'un jugement
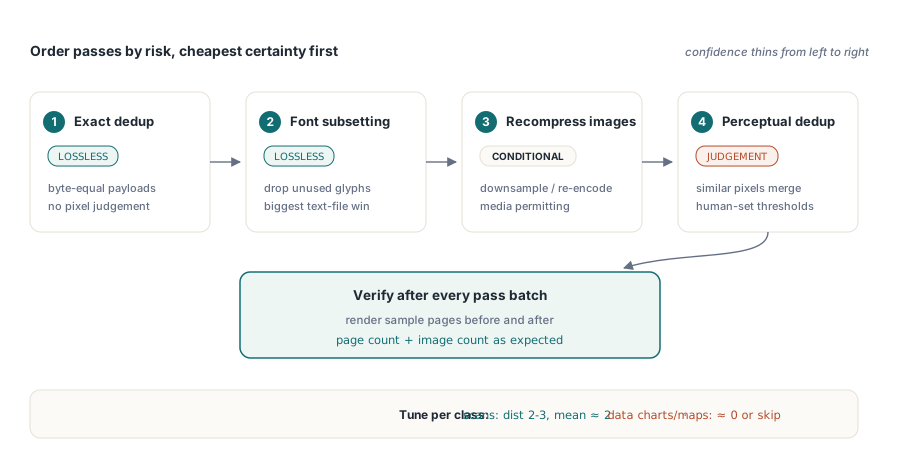
Choisissez les seuils par classe de document plutôt que globalement. Pour les lots scannés où chaque page porte le même en-tête, une distance de hachage de 2 à 3 avec une erreur moyenne autour de 2 fusionne l'en-tête de façon fiable. Pour les documents où les images portent des données — graphiques, cartes, imagerie médicale — utilisez des seuils nuls ou proches de zéro, ou sautez entièrement la passe, car deux graphiques qui diffèrent par un seul point tracé sont deux graphiques différents, quelle que soit leur ressemblance en 64 par 64
Après optimisation, vérifiez. Rendez un échantillon de pages avant et après et comparez-les, et vérifiez que le nombre de pages et le nombre d'images ont changé comme prévu. La voie d'inspection de ce qu'un document contient réellement est décrite dans l'audit de taille de fichier PDF par catégorie, ce qui est aussi le moyen le plus rapide de savoir si les images sont votre problème en premier lieu
La déduplication perceptuelle, la déduplication exacte des ressources et l'audit de taille s'exécutent sur le même graphe d'objets pour Delphi, C++Builder et Free Pascal ; la liste complète des fonctionnalités se trouve sur la page de PDF Library for Delphi