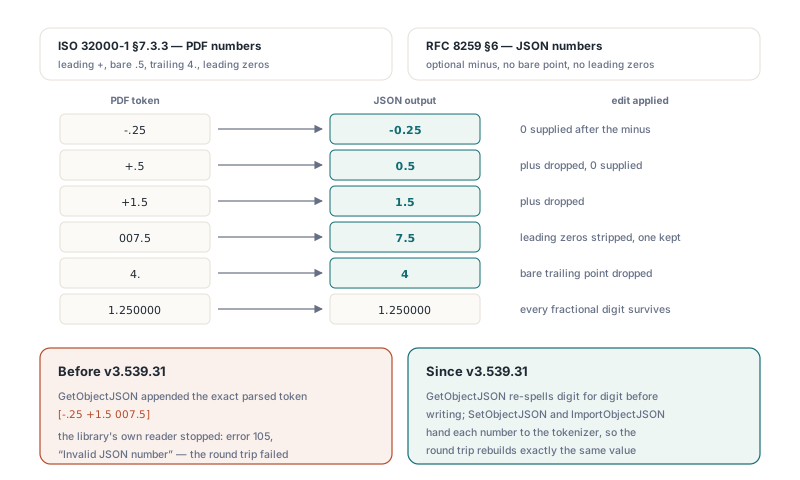
PDF Library for Delphi (PDFlibPas) emite JSON válido para cada número PDF desde v3.539.31. GetObjectJSON reescribe tokens que ISO 32000-1 acepta pero RFC 8259 rechaza, como -.25, +1.5 y 007.5, en -0.25, 1.5 y 7.5 dígito a dígito; GetDocumentJSON y los informes de análisis escriben null para NaN e Infinity; y PLDoubleToStr escribe 0 para NaN en lugar de elevar EInvalidOp a mitad de un export. Antes del fix, la library podía producir JSON que su propio reader se negaba a cargar
¿Por qué un número PDF válido rompe el JSON?
Porque las dos gramáticas discrepan en cuatro detalles menores, y un parser PDF que respeta el texto de origen arrastra esos detalles directos a la salida. ISO 32000-1 §7.3.3 permite que un número empiece con signo más, omita la parte entera (.5), acabe en un punto pelado (4.) y lleve ceros a la izquierda (007.5). RFC 8259 §6 no permite nada de eso: un menos opcional, una parte entera que es 0 o empieza con 1 a 9, y al menos un dígito tras cualquier punto decimal. Los productores pueden escribir las formas PDF, y montones de generadores y archivos editados a mano lo hacen
La fuga venía de una feature de precisión deliberada. Desde v3.539.19, TPDFNumeric.Output devuelve el texto exacto que el tokenizer parseó para los números reales, que es lo que mantiene exacto un valor de color calibrado al guardar, como se describe en conservar la precisión decimal parseada de PDF. El tokenizer ya parchea .5 en 0.5 y 4. en 4.0 en la entrada, y los enteros se reformatean desde su valor, así que +3 vuelve como 3. Lo que sobrevive verbatim es el resto: un punto con signo delante (-.25), un más explícito en un real (+1.5) y ceros a la izquierda (007.5). El antiguo writer de objetos pegaba Output justo después de "value":, y TJSONParser.ParseNumber del propio reader de la library se para en cada uno de esos con «Invalid JSON number», así que el export triunfaba y la reimportación fallaba con PDFLIB_ERROR_OBJECT_JSON_INVALID (105)
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  JSON: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('legacy-drawing.pdf', '') = 0 then
      raise Exception.Create('load failed');

    // El objeto 12 es un array escrito como [-.25 +1.5 007.5]
    JSON := Lib.GetObjectJSON(12, 0);
    // v3.539.31 y posteriores: los valores llegan como -0.25, 1.5 y 7.5

    // SetObjectJSON no acepta opciones, así que pase 0
    if Lib.SetObjectJSON(12, JSON, 0) = 0 then
      raise Exception.CreateFmt('round trip rejected, error %d',
        [Lib.LastErrorCode]);

    Lib.SaveToFile('legacy-drawing-roundtrip.pdf');
  finally
    Lib.Free;
  end;
end;
¿Cómo conserva PDFNumberTextToJSON cada dígito?
PDFNumberTextToJSON vuelve a deletrear el token en lugar de recomputarlo desde un Double. La función de PDFlibObjectJSON lee un signo opcional, recolecta dígitos antes y después de un único punto decimal, y aplica luego solo los retoques que JSON exige: suelta un más, recorta los ceros a la izquierda conservando uno, aporta 0 cuando la parte entera está vacía, suelta un punto final pelado y vuelve a poner el menos. Un token con cualquier otro carácter, o sin dígitos, recurre a PLJSONNumber(Value, 10), que escribe null cuando el valor no es finito
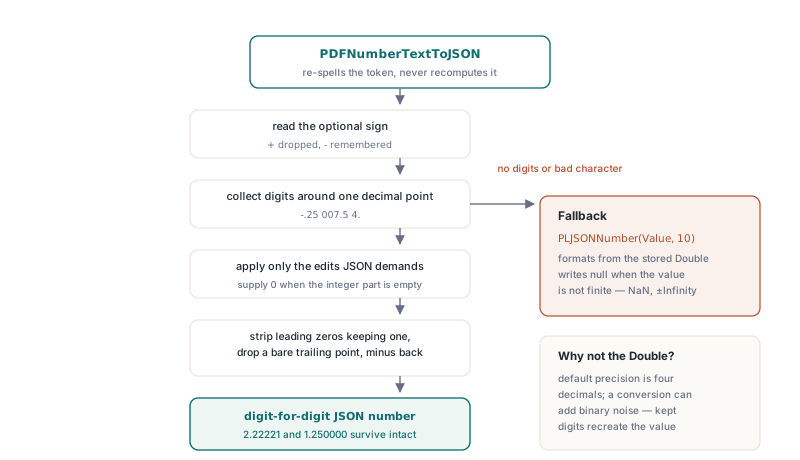
-.25se convierte en-0.25, y+.5en0.5+1.5se convierte en1.5007.5se convierte en7.5, mientras que0.75se queda como está4.se convierte en4si semejante token llega alguna vez al writer2.22221y1.250000conservan cada dígito fraccionario, ceros finales incluidos
Formatear desde el Double guardado habría sido más corto y equivocado, por la misma razón que existe el fix de precisión: la precisión de salida por defecto es de cuatro decimales, y hasta una conversión a plena precisión puede añadir ruido binario a un literal decimal. Conservar los dígitos significa que SetObjectJSON e ImportObjectJSON, que le entregan cada texto numérico JSON al tokenizer PDF, recrean exactamente el mismo valor. La garantía cubre el valor, no los bytes: tras una reimportación, -.25 se guarda como -0.25. Ambas deletreaduras son iguales bajo §7.3.3, pero un diff a nivel de bytes marcará el cambio, así que no trate un ciclo de export e import como un no-op en un documento cuyos bytes cubre una firma
¿Qué pasa con un número que JSON no puede representar?
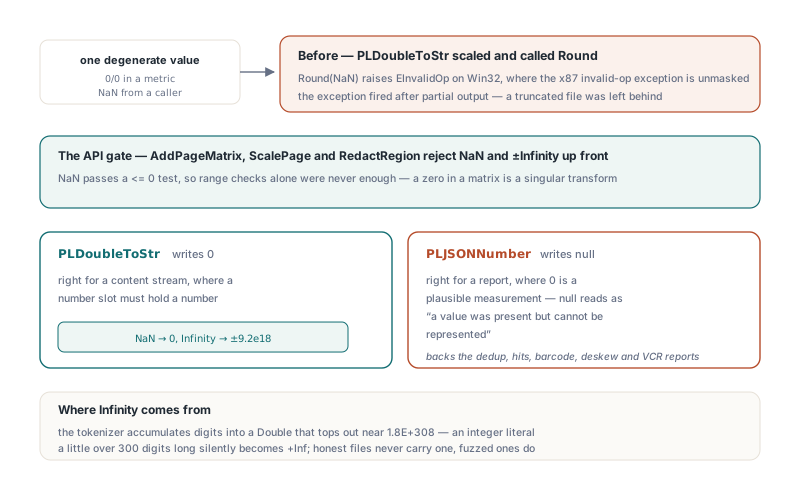
GetDocumentJSON escribe ahora null para cualquier número que sea NaN o infinito, porque RFC 8259 §6 no tiene sintaxis para ninguno de los dos. Infinity es más fácil de producir de lo que suena: el tokenizer PDF acumula dígitos por multiplicación repetida en un Double, que se agota cerca de 1.8 × 10308, así que un literal entero de algo más de 300 dígitos se convierte silenciosamente en +Inf. Los archivos honrados jamás contienen semejante literal; los fuzzed y hostiles sí, y por eso pertenecen al mismo corpus de test que los casos de endurecer un parser PDF en Pascal contra archivos maliciosos. El antiguo writer de documentos formateaba los no enteros con Str(D:0:6), y para +Inf eso escribe el texto +Inf, que ningún consumidor JSON va a parsear
El null es con pérdida a propósito. Quien consuma el output de GetDocumentJSON tiene que aceptar null en cualquier sitio donde puede aparecer un número, y leerlo como «había un valor pero no se puede representar», no como una clave ausente. El literal original no es recuperable desde el JSON del documento, así que un pipeline que se preocupe debería registrar el objeto y tratar el archivo como sospechoso en lugar de sustituir un valor por defecto
¿Por qué un solo NaN podía abortar un export SVG o JSON?
Porque PLDoubleToStr, el formateador numérico invariante detrás de los content streams, SVG, XML, CSV y la mayoría del JSON de la library, escalaba su entrada y llamaba a Round, y Round(NaN) eleva EInvalidOp en objetivos como Win32, donde Delphi deja la excepción de operación inválida del x87 sin enmascarar. La excepción saltaba después de que el writer ya hubiera emitido parte de su salida, así que una sola medida degenerada, un 0/0 en una métrica o un NaN metido por un llamador, dejaba un archivo truncado detrás. PLDoubleToStr devuelve ahora 0 para NaN, y su rama entera se acota a ±9.2e18 como la rama fraccionaria, así que Infinity también sale como un literal finito
Cero es la respuesta correcta para un content stream, donde un hueco numérico tiene que contener un número, y la equivocada para un informe, donde 0 es una medición plausible. Los writers de JSON que tienen que conservar la diferencia usan PLJSONNumber(Value, Decimals) de PDFlibExtra, que escribe null para NaN o Infinity y dígitos invariantes en los demás casos. PLJSONNumber sostiene ahora GetSimilarImageDeduplicationReportJSON, GetAnnotationHitsJSON y los informes de barcode, deskew, structured text y PDF/VCR; el informe de deskew escribía antes 0 para un ángulo no finito y ahora escribe null
uses
  SysUtils, PDFlibTypes, PDFlibExtra;

function SkewReportJSON(Page: Integer; Angle, Confidence: Double): string;
var
  B: PLStringBuilder;
begin
  B := PLStringBuilder.Create(128);
  try
    // Formatee cada Double a texto primero; PLJSONNumber escribe null
    // para NaN o Infinity y usa siempre punto decimal
    B.Append('{"page":').Append(Page)
     .Append(',"angle":').Append(string(PLJSONNumber(Angle, 4)))
     .Append(',"confidence":').Append(string(PLJSONNumber(Confidence, 4)))
     .Append('}');
    // Nunca B.Append(Angle): la sobrecarga Double sigue el locale del usuario
    Result := B.ToString;
  finally
    B.Free;
  end;
end;
¿Por dónde sigue colándose el locale del usuario en el JSON?
Por cualquier formateador que consulte las opciones regionales, y una auditoría completa del output legible por máquina encontró exactamente uno que quedaba: maxAcceptedMeanError en GetSimilarImageDeduplicationReportJSON, escrito con PLFloatToStr, un wrapper fino sobre FloatToStr. En un escritorio cuyo separador decimal es una coma, el informe contenía "maxAcceptedMeanError":1,5, que un parser JSON lee como el valor 1 seguido de un token suelto. El campo reporta el peor error de píxel aceptado de la deduplicación perceptual de imágenes, y pasa ahora por PLJSONNumber(Stats.MaxAcceptedMeanError, 6). Una trampa que queda es PLStringBuilder: en Delphi es un simple alias de System.SysUtils.TStringBuilder, cuya sobrecarga Append(Double) formatea por el locale del usuario, mientras que las builds FPC usan una clase de la library en su lugar, así que un test en Free Pascal o en una máquina en-US jamás la caza
uses
  System.SysUtils, System.JSON, PDFlibrary;

var
  Lib: TPDFlib;
  Report: WideString;
  Parsed: TJSONValue;
begin
  // Reproduce un escritorio alemán o francés dentro de la ejecución del test
  FormatSettings.DecimalSeparator := ',';
  Lib := TPDFlib.Create;
  try
    // Use un fixture que contenga de verdad imágenes casi duplicadas,
    // si no el error medio es 0 y el bug queda escondido
    Lib.LoadFromFile('scanned-batch.pdf', '');
    // Dry run con umbrales 2, 2, 4: el documento no se modifica
    Lib.GetSimilarImageDeduplicationReportJSON(2, 2, 4, Report);
    Parsed := TJSONObject.ParseJSONValue(Report);
    if Parsed = nil then
      raise Exception.Create('report is not valid JSON on a comma locale');
    Parsed.Free;
  finally
    Lib.Free;
  end;
end;
Una suite de regresión para output JSON necesita tres fixtures para mantenerse honesta: una página que lleve -.25, +1.5 y 007.5, un objeto que contenga un entero de 400 dígitos, y cualquier informe ejecutado bajo un locale con coma, cada uno validado con un parser estricto en lugar de a ojo. El object JSON, el document JSON y los informes de análisis de PDF Library for Delphi comparten las mismas reglas numéricas en Delphi, C++Builder y Free Pascal; la lista completa de features está en la página de producto de PDF Library for Delphi