PDF Library for Delphi puede fusionar imágenes dentro de un PDF que parecen iguales pero no son idénticas byte a byte, mediante DeduplicateSimilarImages. La deduplicación exacta solo fusiona imágenes cuyos diccionarios y cargas útiles codificadas coinciden; esta compara cómo se ven realmente las imágenes, usando un hash perceptual más dos umbrales de error de píxel, y redirige cada referencia hacia un único objeto canónico
Los archivos donde esto se nota son los que crecieron por accidente. Un lote escaneado donde cada página lleva el mismo logotipo recodificado por un escáner distinto. Un informe ensamblado a partir de fuentes que incrustaron cada una el mismo gráfico con una calidad JPEG ligeramente distinta. Un catálogo cuyas miniaturas fueron regeneradas por dos herramientas. En cada caso el archivo contiene muchas copias de una misma imagen, y la deduplicación exacta no puede tocar ninguna de ellas
Qué tiene que significar «suficientemente similares»
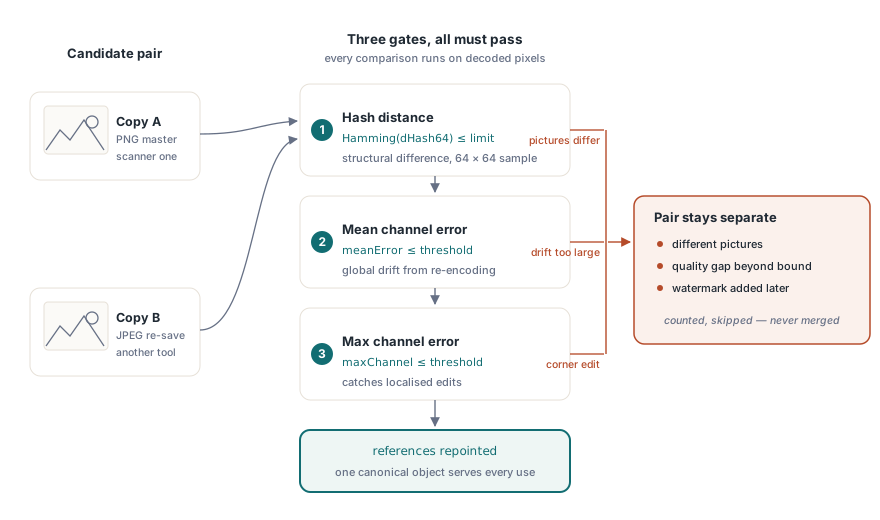
Tres umbrales deben cumplirse todos antes de fusionar dos imágenes, y cada uno detecta un tipo distinto de diferencia. La distancia de hash perceptual acota la diferencia estructural: se calcula un hash de diferencia de 64 bits a partir de una muestra de 64 por 64 de la imagen decodificada, y la distancia de Hamming permitida va de 0 a 7. El error medio por canal acota la deriva general, que es lo que produce la recodificación. El error máximo de un solo canal acota la diferencia localizada, que es lo que produce una pequeña edición
Exigir los tres es lo que hace defendible la fusión. Una imagen que difiere por una marca de agua en una esquina tiene un error medio bajo y un error máximo alto, así que la puerta del error máximo la rechaza. Una imagen que se ha recomprimido tiene un error pequeño en todas partes, así que pasa. Esa es exactamente la distinción que necesita trazar un optimizador de tamaño
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Distancia de hash 2, error medio 2, error de un solo canal 4.
    // Las opciones pueden solicitar una simulación para no modificar nada
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
La identidad semántica va antes que la similitud visual
Antes de comparar un solo píxel, las imágenes candidatas deben coincidir semánticamente. La biblioteca construye una firma estable a partir del diccionario de imagen completo, excluyendo /Length, /Filter y /DecodeParms, de modo que las dimensiones, el espacio de color, la profundidad de bits, las máscaras, el array /Decode, la interpolación, la pertenencia a contenido opcional y los metadatos deben coincidir todos
Este orden evita toda una clase de fusiones equivocadas. Dos imágenes pueden verse idénticas en una muestra de 64 por 64 y comportarse de forma distinta en la página: una con /Interpolate en true y otra sin él se suavizarán de forma distinta al escalarse, y una que pertenezca a un grupo de contenido opcional desaparecerá cuando esa capa se oculte. Fusionar a través de esas fronteras produce un documento más pequeño y equivocado
Solo se escanean los Image XObjects indirectos. Las imágenes en línea son una construcción distinta con una economía distinta, y las imágenes que no se pueden decodificar se omiten de forma conservadora y se contabilizan en lugar de fusionarse sobre la fe — sin evidencia de píxeles, no hay fusión
Cómo se mantiene barata la búsqueda
Comparar cada imagen contra todas las demás es cuadrático, lo cual es inaceptable en un documento con miles de imágenes. Por eso el hash se divide en ocho bandas de 8 bits con un índice ordenado sobre cada una
El principio del palomar hace el resto: si dos hashes difieren en como máximo 7 bits, deben coincidir exactamente en al menos una de las ocho bandas. Buscar candidatos banda por banda encuentra por tanto cada coincidencia permisible sin un escaneo exhaustivo por pares, y el límite publicado de 7 existe precisamente porque la garantía solo se cumple hasta esa distancia
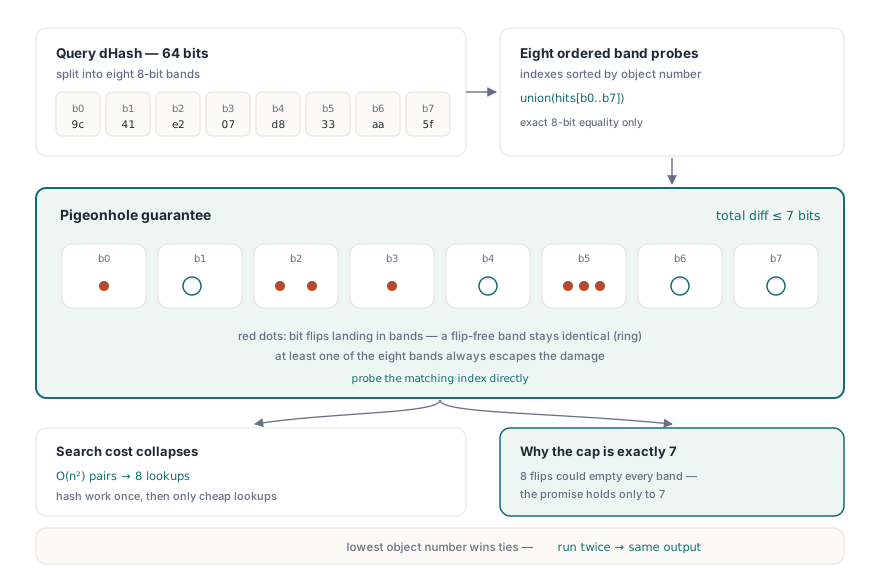
Los candidatos y los aciertos de banda se ordenan de forma determinista por número de objeto y generación, y el número de objeto más bajo se convierte en canónico. Eso hace la salida reproducible: ejecutar el optimizador dos veces sobre la misma entrada produce las mismas elecciones canónicas, lo cual importa cuando el resultado se compara o se firma
Simulaciones previas e informes honestos
Como esta es una optimización con pérdida en el sentido de que las imágenes fusionadas no eran idénticas, el flujo de trabajo sensato es mirar antes de saltar. La opción de simulación previa reporta qué se fusionaría y cuánta carga útil se recuperaría sin modificar el grafo de objetos, de modo que un trabajo por lotes pueda registrar el efecto y un humano pueda aprobar los umbrales una sola vez en lugar de por archivo
Dos notas de honestidad en el informe merecen mención. La cifra recuperable estima únicamente la carga útil codificada de los flujos duplicados; no cuenta la sobrecarga de diccionario, objeto indirecto y referencias cruzadas, así que la reducción real de tamaño de archivo es ligeramente mayor que la reportada, no menor. Y el informe expone el error máximo aceptado y la carga de trabajo de comparación, así que puedes ver qué tan cerca de tus umbrales estuvieron las fusiones
La cuadrícula fija de muestreo de 64 por 64 es una aproximación intencional, y tiene una consecuencia que vale la pena decir con claridad: una diferencia más pequeña que una celda de muestra puede pasar inadvertida incluso con un umbral en cero. Una sola palabra cambiada en una página escaneada podría no sobrevivir a ese muestreo. Cuando se requiere una prueba a nivel de byte, usa en su lugar la ruta de deduplicación exacta — solo fusiona recursos genuinamente idénticos y no hace ningún juicio visual en absoluto
Dónde encaja esto en un pipeline de reducción de tamaño
Ordena los pasos por riesgo. Ejecuta primero la deduplicación exacta de recursos, ya que es sin pérdida y gratuita. Luego el subconjuntado de fuentes, que también es sin pérdida y suele ser la ganancia individual más grande en documentos con mucho texto, como se trata en optimización del tamaño de archivo PDF y subconjuntado de fuentes. Luego la recompresión o el submuestreo de imágenes si el medio de destino lo permite. La deduplicación perceptual va después de esos pasos, porque es el único cuyo resultado depende de un juicio
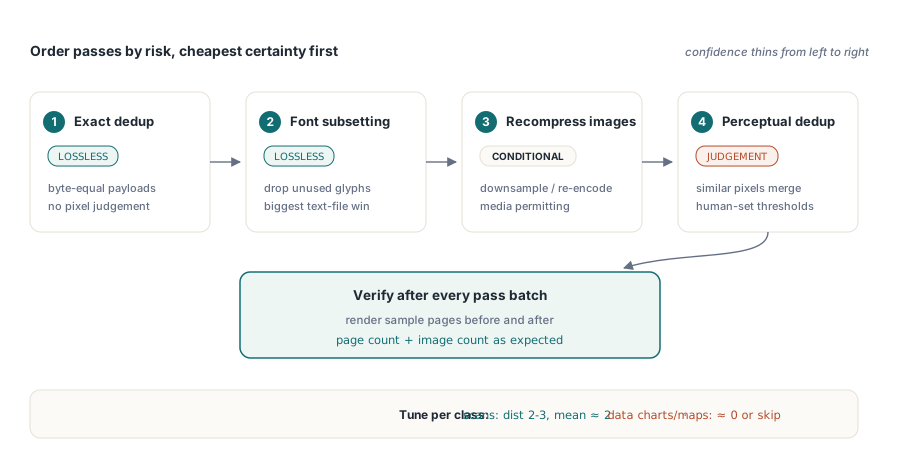
Elige los umbrales según la clase de documento, no de forma global. Para lotes escaneados donde cada página lleva el mismo membrete, una distancia de hash de 2 a 3 con un error medio alrededor de 2 fusiona el membrete de forma fiable. Para documentos donde las imágenes llevan datos — gráficos, mapas, imágenes médicas — usa umbrales en cero o cercanos a cero, o salta el paso por completo, porque dos gráficos que difieren en un punto trazado son dos gráficos distintos por muy parecidos que se vean a 64 por 64
Después de optimizar, verifica. Renderiza una muestra de páginas antes y después y compáralas, y comprueba que el número de páginas y de imágenes cambió como esperabas. La ruta de inspección de lo que realmente contiene un documento se describe en auditar el tamaño de archivo PDF por categoría, que es también la forma más rápida de averiguar si las imágenes son tu problema en primer lugar
La deduplicación perceptual, la deduplicación exacta de recursos y la auditoría de tamaño operan sobre el mismo grafo de objetos para Delphi, C++Builder y Free Pascal; la lista completa de funciones está en la página de PDF Library for Delphi