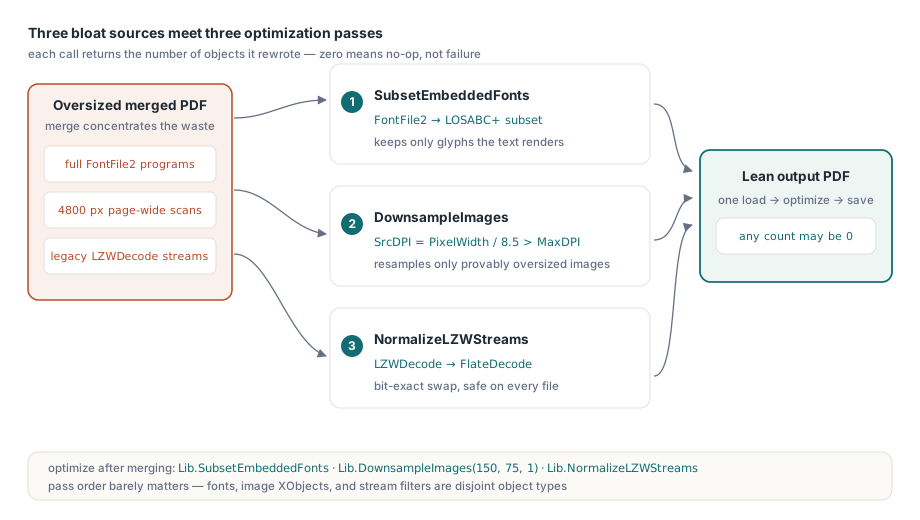
Para reducir el tamaño de archivo PDF en Delphi, losLab PDF Library proporciona tres API que atacan las tres mayores fuentes de hinchazón: SubsetEmbeddedFonts reescribe cada programa de fuente TrueType incrustado dejándolo en los glifos que el documento realmente renderiza, DownsampleImages remuestrea las imágenes ráster que superan un DPI objetivo, y NormalizeLZWStreams sustituye la compresión heredada LZWDecode por FlateDecode. Cada una devuelve el número de objetos que cambió, así que un cero indica que la pasada no hizo nada, y no un fallo silencioso
¿Por qué mi PDF fusionado es más grande que sus archivos de origen?
Un PDF fusionado o generado por programa suele estar sobredimensionado por una de tres razones: fuentes incrustadas completas, imágenes muestreadas muy por encima de su resolución de visualización, y streams todavía comprimidos con el filtro heredado LZW. ISO 32000-1 §9.9 permite a un productor incrustar el programa de fuente completo, y la mayoría de los productores hacen exactamente eso porque es la opción predeterminada segura. Un FontFile2 completo de Arial alcanza cientos de kilobytes; incrústalo en una docena de archivos de origen, fusiónalos, y estarás cargando con una docena de copias de contornos de glifos para caracteres que nadie tecleó. La fusión en sí no crea el desperdicio, solo lo concentra en un único archivo donde el total por fin se hace visible
Las imágenes son el segundo infractor. Un escaneo de 4800 píxeles de ancho colocado en un marco de un cuarto de página envía aproximadamente 40 veces más datos de píxeles de los que puede usar un pipeline de impresión a 300 DPI. El tercero es más discreto: streams filtrados con LZWDecode. ISO 32000-1 §7.4.4 especifica tanto LZWDecode como FlateDecode, y señala que Flate suele comprimir al menos igual de bien; en la práctica la salida de Flate es sistemáticamente más pequeña con los mismos datos, y LZW sobrevive sobre todo en archivos que pasaron en algún momento de su historia por herramientas de los años 90. El resto de este artículo recorre las tres pasadas de losLab PDF Library que corrigen cada problema y luego las combina en un solo pipeline
Subdivisión de fuentes con SubsetEmbeddedFonts
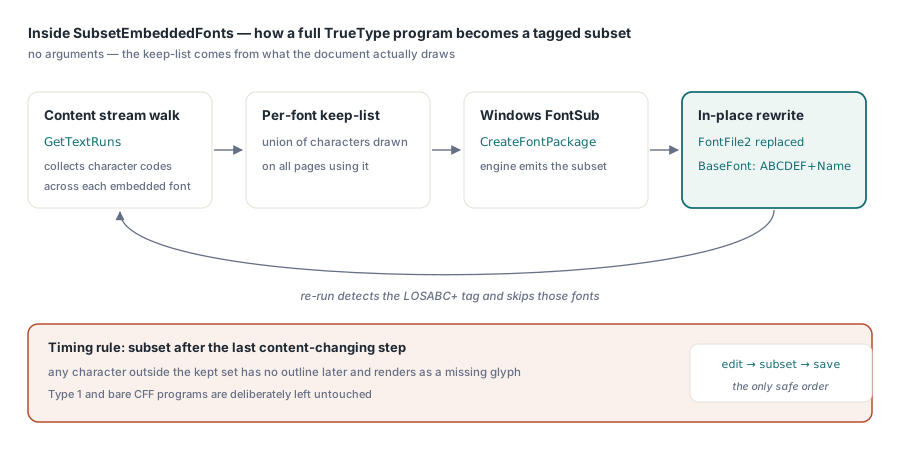
SubsetEmbeddedFonts reduce cada fuente TrueType incrustada de un documento cargado a los caracteres que el documento realmente usa, y no necesita argumentos porque deriva la lista de conservación de los propios flujos de contenido. Internamente la pasada recorre el flujo de contenido de cada página con GetTextRuns, recoge los códigos de carácter referenciados bajo cada recurso de fuente, construye una lista de conservación y entrega el programa de fuente original al motor FontSub de Windows (CreateFontPackage) para producir un subconjunto. El programa reescrito sustituye en el sitio al stream FontFile2, y el nombre BaseFont gana una etiqueta LOSABC+, la convención de seis letras mayúsculas más signo más que ISO 32000-1 §9.6.4 define para las fuentes subconjunto. Ese prefijo es también lo que hace idempotente la llamada: ejecuta la pasada dos veces y las fuentes ya subdivididas se reconocen y se omiten, así que integrarla en un trabajo por lotes que pueda volver a visitar archivos es seguro
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = número de programas FontFile2 reescritos;
      // 0 significa que no hay nada incrustado, o que todo ya está subdividido
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Dos detalles de implementación merecen conocerse porque explican los límites de la API. Primero, la pasada apunta a FontFile2, así que cubre los programas TrueType incrustados; las fuentes incrustadas como Type 1 o CFF puro se dejan intactas en lugar de arriesgarlas. Segundo, depende de FontSub, lo que hace que SubsetEmbeddedFonts sea solo para Windows. Un punto más sutil de la implementación: si una fuente cumple los requisitos se decide resolviendo realmente la cadena de referencias FontDescriptor → FontFile2, no confiando en una heurística de indicador de incrustación, porque las fuentes de un documento cargado nunca pasaron por la contabilidad del lado de creación que establece tales indicadores. Si el stream resuelto existe, la fuente es candidata; si no, se omite sin error
El compromiso honesto: una fuente subconjunto contiene solo los glifos presentes en el momento de la subdivisión. Si una herramienta posterior, o tu propio código, añade después texto con esa misma fuente, cualquier carácter fuera del subconjunto no tiene contorno y se renderizará como un glifo ausente. Subdivide como último paso que cambie el contenido, nunca antes de una etapa de edición. La misma precaución se aplica si piensas volver a extraer la fuente más tarde para reutilizarla; el artículo sobre extraer texto, imágenes y fuentes con PDF Library for Delphi cubre lo que un programa subconjunto extraído puede y no puede darte
¿Cómo decide DownsampleImages qué imágenes reducir?
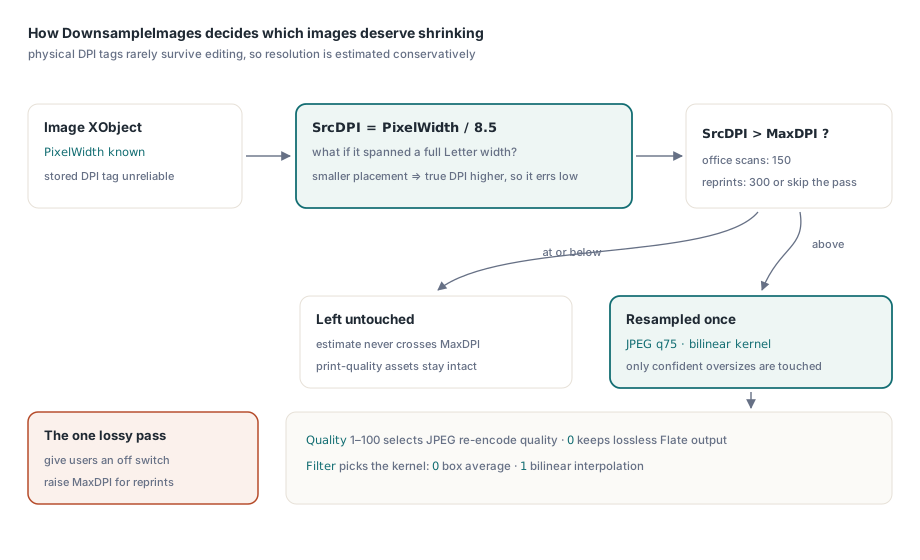
DownsampleImages(MaxDPI, Quality, Filter) remuestrea solo las imágenes que puede calificar con confianza de sobremuestreadas, usando una estimación de DPI deliberadamente conservadora. Un XObject de imagen PDF almacena dimensiones en píxeles pero ninguna resolución física fiable, y cualquier etiqueta de DPI de la imagen de origen rara vez sobrevive a un ciclo de cargar-editar-guardar. Así que la pasada estima SrcDPI = PixelWidth / 8.5, preguntando en efecto: si esta imagen abarcara todo el ancho de una página Letter, ¿cuál sería su resolución? Solo se tocan las imágenes cuya estimación supera MaxDPI. El sesgo es intencionado: una imagen colocada pequeña en la página tiene un DPI real mayor que la estimación, así que la pasada se activa de menos en lugar de degradar un recurso con calidad de impresión que no puede medir
Quality de 1 a 100 selecciona la calidad de recodificación JPEG, mientras que 0 mantiene la salida como Flate sin pérdida al estilo PNG; Filter elige el núcleo de remuestreo, 0 para un promedio de caja y 1 para bilineal. Para papeleo de oficina escaneado, DownsampleImages(150, 75, 1) es un punto de partida sensato; para cualquier cosa que pueda reimprimirse, sube MaxDPI a 300 u omite la pasada por completo. La reducción de resolución es el único paso con pérdida de los tres, así que debe quedar detrás de un ajuste que tus usuarios puedan desactivar
Convertir streams LZW heredados con NormalizeLZWStreams
NormalizeLZWStreams es la ganancia gratuita: descomprime sin pérdida cada stream LZWDecode y lo vuelve a comprimir con FlateDecode, en el sitio, devolviendo el recuento de streams convertidos. Maneja tanto una entrada única /Filter /LZWDecode como LZW apareciendo dentro de un array de cadena de filtros, donde solo se sustituye el eslabón LZW y se conserva el resto de la cadena. Los parámetros de predictor (Predictor, Columns, Colors, BitsPerComponent) se leen del DecodeParms del stream y se pasan al descompresor, así que los datos de imagen codificados con predictor hacen el viaje de ida y vuelta correctamente. Como ambos filtros son códecs exactos a nivel de bit, los bytes decodificados son idénticos antes y después; solo cambia la compresión del contenedor, y por eso esta pasada es segura de ejecutar incondicionalmente en todos los archivos
En un documento sin streams LZW la llamada simplemente devuelve 0 y no toca nada, algo que la suite de regresión de la biblioteca ejercita explícitamente: un archivo recién creado solo con Flate debe notificar cero conversiones. Esa garantía de no-operación importa cuando la pasada se sitúa en un pipeline que procesa miles de archivos heterogéneos, algunos de 2024 y otros de 1998
El pipeline completo de optimización de tamaño en Delphi
Las tres pasadas se combinan en una única función de cargar-optimizar-guardar, y el orden importa menos de lo que cabría esperar porque operan sobre tipos de objeto disjuntos: fuentes, XObjects de imagen y filtros de stream. Ejecutar primero la subdivisión sigue siendo la elección ordenada, ya que es la pasada con una restricción de orden de edición
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> subconjunto
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilineal
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Registrar Fonts/Images/Streams: tres ceros significan que el archivo ya era ligero
  finally
    Lib.Free;
  end;
end;
Verifica el pipeline como la biblioteca se verifica a sí misma: con un viaje de ida y vuelta. Las pruebas de regresión de la v3.130 crean un documento, lo guardan, lo recargan, ejecutan la optimización, lo guardan de nuevo y después afirman tres cosas: la salida es más pequeña, los recuentos devueltos coinciden con lo esperado, y una recarga del archivo optimizado sigue analizándose y renderizándose. Reproducir ese bucle de crear-optimizar-recargar contra una muestra de tus propios archivos de producción, y comparar el texto extraído antes y después, es una inversión de una hora que detecta errores de integración mucho antes de que un cliente abra una factura rota
// Comprobación de ida y vuelta: el archivo optimizado debe seguir cargándose limpiamente
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
¿Dónde encaja el pipeline en un flujo de trabajo de fusión? Después de la fusión, no durante ella. Fusionar primero y optimizar el resultado único significa que cada fuente incrustada se subdivide una sola vez contra la unión de todos los caracteres usados, en lugar de por archivo de origen. Si el rendimiento de la fusión es el cuello de botella, PDF Library for Delphi ofrece una vía rápida a nivel de bytes que evita el análisis completo de objetos, descrita en el artículo sobre fusión rápida de PDF con desplazamiento de referencias de bytes; y para entradas demasiado grandes para mantenerse completas en memoria, fusión y división con acceso directo para PDF grandes cubre la ruta en streaming. Ambas se emparejan de forma natural con una pasada final de optimización sobre la salida fusionada
Lo que las tres pasadas no harán
El trío de optimización de losLab PDF Library excluye deliberadamente cualquier cosa que cambie la semántica del documento. SubsetEmbeddedFonts no unifica las fuentes duplicadas de los distintos orígenes fusionados en un solo programa, reduce cada una de forma independiente; la deduplicación es una transformación distinta y más arriesgada. DownsampleImages pasará de largo ante una imagen cuya estimación conservadora de DPI se mantenga por debajo del umbral incluso cuando un humano vería que está sobredimensionada para su marco. Y ninguna de las pasadas toca la estructura del documento, así que un archivo hinchado por miles de objetos huérfanos necesita un guardado de tipo reescritura en lugar de estas pasadas a nivel de stream. Dentro de esos límites, la combinación de subdivisión de fuentes, reducción de resolución de imágenes y normalización de LZW a Flate elimina las tres fuentes clásicas de hinchazón de PDF con una llamada de API predecible cada una. Las tres funciones se incluyen como parte de losLab PDF Library para Delphi, C# y VB.NET, junto con las API de fusión, extracción y renderizado tratadas arriba