Combinar PDFs parece que debería ser barato. El contenido de las páginas ya está maquetado, las fuentes ya están incrustadas, las imágenes ya están comprimidas. En teoría, una fusión es solo trabajo administrativo: renumerar los objetos para que los espacios de numeración de dos archivos no choquen, unir los árboles de páginas, ajustar la tabla de referencias cruzadas y escribir el resultado. En la práctica, la mayoría del código de fusión tira por la borda esa ligereza. Para cada objeto de cada archivo de entrada hace un análisis completo en un árbol de objetos tokenizado, modifica un par de referencias indirectas y luego serializa el árbol de nuevo a bytes. El análisis y la serialización son las partes caras y, para la inmensa mayoría de los objetos, producen una secuencia de bytes casi idéntica a la que entró
PDF Library for Delphi es un motor nativo de PDF en Object Pascal para Delphi y C++Builder, y su ruta de fusión rápida existe para saltarse ese ciclo siempre que sea demostrablemente seguro. La idea es estrecha, pero compensa en conjuntos completos de documentos: para un objeto no de flujo sin modificar, toma los bytes originales del origen tal cual y aplica una única reescritura a nivel de byte de las referencias indirectas que contienen, convirtiendo cada N G R en (N+Offset) G R. Sin tokenizador, sin árbol de objetos, sin serializador. Este artículo recorre dónde es legal ese atajo, la máquina de estados del analizador que hace la reescritura de bytes sin corromper nada, por qué la fusión de marcadores necesita un mecanismo completamente distinto y cómo la ruta de fusión ordinaria comparte esa misma única pasada lineal
Por qué la renumeración de objetos es el coste real de una fusión
Cada PDF lleva su propio espacio de numeración de objetos. El archivo A tiene el objeto 1, el objeto 2, etc.; el archivo B tiene su propio objeto 1, objeto 2, etc. No puedes meter los objetos de B en el archivo de A sin cambios, porque los números chocarían y toda referencia indirecta dentro de B resolvería ahora hacia el objeto equivocado. La solución es un desplazamiento: si A termina en el recuento de objetos Offset, entonces el objeto N de B pasa a ser el objeto N+Offset en la salida, y toda referencia N G R que aparezca en cualquier parte de los objetos de B debe desplazarse a (N+Offset) G R para coincidir
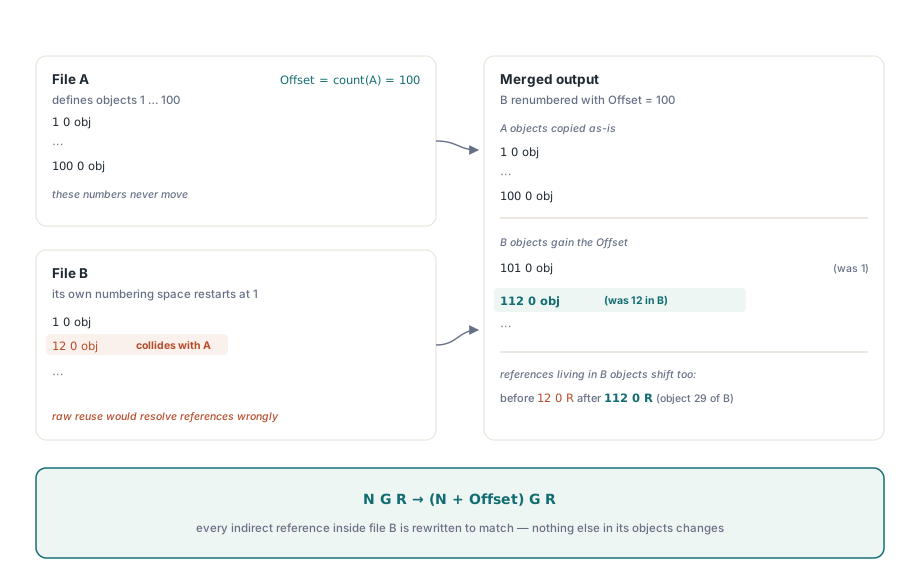
Ese desplazamiento es toda la tarea semántica de fusionar el cuerpo. Los ajustes del árbol de páginas y la fusión de AcroForm son ediciones pequeñas y acotadas sobre unos pocos objetos. El trabajo grueso es reescribir referencias en miles de objetos, y la forma ingenua de hacerlo es analizar cada objeto para poder encontrar las referencias de manera estructural. MergeFileListFast de PDF Library for Delphi adopta la postura contraria: las referencias también se pueden localizar en los bytes en bruto, si eres cuidadoso con los contextos en los que una secuencia dígito-espacio-dígito-espacio-R no es una referencia. Salta el análisis, desplaza in situ y el coste por objeto se reduce a un único recorrido lineal por bytes que de todos modos ibas a copiar
Cuándo reutilizar bytes de origen es demostrablemente seguro
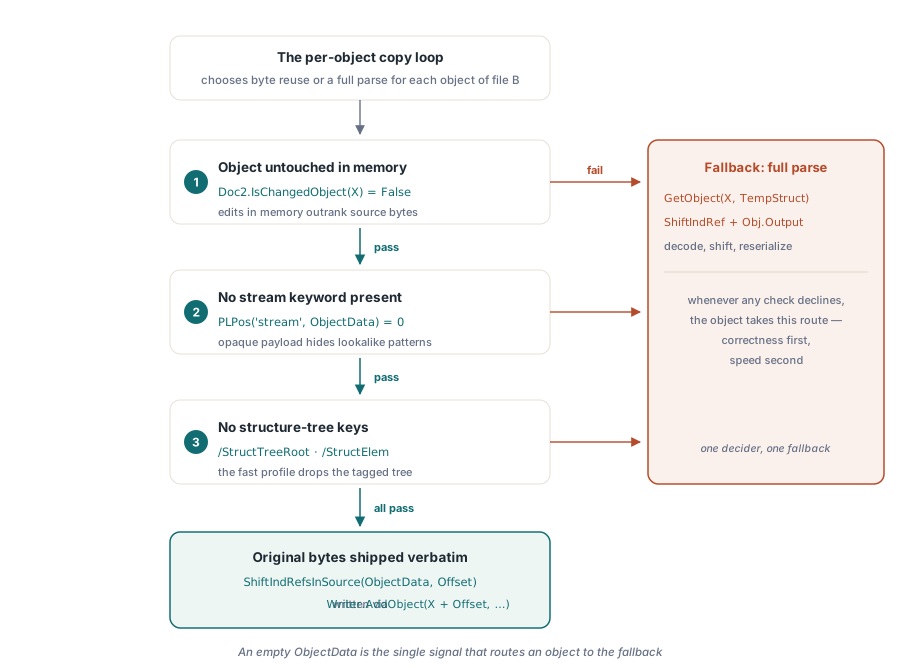
La ruta de bytes solo se toma cuando se cumplen las tres condiciones para el objeto que se copia de un documento posterior. Si falla una sola, el objeto vuelve a la ruta completa de decodificación y reserialización, así que la corrección siempre vence a la velocidad:
Doc2.IsChangedObject(X)es False. Si el motor de fusión ya modificó el objeto en memoria, por ejemplo un objeto de página cuyo/Parentse ha redirigido, el árbol en memoria es la fuente de verdad y los bytes originales ya están obsoletos. Solo califican los objetos intactos- Los bytes de origen no contienen la palabra clave
stream. El cuerpo de un objeto de flujo es binario opaco delimitado porstream/endstream, y un barrido ingenuo de referencias sobre datos comprimidos o cifrados buscaría y corrompería felizmente patrones de bytes que parecen referencias. Los objetos de flujo siguen la ruta original consciente de flujos - Los bytes de origen no contienen ni
/StructTreeRootni/StructElem. En el perfil rápido, el árbol de estructura de PDF etiquetado se descarta en lugar de fusionarse, así que esos objetos deben pasar por la ruta de decodificación donde el motor puede anularlos a propósito
La decisión vive en el bucle de copia por objeto. Cuando pasan las tres comprobaciones, los bytes del objeto van directos a ShiftIndRefsInSource y luego al escritor; si no, los bytes se descartan y el objeto se reconstruye con GetObject, se desplaza con ShiftIndRef y se serializa. La estructura de esa rama merece verse, porque el orden de las comprobaciones es lo que la mantiene segura:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // cae al camino de decodificar
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // ruta de parseo completa
  // ... anular los objetos del struct tree, ShiftIndRef, Obj.Output ...
end;
Una ObjectData vacía es la señal de que la ruta de bytes rechazó el objeto. Ese único centinela evita que las rutas rápida y lenta se separen: hay exactamente un punto que decide y exactamente una vía de reserva
La máquina de estados de desplazamiento de referencias y sus casos límite
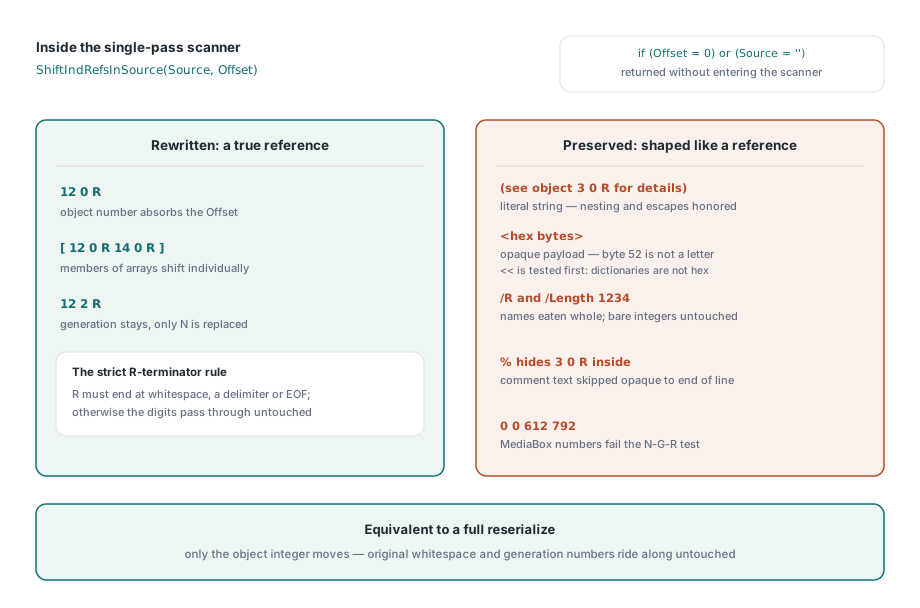
La reescritura en bytes de referencias indirectas es engañosamente fácil de hacer mal, porque R y las secuencias de dígitos aparecen por todo un objeto PDF en contextos que no son referencias. ShiftIndRefsInSource es un pequeño escáner escrito a mano que recorre los bytes una sola vez y solo reescribe un número cuando va seguido, con espacios en blanco PDF entre los tokens, por otro número y luego por un delimitador R. Las salidas rápidas van primero: si el desplazamiento es cero o el origen está vacío, los bytes se devuelven intactos sin entrar en el escáner
La corrección del escáner depende de reconocer los contextos en los que una secuencia con forma de referencia debe dejarse intacta. Estos son los límites más fáciles de pasar por alto, y cada uno se maneja explícitamente:
- Cadenas literales delimitadas por
(y)se copian tal cual, siguiendo la profundidad de anidamiento y respetando el escape con barra invertida para que un paréntesis escapado no desajuste el recuento de profundidad. Una cadena como(see object 3 0 R for details)contiene un patrón de referencia de manual que en realidad es solo prosa, y debe sobrevivir byte a byte - Cadenas hexadecimales delimitadas por
<y>se pasan sin interpretación. Los bytes52dentro de una cadena hexagonal son el código ASCII deR, y un escáner que tratara la carga hex como texto podría fabricar una referencia fantasma. El<<de apertura de un diccionario se detecta primero para que un diccionario no se confunda con una cadena hexadecimal - Objetos nombre que empiezan con
/se consumen completos, desde la barra hasta el siguiente espacio en blanco o delimitador. Sin esto, un nombre como/R(una clave de recurso habitual) podría leerse como laRde una referencia - Comentarios introducidos por
%llegan hasta el final de línea y se omiten como texto opaco - La prueba número-luego-R es estricta. Solo se reconoce una referencia como
Nespacio en blancoGespacio en blancoRcon laRterminada por espacio en blanco, un delimitador o el final de la entrada. Si falta el número de generación, o si unaRva seguida de una letra, los dígitos se emiten sin cambios. Esto es lo que protege el entero de/Length 1234y los cuatro números de unMediaBoxpara que no se incrementen en silencio
El núcleo de esa prueba estricta se parece casi exactamente a cómo lo describe la frase de especificación:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // número de objeto desplazado
  AppendBytes(E1, P - E1);                 // espacio en blanco y generación originales
  AppendBytes(P, 1);                       // la 'R'
end;
Solo se reescribe el número de objeto; el número de generación y el espacio en blanco exacto original entre los tokens se copian tal cual, así que la salida es byte idéntica a la entrada salvo por el único entero que había que cambiar. Esa precisión es todo el punto, y es lo que hace que reutilizar bytes de origen sea equivalente a reserializar por completo, no solo parecido. Si escribes un escáner así, pruébalo contra referencias aisladas, referencias dentro de arrays, números que no son referencias, cadenas literales, cadenas hexadecimales y números de generación distintos de cero con un desplazamiento aplicado
Por qué los marcadores no podían reutilizar AppendOutline
Fusionar los marcadores de varios documentos en un único árbol de esquema parece un trabajo para el ayudante existente AppendOutline, que ya sabe cómo injertar los marcadores de nivel superior de un documento en otro. Aquí es la herramienta equivocada, y la razón es un desajuste sutil de capas. AppendOutline localiza el último marcador de nivel superior actual recorriendo el lector sobre los bytes originales del archivo. Pero la vía rápida prepara sus ediciones en un búfer de nuevos objetos mediante ChangeObject; el lector nunca ve esas ediciones. Encadena tres o más documentos y cada anexado vuelve a redirigir el último marcador original del primer documento al documento más nuevo, así que todos los marcadores de los documentos intermedios se caen de la cadena; solo el /Count acumulado sigue siendo correcto, lo que hace que el error sea fácil de pasar por alto hasta que alguien abre el panel de marcadores
La ruta rápida lo resuelve con una inyección en dos fases, guiada por metadatos, que nunca vuelve a recorrer el lector. Un primer pase sobre todas las entradas recopila, por documento, el objeto raíz del esquema y los números de generación, los números del primer y del último marcador de nivel superior, y el /Count de la raíz. A partir de ese resumen, el código calcula los números globales de objeto de cada enlace que necesita forjar, el /Parent de nivel superior de cada documento hacia la raíz compartida, el /Prev del primer marcador hacia el último del documento anterior, el /Next del último marcador hacia el primero del documento siguiente, usando pura aritmética de números de objeto. Hay una restricción de orden de escritura detrás de esto: los objetos del primer documento se escriben antes de abrir siquiera el siguiente, así que todas las ediciones del esquema del primer documento, el /Count y el /Last de la raíz, y el /Next del antiguo último marcador, tienen que poder expresarse como aritmética que no necesita tener a mano un documento posterior. Las ediciones de cada documento siguiente se aplican en su sitio después de abrirlo pero antes de escribirlo, así que salen por la misma ruta de cambio de objeto
La invariante de alineación del desplazamiento que lo une todo
Tanto el desplazamiento de referencias como la inyección de marcadores dependen de una única invariante aritmética, y es la suposición más frágil de todo el diseño. Una referencia inyectada en un documento posterior se escribe como número global de objeto de destino menos el Offset de ese documento, de modo que cuando el objeto se desplaza más tarde con ShiftIndRef(Offset) el valor acaba en el número global previsto. El primer documento recibe Offset = 0 y usa directamente los números globales. Para que esa resta sea correcta, la secuencia de offsets en curso usada durante la inyección tiene que coincidir con la secuencia de offsets usada cuando los objetos se escriben al final
Y coincide, por una propiedad de cómo funcionan las fusiones de páginas y formularios: AddPages, AddFields y AddFieldFonts solo modifican los objetos existentes del primer documento; nunca añaden nuevos. Así que el recuento de objetos del primer documento no cambia durante la fase de fusión de páginas, y el offset de cada documento posterior, la suma de todos los documentos anteriores, permanece estable desde la inyección hasta la escritura final. Si rompes eso, si introduces una fase que crea un objeto nuevo a mitad de la fusión, entonces todas las referencias de páginas y marcadores aguas abajo quedarían desfasadas por el número de objetos que añadiste. La invariante es silenciosa, pero es estructural
Tres puntos de entrada sobre un solo motor
La ruta rápida no es una bifurcación del código de fusión. El motor a nivel de byte es una única rutina interna, MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode), y las APIs públicas son envoltorios delgados que eligen dos banderas:
MergeFileListFastllama al motor con la preservación del árbol de estructura desactivada, la ruta más ligera, que descarta el árbol de PDF etiquetado para que la vía de bytes se aplique al mayor número de objetosMergeFileListlo llama con la preservación activada, de modo que el árbol de estructura sobreviva y el resultado siga siendo un PDF etiquetado utilizable. Esta ruta ordinaria también hereda la fusión de marcadores y formularios para varios documentosMergeFileListStrictactiva el modo estricto: el primer pase de metadatos se detiene en la primera entrada que no informa de una fusión limpia, así que solo se incluyen los documentos recopilados antes del archivo defectuoso, en lugar de saltarse el archivo malo y seguir
Como los tres comparten un mismo motor, la fusión ordinaria también corre como una única pasada lineal que abre cada entrada una sola vez, en lugar de un bucle por pares O(N²) que fusiona el archivo uno y dos, fusiona ese resultado con el tres y así sucesivamente, reanalizando el acumulador creciente en cada paso. Los dos puntos de entrada para dos archivos y dos flujos, MergeFiles y MergeStreams, siguen disponibles para quienes realmente quieren una fusión por pares
Una nota sobre el comportamiento del árbol de estructura, porque importa si verificas la salida inspeccionando bytes. La ruta rápida descarta el árbol eliminando la referencia del catálogo del primer documento a /StructTreeRoot; el propio objeto del árbol de estructura sigue escribiéndose, sin referencias. Así que los bytes de la salida rápida todavía contienen la cadena /StructTreeRoot, y buscar esa cadena no distingue la salida rápida de la ordinaria; la diferencia real es si el catálogo sigue alcanzando el árbol de estructura, que es lo que determina si el archivo sigue siendo un PDF etiquetado navegable
Cuándo conviene usar cada ruta
La ruta de bytes es una optimización de rendimiento para ensamblar muchos documentos cuando no necesitas conservar el árbol de estructura del PDF etiquetado, como paquetes de informes, tandas de extractos o concatenación por lotes. Medido sobre fusiones repetidas de conjuntos de entrada medianos o grandes, la reutilización de bytes recorta aproximadamente entre un cuatro y un trece por ciento del tiempo real, según la mezcla de objetos, y las entradas pequeñas o mal formadas se comportan exactamente igual que en la ruta completa, porque cualquier objeto que el escáner no pueda demostrar seguro vuelve al análisis completo. Si necesitas el árbol de estructura intacto por accesibilidad, usa la ruta ordinaria de fusión de PDF etiquetado, que lo conserva; y si trabajas con archivos individuales muy grandes en lugar de muchas entradas, las técnicas de copia de bytes descritas en el artículo complementario sobre fusión y división de PDF grandes con acceso directo al archivo aplican la misma filosofía de "copiar bytes, evitar el árbol de objetos completo" a escala de archivo
Las rutinas de fusión y sus variantes rápida y estricta forman parte de la PDF Library for Delphi Delphi PDF Library, cuya documentación incluye la referencia completa de la API de listas de archivos y de las opciones de fusión descritas aquí