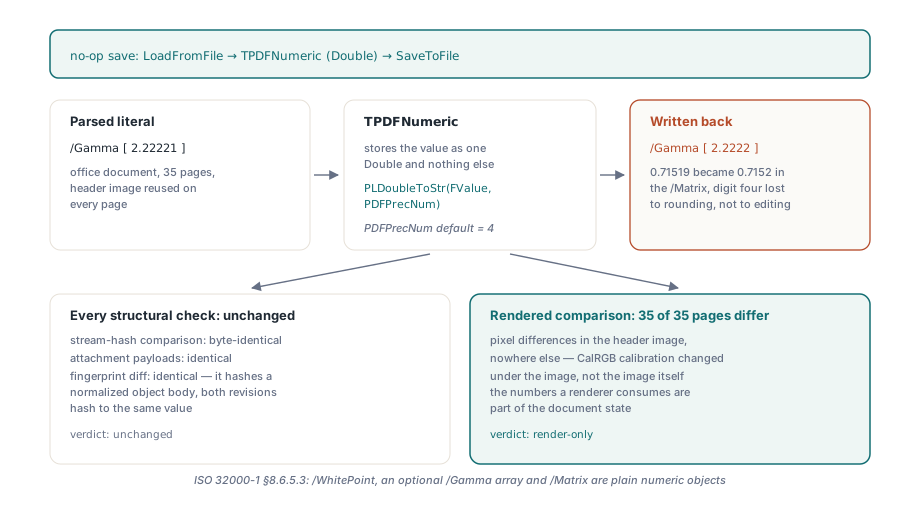
Carga un PDF calibrado, no cambies nada, guárdalo con otro nombre y compara el diccionario del espacio de color: entró /Gamma [2.22221 2.22221 2.22221] y salió /Gamma [2.2222 2.2222 2.2222]. El writer reformateó un número que nunca tuvo que tocar, y la página ahora se renderiza con colores ligeramente distintos. La cura es tratar cada decimal parseado como dos cosas a la vez, un valor para la aritmética y un literal para la salida, y seguir emitiendo el literal hasta que alguien asigne de verdad un valor nuevo
Por qué un guardado no-op puede mover colores CalRGB
Los píxeles se mueven porque al renderer le llegan datos de calibración ligeramente distintos mientras los bytes de la imagen siguen idénticos. ISO 32000-1 §8.6.5.3 define un espacio de color CalRGB mediante un /WhitePoint obligatorio, un array /Gamma opcional de tres elementos y un /Matrix opcional de nueve, y todos son objetos numéricos corrientes en el diccionario del espacio de color. Pásalos por un Double y un formateador clavado en cuatro decimales, y 2.22221 se convierte en 2.2222 mientras una entrada de matriz 0.71519 se convierte en 0.7152. Un valor de gamma es un exponente aplicado a cada componente de cada píxel que pasa por ese espacio, así que el cambio se nota dondequiera que se use
Para un fichero que declara un espacio CalRGB para una imagen de cabecera reutilizada en 35 páginas, las 35 cabeceras se renderizan con colores desplazados y nada más cambia en esas páginas. Las comprobaciones a las que la gente recurre primero salen limpias. Un hash de los bytes decodificados del stream compara datos de imagen, y los datos de imagen de verdad son idénticos; el daño está en un diccionario. La comparación de revisiones descrita en el artículo del nivel de modificación toma la huella de un cuerpo de objeto normalizado, así que las dos revisiones también dan el mismo hash ahí. La comparación de páginas renderizadas es lo que lo caza. Para cualquier pipeline que reescriba PDFs producidos por otro software, pondríamos una comparación de render por página por delante de cualquier comprobación estructural
Qué aspecto puede tener un número real de PDF
ISO 32000-1 §7.3.3 define un número real como una cadena decimal: signo opcional, dígitos, un punto, más dígitos. Sin notación de radix. Sin forma exponencial. El Anexo C, que enumera los límites de implementación, espera que se respeten unos cinco dígitos decimales significativos en la parte fraccionaria. Una precisión de salida por defecto de cuatro ya se queda un dígito por debajo de lo que la especificación pide conservar a los lectores, y el fichero no hizo nada malo al usar cinco
Cerca de cero, un formateador ingenuo hace algo peor que perder un dígito. La forma habitual de imprimir un Double a N posiciones es multiplicar por 10^N, redondear a entero y escribir los dígitos, y cuando ese entero es cero la salida es 0. Dale el primer operando de 0.00001 0 0 1 0 0 cm a cuatro posiciones y el resultado es 0 0 0 1 0 0 cm, una matriz singular que hace desaparecer todo lo dibujado bajo ella. Una entrada /Matrix de -0.000012345 corre la misma suerte
Cuando PDF Library for Delphi (PDFlibPas) tiene que formatear él mismo un Double, conserva el número de dígitos significativos pedido para un valor distinto de cero menor que el paso de precisión en lugar de escribir 0. A cuatro posiciones, 0.00001 se escribe como 0.00001 y 0.0000123 como 0.0000123; solo las magnitudes por debajo de 5E-16 aproximadamente salen todavía como 0. Así los números recién escritos se mantienen sanos. Un número parseado que nunca necesitó reformatearse es otra historia, y la biblioteca lo gestiona no reformateándolo en absoluto
Cómo PDFlibPas conserva el literal que parseó
TPDFStructure.Decode guarda el texto fuente de cada real estándar que tokeniza, es decir, un token con punto decimal y sin marcador de exponente, justo al lado del Double convertido. TPDFNumeric.Output reescribe ese texto siempre que está presente y formatea el Double al PDFPrecNum de la estructura solo cuando no lo está. TPDFNumeric.SetTo descarta el texto, porque un número editado es un número nuevo y debe seguir la precisión de salida actual
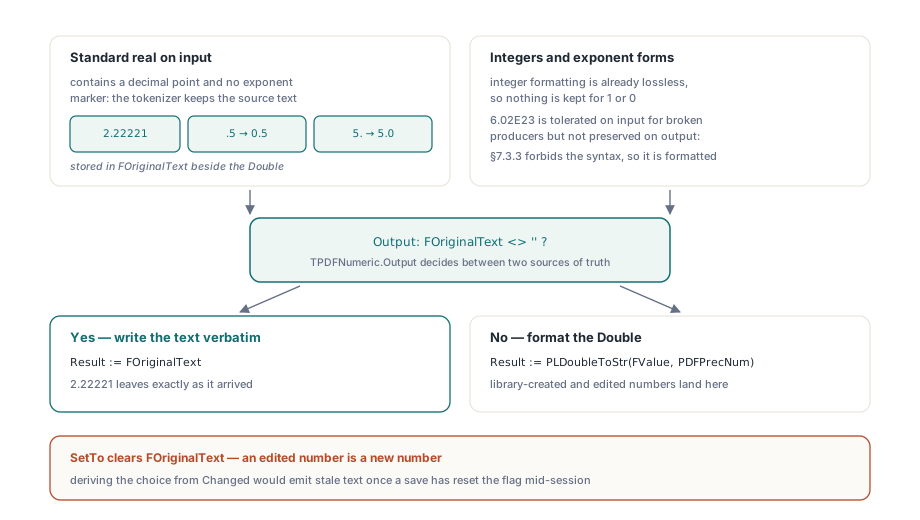
Atar el reinicio a SetTo fue deliberado. El atajo tentador es emitir el texto original salvo que el flag Changed del objeto esté activo, ya que ese flag existe de antemano en todos los objetos. Pero el pipeline de guardado limpia Changed en cuanto un objeto se ha escrito, así que un valor editado, guardado y editado otra vez en la misma sesión volvería a emitir su literal obsoleto en el segundo guardado. Limpiar el texto dentro de la propia asignación implica que el literal y el valor nunca pueden discrepar
Algunos límites son intencionados. Los enteros no se guardan como texto porque el formateo de enteros ya es sin pérdida. Las formas exponenciales como 6.02E23 se aceptan en entrada por cortesía a los productores que las escriben de todos modos, pero se formatean en salida como cualquier número generado por la biblioteca, porque copiarlas de vuelta perpetuaría una sintaxis que §7.3.3 descarta. El tokenizador además aplica su pequeña reparación de siempre antes de guardar el texto: un literal con punto inicial como .5 se guarda como 0.5, y uno con punto final como 5. como 5.0. Todos los lectores tratan cada pareja como el mismo número, y la grafía reparada se acepta en muchos más sitios
El fragmento de abajo pasa los valores CalRGB por la capa de objetos directamente, así que cada regla se puede ver sin abrir un fichero PDF. Las líneas Assert son comprobaciones que sugerimos añadir en tus propios tests; no son llamadas a la biblioteca
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Comprobación propia: la entrada sin editar sobrevive literal, incluido el
    // valor que un formateador ingenuo de cuatro posiciones colapsaría a 0
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Una edición descarta el texto original y sigue el PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // Los valores nuevos diminutos conservan dígitos significativos en vez de volverse 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // Bajar la precisión después no alcanza a la entrada sin editar
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Una trampa al escribir aserciones como estas: el Round de Delphi usa redondeo bancario, y 0.000012345 * 1e8 evalúa a 1234.4999… en binario en lugar de 1234.5. Nosotros dimos de lleno con ese valor al comprobar el camino de formateo cercano a cero. Elige entradas de test que no sean puntos medios binarios siempre que una aserción dependa de cómo redondea el último dígito
¿Qué controla SetPrecision?
TPDFlib.SetPrecision fija los decimales de los números que escribe la biblioteca: los gráficos dibujados a través del painter, los números creados desde un Double como por ejemplo con NewNumeric, y los valores parseados que hayan cambiado después con SetTo. Acepta de 2 a 8 y devuelve 0 para cualquier cosa fuera de ese rango. Un decimal parseado que nadie editó conserva su texto de entrada sea cual sea el ajuste, y cambiar el ajuste después de LoadFromFile no retroactúa sobre él. La fuente pasada a SetObjectFromString pasa por el mismo tokenizador y se conserva de la misma manera
Nuestra recomendación es dejar SetPrecision tranquilo salvo que la geometría que generes necesite pasos más finos. Subirlo para proteger ficheros de entrada no compra nada, porque la entrada intacta ya conserva sus propios dígitos, y alarga cada número que dibujes. Cinco posiciones es una elección razonable para trabajo de dibujo por debajo del punto; ocho casi siempre solo infla los content streams
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Rige los números escritos a partir de aquí; los arrays /Gamma,
    // /Matrix y /WhitePoint parseados conservan su texto original
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // los números dibujados usan cinco posiciones
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Content streams: las ediciones conservan operandos, la normalización es opt-in
El modelo de contenido editable conserva el texto de los operandos por defecto y canoniza números solo cuando la salida canónica es el propósito de la llamada. TPDFContentProgram.CanonicalNumbers vale False por defecto, así que una capa devuelta por ParsePageContentLayer, el mismo modelo sobre el que se construye el rastreador de estados gráficos, reemite cada operando numérico intacto exactamente como estaba escrito. Las ediciones de página que reescriben una capa entera, incluidas ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths y tu propio programa escrito de vuelta con WritePageContentLayer, cambian solo los operandos que la edición tocó
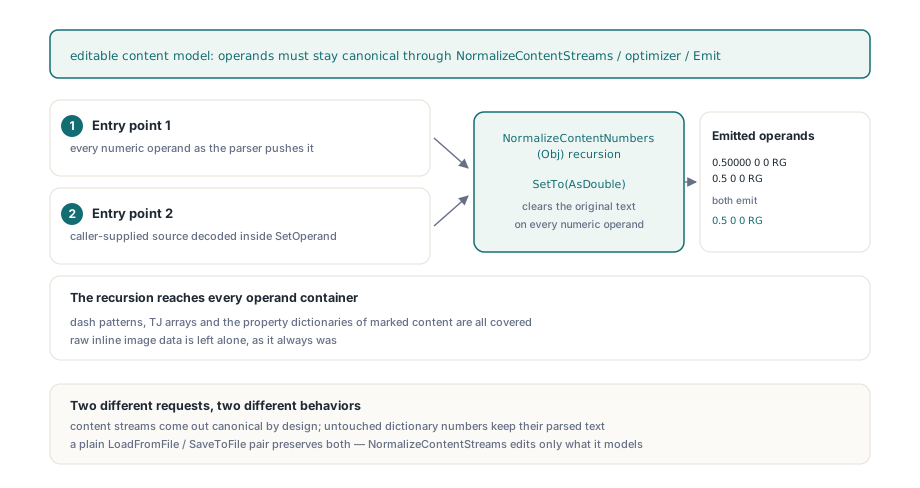
El otro valor por defecto parece más ordenado: canonizar en cada parse, de modo que el camino de edición y NormalizeContentStreams produzcan siempre la misma grafía. Nos parece el defecto equivocado para edición. Una llamada ScalePage sobre una capa que contiene 0.123456 w escribiría 0.1235 w, y todos los demás operandos de la capa se reescribirían también, aunque quien llama solo pidió escalar. La forma canónica pertenece a las operaciones cuyo propósito es una salida comparable
Esas operaciones siguen teniéndola. NormalizeContentStreams y el optimizador de contenido del guardado parsean con CanonicalNumbers a True, porque su trabajo es una salida estable a partir de entrada arbitraria; si 0.50000 0 0 RG y 0.5 0 0 RG se emitieran distinto, cada comparación aguas abajo derivaría con los hábitos de formateo del productor. Canonizar recorre recursivamente arrays y diccionarios, así que patrones de guiones, arrays TJ y diccionarios de propiedades de marked-content quedan cubiertos, mientras que los datos de imagen en línea en bruto se dejan tranquilos. Los operandos suministrados vía SetOperand se canonizan diga lo que diga el flag. Un programa de contenido lleva su propio almacén de números clavado a cuatro decimales, independiente de SetPrecision, así que un operando editado sale con cuatro. Solo Parse lee el flag, lo que significa que hay que fijarlo antes de parsear; para un programa que ParsePageContentLayer ya parseó, fija el flag y llama a Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Cambia un ancho de línea; todos los demás operandos conservan su texto fuente
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // se emite como 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Copia canónica solo para comparar, no se escribe de vuelta:
      // Parse es el único lector del flag, así que vuelve a parsear tras fijarlo
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit ahora escribe 0.50000 y 0.5 de la misma forma
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
En conjunto, la regla para quien llama es corta. Un LoadFromFile seguido de SaveToFile deja los content streams intactos y los números de diccionario intactos tal como estaban. Una página editada a través del modelo de contenido conserva el texto de cada operando que la edición no cambió. NormalizeContentStreams, el optimizador que corre cuando el contenido se comprime al guardar, y cualquier programa parseado con CanonicalNumbers a True producen números canónicos por diseño, y el resto del documento sigue preservado
Qué cuesta y dónde se acaba la garantía
Cada TPDFNumeric lleva una referencia AnsiString extra, y cada decimal parseado mantiene vivo su texto fuente mientras viva el objeto. En un documento con millones de números reales eso es memoria medible, y pertenece a cualquier benchmark de documentos grandes que corras. La garantía también está acotada al documento propio del número. Copiar objetos entre documentos, o reconstruir valores por la API de objetos, produce números nuevos, y los números nuevos siguen la precisión de salida
Los números preservados y la salida byte a byte idéntica son propiedades separadas. Un load-and-save de un documento intacto conserva los números de calibración que consume el renderer, pero la identidad byte a byte depende además de la numeración de objetos, la compresión de streams y el identificador de trailer tratado en el artículo del ID determinista de PDF. La comparación por huella sigue hasheando el cuerpo normalizado, lo que significa que las diferencias de redondeo en ficheros escritos por otras herramientas quedan fuera de lo que compara; para esas sigue valiendo la comparación de render
El manejo numérico y la semántica exacta de SetPrecision están cubiertos en la referencia de la losLab PDF Developer Library, junto con las llamadas del modelo de contenido usadas arriba