Cambia una máquina de pruebas de Windows a ajustes regionales alemanes, ejecuta una rutina que antepone una matriz de escala y desplazamiento a una página, y vuelca el content stream. En lugar de 0.5 0 0 0.25 0.00001 12.75 cm obtienes 0,5 0 0 0,25 1E-5 12,75 cm. Un parser de contenido lee eso como el número 0, luego un token ,5 que no reconoce, y luego más números que ya no se alinean con los seis operandos que cm espera, y la página se dibuja con una transformación que nunca pediste. Los números que una máquina va a parsear necesitan un punto fijo, sin exponente y sin dependencia alguna de FormatSettings, en el lado de escritura y en el de lectura
¿Por qué un locale con coma decimal rompe los números PDF?
Un locale con coma decimal rompe los números PDF porque el formateo float por defecto de Delphi sigue al escritorio, mientras que la sintaxis de números PDF es fija. FloatToStr usa FormatSettings.DecimalSeparator, así que en una máquina de-DE, fr-FR o pt-BR cada fracción sale con coma. La ISO 32000-1 §7.3.3 admite dígitos, un punto y un signo inicial en un número. Nada más. La coma por tanto parte un número en un entero válido más basura, y el resultado es una página que se renderiza, solo que mal
Hay una segunda trampa detrás de la primera, y muerde también en máquinas de EE. UU. FloatToStr usa el formato ffGeneral, que salta a notación de exponente en cuanto la magnitud baja de 1E-4, así que un offset diminuto se escribe como 1E-5. La misma §7.3.3 dice que PDF no soporta la forma de exponente. Trazar cualquiera de los dos problemas hacia atrás desde la salida renderizada es miserable, porque una matriz desviada se parece exactamente a un bug de maquetación de tu propio código y nada en la página apunta a las opciones regionales
PDFlibPas, la PDF Developer Library de losLab para Delphi, escribe los operandos de AddPageMatrix a través de PLDoubleToStrConst con seis decimales, y los sitios de llamada que generan contenido de página en tu nombre siguen la misma regla. El test de regresión más barato que conocemos cambia el separador a coma dentro del proceso, llama a la API y escanea el resultado en busca de comas y exponentes:
uses
  System.SysUtils, PDFlibrary;

// Tu propia comprobación, no forma parte de la librería. Es burda a propósito:
// las cadenas de texto como (Hello, world) Tj también contienen comas, así que ejecútala
// en una página de prueba que solo dibuje formas
function HasLocaleDamage(const Content: AnsiString): Boolean;
var
  I: Integer;
begin
  Result := False;
  for I := 1 to Length(Content) do
  begin
    if Content[I] = ',' then
      Exit(True);
    if (Content[I] in ['E', 'e']) and (I > 1) and (I < Length(Content)) and
       (Content[I - 1] in ['0'..'9']) and (Content[I + 1] in ['0'..'9', '-', '+']) then
      Exit(True);
  end;
end;

var
  Lib: TPDFlib;
  OldSeparator: Char;
  Content: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetPageDimensions(300, 200);
    Lib.DrawBox(10, 10, 20, 20, 1);
    OldSeparator := FormatSettings.DecimalSeparator;
    try
      FormatSettings.DecimalSeparator := ',';   // simula un escritorio de-DE
      Lib.AddPageMatrix(0.5, 0.25, 1E-5, 12.75);
      Content := Lib.GetPageContentToString;
      // Esperado: 0.5 0 0 0.25 0.00001 12.75 cm
      // FloatToStr habría producido: 0,5 0 0 0,25 1E-5 12,75 cm
      Writeln(Content);
      if HasLocaleDamage(Content) then
        Writeln('Locale leaked into the content stream');
    finally
      FormatSettings.DecimalSeparator := OldSeparator;
    end;
  finally
    Lib.Free;
  end;
end;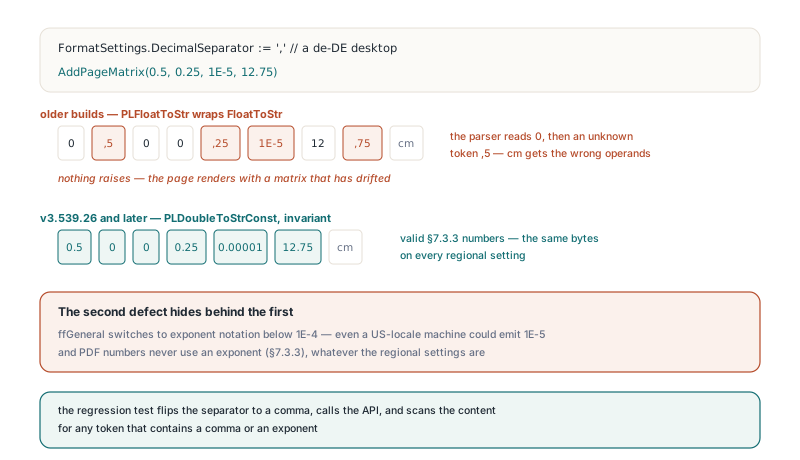
Cambiar FormatSettings.DecimalSeparator dentro del proceso es un atajo. No ejercita el código que construye su propio TFormatSettings desde el SO, así que si tu aplicación hace eso, un agente de CI con ajustes regionales alemanes reales es la prueba más honesta
Dos clases de números, dos familias de helpers
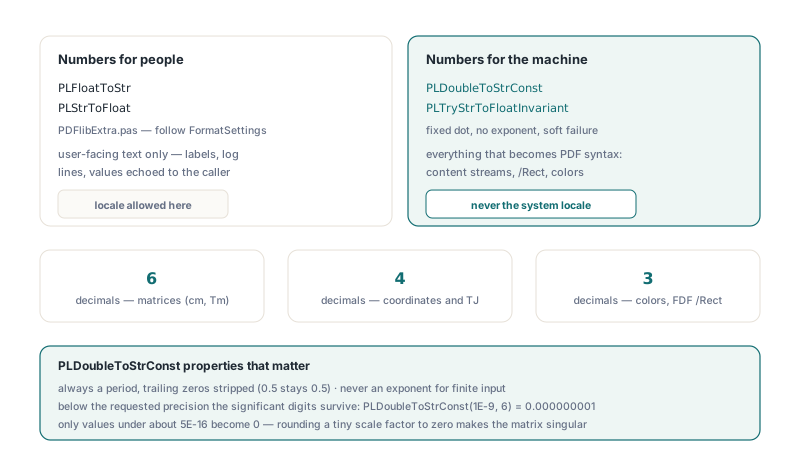
PDFlibPas parte sus helpers de números por audiencia: el texto mostrado a personas puede seguir el locale, y nada de lo escrito para una máquina lo hace. PLFloatToStr y PLStrToFloat en PDFlibExtra.pas son wrappers finos sobre FloatToStr y StrToFloat, y el comentario de su declaración dice que son solo para texto legible por humanos. La salida de máquina (PDF, FDF, XFDF, JSON, XML, CSV) pasa por la familia invariante: PLDoubleToStrConst para escribir, PLTryStrToFloatInvariant para leer, y PLInvariantFormatSettings cuando necesitas un registro TFormatSettings con decimal de punto para tus propias llamadas a TryStrToFloat
La precisión se elige por trabajo en lugar de globalmente. Las matrices obtienen seis decimales, las coordenadas y los ajustes de TJ cuatro, los colores y los rectángulos FDF tres. El lado de máquina cubre más sitios de los que la superficie de la API sugiere:
AddPageMatrix,ScalePageyDeskewPage, que anteponen uncmal contenido existente de la página- Los resets de
Tm, los avances deTJy las transformaciones decmescritos cuando se generan los elementos de página - Las matrices de colocación de glifos y los puntos de contorno producidos cuando el texto se convierte a paths
- La caja de relleno negro que antepone
RedactRegion, los valores de/Recten el export FDF y los operandos de color que escribe el recoloreado
PLDoubleToStrConst es un formateador hecho a mano, y pensamos que fue la decisión correcta frente a envolver FloatToStrF con un TFormatSettings fijo. ffFixed aún cae en notación científica en cuanto la parte entera supera la precisión, y dejaría 0.500000 donde 0.5 es más corto e idéntico. La rutina propia siempre escribe un punto, recorta los ceros finales y nunca escribe un exponente para entrada finita. También conserva los dígitos significativos de un valor distinto de cero menor que la precisión pedida: PLDoubleToStrConst(1E-9, 6) devuelve 0.000000001, y solo los valores por debajo de unos 5E-16 se convierten en 0. Redondear un factor de escala diminuto a cero convertiría una matriz válida en una singular, que es un fallo peor que cualquier decimal mal puesto
Si escribes tests unitarios contra el formateador, elige los valores de muestra con la coma flotante binaria en mente. La elección obvia para "cuatro dígitos significativos" es 0.000012345, pero multiplicado por 1E8 ese double es 1234.4999…, así que el resultado es 0.00001234 y la aserción falla por una razón sin relación con los locales. Un valor que esté claramente fuera del punto medio, como 0.000012346, evita la discusión entera:
uses
  PDFlibExtra;

// Las llamadas Assert son comprobaciones que añades en tu propio proyecto de tests
procedure CheckNumberHelpers;
var
  V: Double;
begin
  // Salida de máquina: decimal con punto, sin exponente, ceros finales recortados
  Assert(PLDoubleToStrConst(1E-5, 6) = '0.00001');
  Assert(PLDoubleToStrConst(-0.5, 6) = '-0.5');
  Assert(PLDoubleToStrConst(0.000012346, 4) = '0.00001235');  // se conservan 4 dígitos significativos
  Assert(PLDoubleToStrConst(12345.25, 4) = '12345.25');

  // Entrada de máquina: False en lugar de EConvertError
  Assert(PLTryStrToFloatInvariant('0.5', V) and (V = 0.5));
  Assert(PLTryStrToFloatInvariant('  12.75 ', V) and (V = 12.75)); // la entrada se recorta
  Assert(not PLTryStrToFloatInvariant('0,5', V));   // los números de contenido nunca usan coma
end;
¿Por qué el lado de parseo es más peligroso que el de escritura?
El lado de parseo es más peligroso porque un parser atado al locale no produce un número ligeramente equivocado; lanza. StrToFloat eleva EConvertError siempre que el texto no casa con el separador del sistema. Una pasada de recoloreado construida sobre él abortaría en el momento de llegar a un operador 0.5 g corriente en una máquina con coma decimal, lo que significa que falla en prácticamente cualquier página real. Una cadena de clip como "10.5,20.5,50.5,40.5" se rechazaría sin más, y las longitudes SVG, los colores SVG, las listas de vértices de anotaciones y los valores de output intent se rechazarían o se sustituirían en silencio por valores por defecto. Ese es código que pasa todos los tests en la máquina del desarrollador y falla con el primer cliente de Múnich, la misma familia de problema que los casos de el artículo sobre código Delphi que funciona por accidente
Toda llamada estilo StrToFloat en la librería está ordenada por de dónde viene su entrada. Los operandos de content streams, los atributos SVG, las cadenas de color del painter y las listas de clip y vértices separadas por comas tienen todas una sintaxis fija de punto, así que pasan por PLTryStrToFloatInvariant. Ese helper recorta el texto, lo parsea con PLInvariantFormatSettings y devuelve False (con el valor puesto a 0) ante entrada vacía, malformada, NaN o infinita. Las listas separadas por comas no necesitaron debate alguno: una coma no puede ser a la vez delimitador de lista y marca decimal, así que no hay forma heredada con la que mantener compatibilidad
Para la pipeline de recoloreado descrita en la guía para convertir un PDF a un espacio de color, el resultado es que RecolorPage y RecolorDocument parsean el contenido de página de forma idéntica en cada locale. Los valores de reglas que un llamador teclea en CheckDocumentPolicy son el único caso de parseo que toma la ruta tolerante, porque esa cadena la tecleó una persona y bien pudo usar la marca decimal local
Un número que viaja por una cadena necesita que ambos extremos se pongan de acuerdo
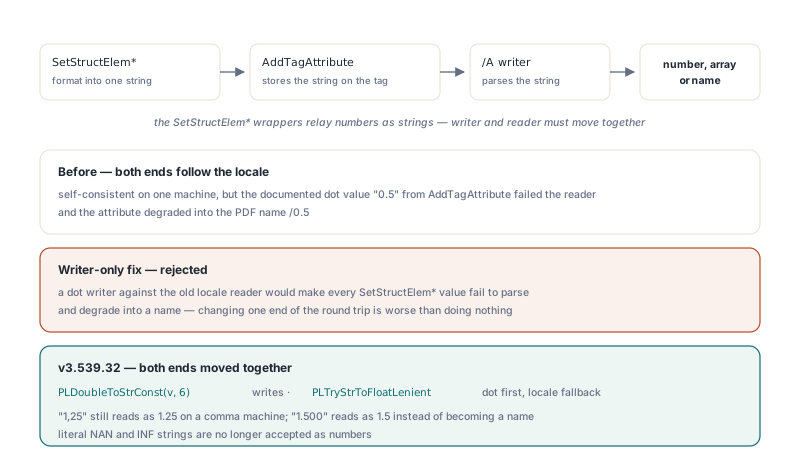
Cuando un número se escribe a una cadena por una parte del código y se parsea de vuelta por otra, el escritor y el lector tienen que seguir la misma convención, y cambiar solo uno de ellos rompe el round trip. Los atributos de estructura del PDF etiquetado funcionan exactamente así. SetStructElemBBox formatea cuatro valores en una cadena y la guarda a través de AddTagAttribute. Cuando el diccionario de atributos /A se escribe, esa cadena se parsea otra vez para decidir si se convierte en número, array o name
Si ambos extremos siguieran el locale del sistema, el viaje sería autoconsistente en una máquina alemana. El problema empieza con un llamador que sigue la documentación y pasa "0.5" a AddTagAttribute: un lector atado al locale no puede parsearlo y emite el name PDF /0.5. Los placeholders PDF/VCR sufren la imagen especular, ya que su GTS_BBox se genera con punto y un paso de validación atado al locale antes de guardar lo rechazaría. Y cambiar solo el escritor al punto empeora las cosas, porque cada valor de SetStructElem* se convertiría entonces en un name en sistemas con coma decimal
Así que los escritores usan PLDoubleToStrConst(v, 6) y el lector usa PLTryStrToFloatLenient, que prueba primero la forma con punto y recurre al locale del sistema. Un llamador con locale de coma que pasa "1,25" obtiene el número 1.25. Hay un coste, y lo aceptamos a sabiendas: en un sistema alemán "1.500" se lee como 1.5 en lugar de mil quinientos, porque la forma con punto gana. La API documenta el punto como separador, así que un grupo de miles estilo alemán en una cadena de atributo es la entrada que elegimos abandonar. Las cadenas literales NAN e INF no se tratan como números
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
begin
  FormatSettings.DecimalSeparator := ',';   // llamador con coma decimal
  Lib := TPDFlib.Create;
  try
    Lib.BeginTag('Figure', 'Sales chart', '');
    Lib.SetStructElemBBox(10.5, 20.25, 200.5, 100.75); // /BBox [ 10.5 20.25 200.5 100.75 ]
    Lib.AddTagAttribute('Layout', 'SpaceAfter', '0.5');   // /SpaceAfter 0.5 en lugar de /0.5
    Lib.AddTagAttribute('Layout', 'StartIndent', '1,25'); // /StartIndent 1.25 vía el fallback al locale
    Lib.DrawText(20, 20, 'figure');
    Lib.EndTag;
    Lib.SaveToFile('tagged.pdf');
  finally
    Lib.Free;
  end;
end;
Nuestra recomendación para tu propio código es pasar cadenas con decimal de punto a AddTagAttribute y dejar el fallback de coma para valores que no puedes controlar, como cadenas cargadas de un fichero de configuración antiguo. Cómo se construye el árbol de estructura alrededor de esos atributos está cubierto en la guía de estructura de PDF etiquetado
Dónde se detienen NaN e infinito
AddPageMatrix, ScalePage y RedactRegion rechazan de entrada los argumentos NaN e infinitos y devuelven 0, ya que ningún número PDF puede representar ninguno de los dos. La comprobación tiene que ser explícita. NaN se cuela por un test <= 0, así que una comprobación de rango sobre un factor de escala solo dejaría viajar un NaN hasta el formateador, y llamar a Round sobre NaN eleva EInvalidOp en Win32, donde la unidad x87 no enmascara las operaciones inválidas por defecto. PLDoubleToStrConst escribe 0 para NaN como última línea de defensa, pero un cero dentro de una matriz es una transformación singular, así que la comprobación a nivel de API es la que de verdad protege la página. En tu propio código, comprueba el valor de retorno: cuando ScalePage devuelve 0 para un factor que calculaste, imprime el factor antes que nada, porque un 0/0 en algún punto aguas arriba produce exactamente este NaN
Dos fronteras son deliberadas. Las cadenas de estado de metafiles se escriben y se leen con el locale dentro de un único proceso y nunca llegan a un fichero, así que se quedan atadas al locale. Y si pruebas valores pequeños por la ruta de generación de página, lee el contenido justo después de la llamada: una operación que más tarde reemite el contenido de la página a la precisión de coordenadas del documento convertirá legítimamente 1E-5 en 0, y eso es redondeo, no una fuga de locale
El hábito que vale la pena adoptar es corto. Ejecuta una vez las rutas de tu aplicación que producen PDF con separador coma, escanea la salida en busca de comas y exponentes, y mantén FloatToStr fuera de todo lo que un parser vaya a leer. Los números leídos de un fichero existente siguen una regla relacionada, cubierta en el artículo sobre conservar la precisión decimal parseada, donde el texto fuente exacto sobrevive a un guardado. Las builds de prueba, la referencia de la API y los detalles de licencia están en la página de producto de la PDFlibPas Delphi PDF library