Un contrato exportado desde un procesador de textos con la casilla «tagged PDF» sin marcar todavía se ve estructurado en pantalla: un título en negrita de 24 puntos, cláusulas numeradas, un cuadro de tarifas con reglas. Conviértalo a HTML reflowable y el cuadro de tarifas regresa como una <table> de verdad, mientras que el título es un <p> con exactamente la misma categoría que una nota al pie. Esa salida es correcta. ISO 32000-1 §14.8 le da a un PDF exactamente un lugar para decir «esta tira de texto es un encabezado», el árbol de estructura, y un archivo sin etiquetas no lo tiene. El tamaño de fuente y la negrita son decisiones de tipografía, y un conversor que convierte cada línea grande y en negrita en un <h1> también va a promover citas destacadas, totales de tabla y el nombre de la empresa en el membrete
La pregunta que vale hacerle a cualquier pipeline de PDF a HTML es, entonces, de dónde salió cada encabezado, elemento de lista y tabla en su salida, y qué tanto se puede confiar en cada uno desde un layout de teléfono, un lector de pantalla o un indexador de búsqueda. Los encabezados y las tablas dan respuestas distintas. El paso de exportación agrega sus propias decisiones sobre saltos de línea, codificación de caracteres y memoria
De dónde salen los encabezados y las listas
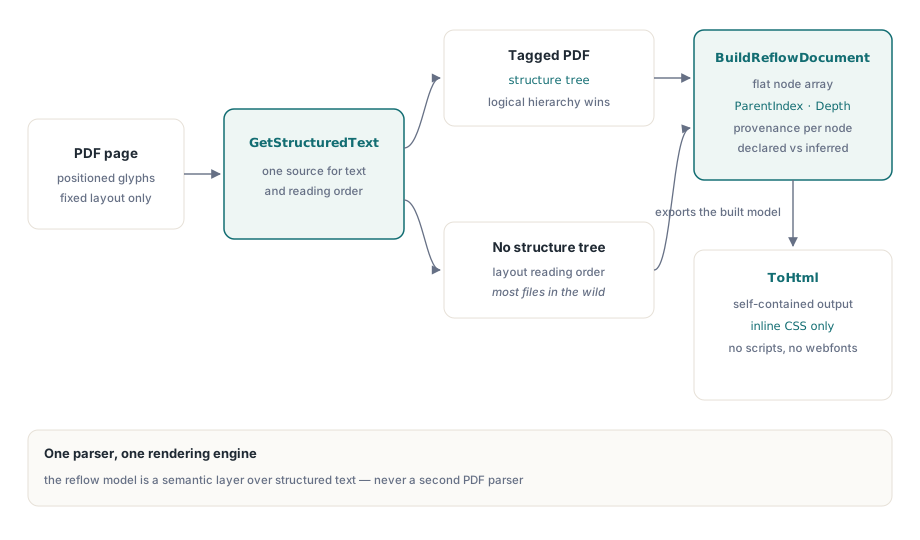
PDFium Component construye el modelo de reflow con TPdf.BuildReflowDocument, y ese método toma cada palabra, bloque y pista semántica de GetStructuredText, la misma capa de texto estructurado descrita en bloques de texto estructurado y orden de lectura. No hay un segundo parser ni un segundo extractor de texto detrás. Para cada página del rango pedido recolecta los bloques en orden de layout físico. GetStructuredText ya emparejó cada bloque con el contenido etiquetado de la página por área de superposición, y BuildReflowDocument copia el rol que encontró sobre el bloque: H hasta H6 se vuelven encabezados con su nivel, LI, Lbl y LBody se vuelven elementos de lista, Figure se vuelve una figura cuyo texto es la descripción alternativa, y Caption se vuelve una leyenda
Dos consecuencias se siguen, y ambas son fáciles de observar. El orden de bloques siempre sigue el layout de la página, incluso en un archivo etiquetado, así que las etiquetas deciden qué es un bloque y la geometría decide dónde va. Y en una página sin etiquetas cada bloque es un párrafo. Los encabezados y las listas nunca se adivinan desde el tamaño de fuente
Cada nodo lleva un campo Source de tipo TPdfReadingOrderSource: rosStructure cuando el rol vino del árbol de estructura, rosHeuristic cuando vino del layout solo. El HTML exportado repite esto como data-source="structure" o data-source="inferred" en cada elemento, y el TPdfReflowDocument.Source a nivel de documento es rosStructure solo cuando todas las páginas del rango estaban etiquetadas. Las tablas son siempre rosHeuristic, porque vienen de detección geométrica y no de tags Table. Si un paso aguas abajo trata los encabezados como landmarks de navegación, chequee ese campo primero; un documento etiquetado le da landmarks que el autor eligió
Un array plano de nodos en lugar de un árbol de objetos
TPdfReflowDocument.Nodes es un árbol aplanado en preorden: un array dinámico de records TPdfReflowNode, cada uno con un ParentIndex y una Depth. Los nodos de página se sientan en profundidad 0 con índice de padre -1. Los párrafos, encabezados, figuras, leyendas, listas y tablas cuelgan de la página en profundidad 1, los elementos de lista se sientan en profundidad 2 debajo de su lista, y las celdas de tabla alcanzan profundidad 3 debajo de una fila. Los elementos de lista consecutivos comparten un nodo de lista; cualquier otro bloque o una tabla entre ellos arranca una lista nueva
El layout plano es una decisión de portabilidad. Un record recursivo que contiene un array dinámico de sí mismo compila bajo Delphi, C++Builder y Free Pascal, pero los tres manejan los tipos administrados recursivos de forma distinta a través de una frontera de package o DLL. Un array plano de records corrientes se comporta igual en los tres, y se puede transmitir con un bucle for y sin recursión
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // todas las páginas, tablas activadas, CSS activado
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // en un nodo de tabla RowSpan/ColumnSpan guardan los conteos de filas y columnas de la tabla
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
Sobre el contrato sin etiquetas del inicio, ese bucle no imprime ninguna línea H y una línea de tabla por cada cuadro de tarifas detectado. Córralo sobre una copia etiquetada del mismo documento y los encabezados aparecen con True al lado. FirstPage y LastPage en las opciones vienen en 0, que significa la primera y la última página del documento; un rango fuera del conteo de páginas lanza un EPdfError antes de leer cualquier página
¿Cómo se evita que las tablas aparezcan dos veces?
La detección de tablas corre sobre cada página después de que el texto estructurado fue recolectado, lo que significa que las palabras dentro de una tabla existen dos veces: una como bloques de texto, otra como celdas. Emita ambas y cada tabla del HTML va seguida de su propio contenido otra vez como párrafos sueltos, que es exactamente lo que produce un merge ingenuo de «agregar las tablas al texto»
El modelo lo resuelve geométricamente. Un bloque de texto cuyo bounding box queda al menos la mitad dentro de los límites de una tabla detectada se bota, y el nodo de tabla toma su lugar. Las tablas luego se intercalan con los bloques restantes por posición vertical (más arriba en la página primero, con izquierda a derecha como desempate cuando los bordes superiores están dentro de medio punto), así que una tabla cae entre el párrafo de arriba y el párrafo de abajo en lugar de agregarse al final de la página
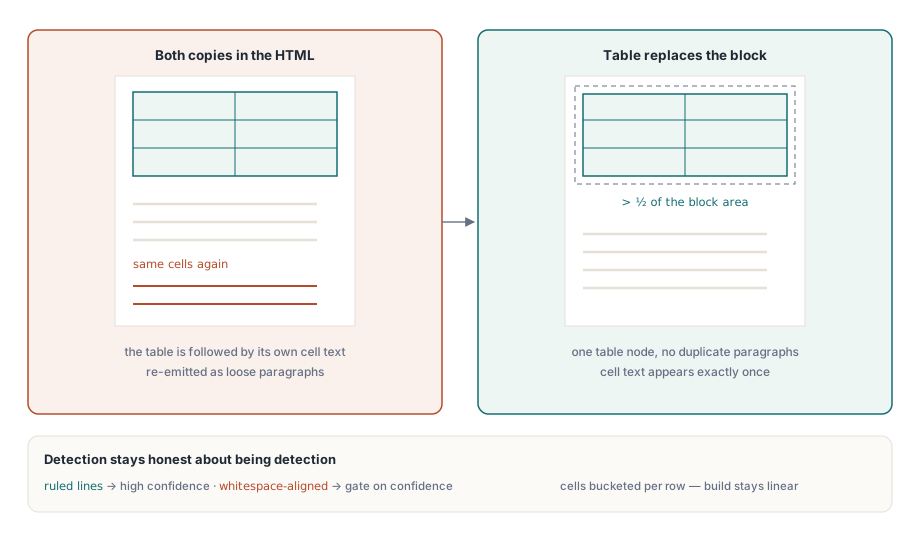
El umbral de media área tiene un filo visible. Un bloque que cabalga el borde de la tabla y se sienta mayormente afuera sobrevive intacto, así que una línea de texto puede ocasionalmente aparecer tanto en la última fila como en el párrafo que sigue. Ese es el lado correcto donde equivocarse. Un umbral lo bastante bajo para quitar cada bloque superpuesto también borraría texto de cuerpo que apenas toca el bounding box de una tabla, y una línea duplicada es mucho más fácil de notar y perdonar que una frase ausente
Las tablas detectadas también llevan una confianza, y las dos estrategias de detección aterrizan en bandas distintas. Una tabla encontrada desde líneas de regla puntúa entre 0.88 y 1.0, según cuántas de sus celdas tengan texto. Una tabla inferida puramente de alineación de espacios en blanco puntúa entre 0.58 y 0.88. La Confidence del nodo de tabla sostiene ese puntaje, cada nodo de celda lo repite, y el HTML lo escribe como data-confidence en el elemento <table>. Las tablas por debajo de TableOptions.MinConfidence (0.5 por defecto) nunca se crean, y cuando una tabla se rechaza sus palabras simplemente se quedan en el modelo como párrafos corrientes
Para un índice de búsqueda o una vista de lectura móvil, una tabla equivocada cuesta poco y una bien detectada es una gran mejora, así que deje los defaults. Para conversión de archivo, donde una grilla inventada alrededor de un bloque de dirección de dos columnas es peor que ninguna grilla, restrinja la detección a tablas con reglas:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // solo tablas con reglas
Options.TableOptions.MinConfidence := 0.9;            // bota también las grillas con reglas dispersas
Options.TableOptions.MaxTables := 200;                // techo de todo el documento
Options.TableOptions.MaxCells := 50000;               // techo de todo el documento

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
Dentro de un build de reflow, MaxTables y MaxCells se cuentan a través de todo el rango de páginas, no por página, así que un estado de cuenta de 300 páginas con una tabla con reglas en cada página necesita un MaxTables de al menos 300 o el build se detiene con EPdfError en la primera tabla sobre el límite. Los defaults son 1000 tablas y 100000 celdas
Para el lado de detección en sí, incluidos los rectángulos delgados rellenos dibujados como bordes y la continuación entre páginas, vea detección y extracción de tablas
Exportar HTML que no necesita nada más
TPdfReflowDocument.ToHtml recorre el modelo que ya fue construido y nunca vuelve a tocar PDFium, así que exportar el mismo modelo dos veces produce el mismo string. Con FullDocument activado (el default) el resultado es una página completa: doctype, <meta charset="utf-8">, un meta tag de viewport, un <title> tomado de la entrada Title del documento (o «PDF document» cuando está vacía), y un atributo lang desde el lenguaje del documento. Con FullDocument apagado obtiene un único fragmento <div class="pdf-reflow"> para meter en su propia plantilla
La hoja de estilos opcional de IncludeCss es un solo bloque <style> en línea: una columna de lectura de 72rem, cada página PDF como una tarjeta blanca cuando IncludePageSections está activado, bordes de tabla colapsados, y un media query por debajo de 40rem que quita el padding de la tarjeta y achica el texto de tablas. No hay script, ni web font, ni URL externa, que es lo que deja al archivo sentarse dentro de un correo, un visor de ayuda estilo CHM o un control de navegador en sandbox. Los niveles de encabezado fuera de 1 a 6 se escriben como h2, las celdas de encabezado se vuelven th, y las celdas con RowSpan o ColumnSpan por encima de 1 obtienen rowspan y colspan. Encender IncludeGeometry agrega data-left, data-top, data-right y data-bottom en puntos PDF, lo que es útil para resaltar un hit de búsqueda de vuelta sobre la página renderizada
PreserveLineBreaks merece una elección deliberada. Un salto de línea dentro de un párrafo PDF se hizo para un ancho de columna fijo; consérvelo en una pantalla de 360 píxeles y cada línea envuelve dos veces, el patrón dentado que el reflow existe para quitar. Déjelo apagado (el default) para prosa. Actívelo para documentos donde el salto carga significado, como direcciones, verso o listados de código, y escribe <br> en lugar de un espacio
Para un documento largo, construir la página entera como un WString y luego codificarla duplica el pico de memoria. WriteHtml transmite el mismo markup dentro de un TPdfReportWriter en su lugar, escribiendo ASCII con cada carácter no ASCII como referencia de carácter numérica, así que los bytes son válidos sin importar cómo adivine la codificación el lado receptor:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // el estado de página se restaura después

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // techo de bytes de salida, máximo 64 MiB
  Limits.MaxItems := Options.MaxNodes;       // un ítem por nodo, máximo 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // el stream queda en propiedad del llamador
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml chequea más de lo que chequea ToHtml. Se rehúsa a un modelo con más nodos que Options.MaxNodes, hace valer Options.MaxCharacters sobre el texto que escribe, limita el anidamiento al argumento MaxDepth (64 por defecto), y verifica que cada ParentIndex apunte a un nodo anterior. Ese último chequeo importa si su código filtra o reescribe Nodes antes de exportar: un array editado con un índice de padre hacia adelante lanza EPdfReportLimit en lugar de producir markup con tags desparejados
Presupuestos, cancelación y estado de página
Un PDF es entrada no confiable, y un archivo malformado u hostil puede declarar miles de páginas de texto diminuto. BuildReflowDocument chequea los presupuestos de caracteres, nodos, tablas y celdas antes de agregar cada nodo, así que un archivo que los excede se detiene con EPdfError y un mensaje que nombra el presupuesto («Reflow node budget exceeded», por ejemplo) mientras el uso de memoria sigue acotado. Tanto MaxCharacters como MaxNodes deben ser positivos; los defaults son 10,000,000 caracteres y 1,000,000 nodos
El IPdfCancellationToken opcional se chequea antes de cada página, entre bloques, antes de cada tabla y antes de cada fila de tabla. Pase el Token de un TPdfCancellationTokenSource de su formulario, llame a Cancel desde el handler del botón, y el build lanza EPdfOperationCancelled en el siguiente de esos checkpoints. Atrápelo separado de EPdfError para que el cancel de un usuario no se registre como archivo roto. Con la excepción que termine el build, no se devuelve nada parcial; si el fallo ocurre después dentro de WriteHtml, el archivo destino sostiene una página truncada, así que bótelo en su propio handler de excepciones
El estado de página es el detalle del que depende el código GUI. El build visita cada página del rango moviendo PageNumber, y un try/finally devuelve la página del llamador en el éxito, en un fallo de presupuesto y en una cancelación por igual. Un visor que arranca una exportación mientras el usuario lee la página 340 sigue en la página 340 cuando la exportación retorna
Dónde encaja el reflow
La salida de reflow funciona bien como entrada para indexación de búsqueda, vistas de lectura accesibles, display de teléfono y migración de contenido a un CMS. Suelta deliberadamente el posicionamiento absoluto, las fuentes exactas, el arte vectorial y la geometría de página, salvo las coordenadas data-* opcionales. Cuando un trabajo necesita que la página se vea idéntica, renderícela; cuando necesita que las palabras sean legibles en otro lado, reflowéela
Como los encabezados y las listas vienen solo de etiquetas, la calidad del HTML sigue la calidad del etiquetado aguas arriba. Los documentos que pasan los chequeos de validación del árbol de estructura PDF/UA producen modelos con jerarquía de encabezados real, y el mismo contenido etiquetado maneja las funciones de lectura de construir un lector accesible
El reflow, el texto estructurado, la extracción de tablas y el renderizado corren todos contra el mismo objeto TPdf en Delphi, C++Builder y Lazarus; los records de opciones, las excepciones y el report writer están documentados en la página del producto PDFium Component para Delphi