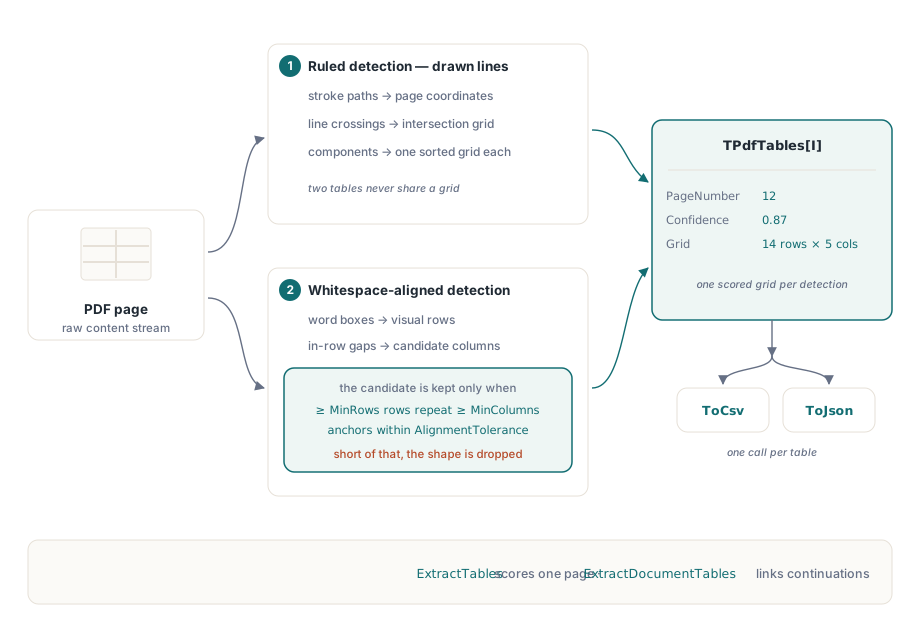
PDFium Component detecta tablas en una página PDF y las devuelve como una cuadrícula de celdas con spans de fila y columna, filas de encabezado y un valor de confianza, mediante ExtractTables para una página y ExtractDocumentTables para un documento completo. Cada tabla se convierte a CSV o JSON con una sola llamada, y las tablas que continúan después de un salto de página se pueden enlazar en una cadena de continuación
PDF no tiene un objeto tabla. Una tabla en un PDF es un conjunto de bloques de texto posicionados de modo que un humano los lea como una cuadrícula, a veces con líneas dibujadas alrededor y a menudo sin ellas. Recuperar la cuadrícula significa reconstruir una intención que el archivo nunca registró, razón por la cual cada herramienta de extracción produce resultados ligeramente distintos, y por la cual una herramienta que le dice su nivel de confianza es más útil que una que no lo hace
Dos modos de detección para dos tipos de tabla
La detección por líneas usa las líneas dibujadas. Cada segmento de trazo se transforma a coordenadas de página mediante la matriz del objeto de página, las líneas horizontales y verticales se intersecan, y las intersecciones forman componentes conectados. Cada componente se convierte en su propia cuadrícula ordenada de posiciones X e Y, que es lo que evita que dos tablas separadas en la misma página se fusionen en una cuadrícula sin sentido
La detección por espacios en blanco maneja tablas dibujadas mediante alineación en lugar de líneas. Los cuadros de palabras se agrupan en filas visuales, los espacios dentro de una fila la dividen en columnas candidatas, y una tabla se acepta solo cuando al menos MinRows filas repiten al menos MinColumns anclas alineadas a la izquierda dentro de AlignmentTolerance. El factor de espacio entre filas es 3 por defecto, lo cual cubre el espaciado de línea base de aproximadamente 30 puntos típico de texto de 12 puntos, sin dejar que una sola línea con varios bloques de texto se haga pasar por una tabla
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'annual-report.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 12;                    // basado en 1

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectRuledTables := True;
    Options.DetectWhitespaceTables := True;
    Options.MinConfidence := 0.6;            // el valor por defecto es 0.5
    Options.HeaderRowCount := 1;

    Tables := Pdf.ExtractTables(Options);
    for I := 0 to High(Tables) do
      Writeln(Format('table %d: %dx%d cells, confidence %.2f, mode %d',
        [I, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Ord(Tables[I].DetectionMode)]));

    if Length(Tables) > 0 then
      SaveText('page12-table0.csv', Tables[0].ToCsv);
  finally
    Pdf.Free;
  end;
end;
El proyecto completo viene incluido con el componente como Demo/Delphi/TableExtractionLab/TableExtractionLab.dpr, con sus equivalentes para C++Builder y Lazarus bajo Demo/CBuilder/TableExtractionLab y Demo/Lazarus/TableExtractionLab. El laboratorio arma un documento de ejemplo que contiene una tabla con líneas y celdas de encabezado combinadas, una tabla alineada por espacios en blanco sin líneas de ningún tipo, y una tabla larga que se corta en un salto de página; luego extrae cada una y muestra las celdas, los spans, la confianza, los grupos de continuación y la salida CSV / JSON, lo que lo convierte en la forma más rápida de ver cómo interactúan estas opciones. La detección de tablas llegó en la versión 3.36.0, así que si el compilador marca TPdfTableExtractionOptions o TPdfTables como identificador desconocido, la copia de la librería en su proyecto es anterior a ese release y hay que actualizarla antes de que este código compile
¿Cómo se recuperan las celdas combinadas?
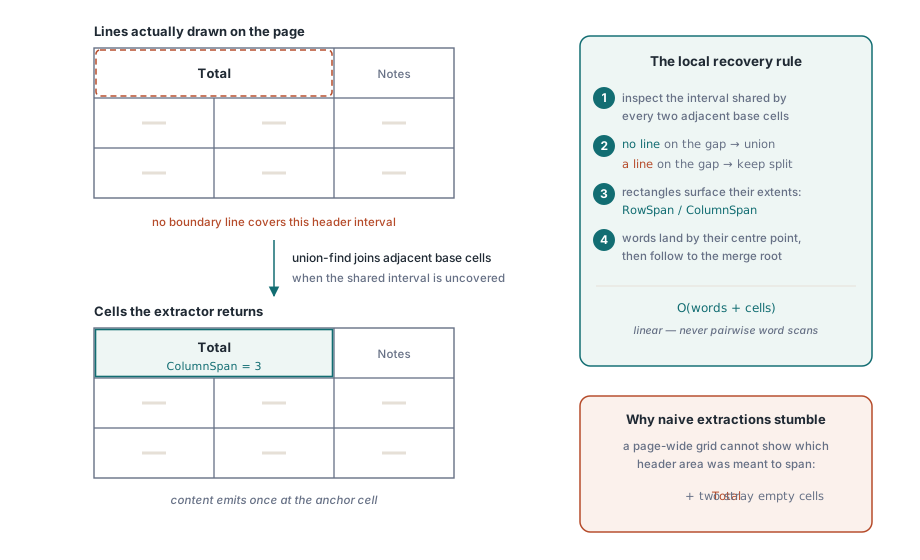
Esta es la parte que los extractores ingenuos hacen mal. Una celda combinada no se puede identificar solo a partir de la cuadrícula global, porque la cuadrícula se deriva de todas las líneas de la página, y una región combinada simplemente carece de la línea interior que la habría separado
La regla que se usa aquí es local: dos celdas base adyacentes se combinan cuando ninguna línea de límite cubre el intervalo entre ellas. Union-find las une, los componentes rectangulares resultantes se convierten en los valores RowSpan y ColumnSpan, y el texto se asigna a una celda base por su punto central y luego sigue a esa celda hasta su raíz de combinación. Hacerlo así también mantiene el costo lineal en palabras más celdas, en lugar del escaneo cuadrático que se obtiene al probar cada palabra contra cada celda
El efecto práctico es que una tabla financiera con un encabezado "Total" combinado que abarca tres columnas sale como una celda con span tres, en lugar de una celda con contenido y dos celdas vacías misteriosas
Continuación entre páginas
Las tablas largas se cortan entre páginas, y tratar el fragmento de cada página como una tabla independiente obliga al llamador a coserlas. ExtractDocumentTables puede enlazarlas en su lugar, pero solo bajo condiciones estrictas: el fragmento debe ser la tabla más baja en la página anterior, la siguiente debe ser la tabla más alta en la página siguiente, los números de página deben ser adyacentes, y los límites de columna deben coincidir
Las cuatro condiciones juntas son lo que evita el error obvio, que es encadenar toda tabla de cuatro columnas en un documento en una imaginaria mega-tabla solo porque comparten la cantidad de columnas. Cuando las condiciones se cumplen, las tablas comparten un identificador de grupo de continuación y llevan metadatos de continuación; cuando no se cumplen, usted obtiene tablas separadas y puede decidir por su cuenta
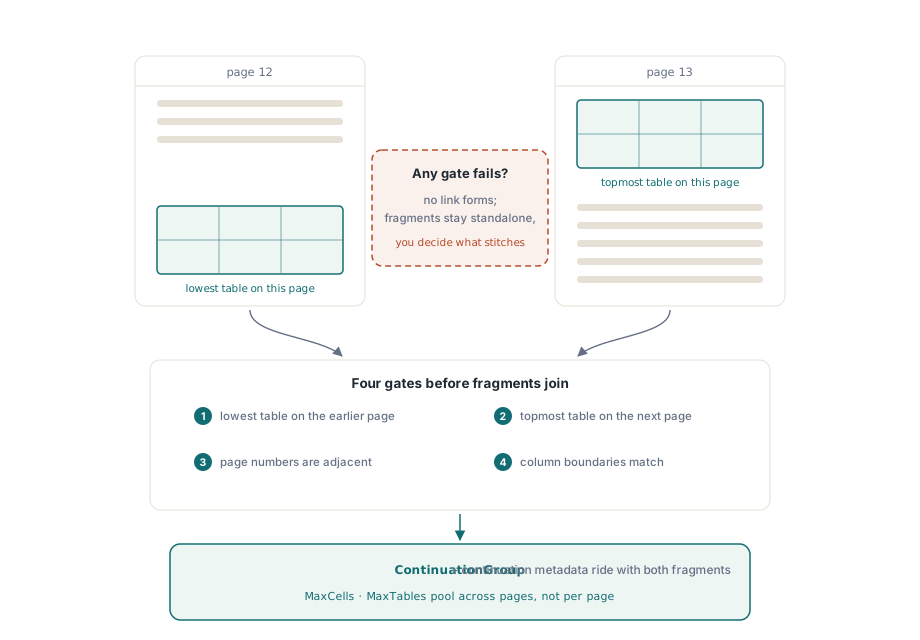
La extracción a nivel de documento comparte los presupuestos MaxCells y MaxTables entre páginas en lugar de reiniciarlos por página, y restaura la página activa dentro de un bloque finally, de modo que una extracción ejecutada dentro de un visor deja al usuario mirando la página en la que estaba
Exportar sin corromper los datos
Ambos exportadores son deliberados respecto al escapado. CSV siempre entrecomilla los campos y duplica las comillas internas, lo cual evita el fallo clásico en el que una celda que contiene una coma se convierte en silencio en dos columnas. Para las celdas combinadas, el contenido se emite solo en el ancla superior izquierda, de modo que un ciclo de ida y vuelta por CSV no duplica un encabezado que abarca varias columnas a lo largo de las columnas que cubre
JSON preserva Unicode en lugar de escaparlo a ASCII, escapa los caracteres de control, e incluye los metadatos que un consumidor necesita para juzgar la calidad: modo de detección, confianza, límites, valores de span, banderas de encabezado e información de continuación. Si usted está alimentando tablas extraídas a un sistema posterior, prefiera JSON, porque una fila de CSV no le puede decir que la tabla de la que proviene obtuvo una confianza de 0.51:
// Extracción de todo el documento, conservando solo las tablas confiables
Tables := Pdf.ExtractDocumentTables(Options);
for I := 0 to High(Tables) do
begin
  if Tables[I].Confidence < 0.75 then
  begin
    Log(Format('page %d table needs review (%.2f)',
      [Tables[I].PageNumber, Tables[I].Confidence]));
    Continue;
  end;
  if Tables[I].ContinuationGroup > 0 then
    AppendToGroup(Tables[I].ContinuationGroup, Tables[I].ToJson)
  else
    EmitStandalone(Tables[I].ToJson);
end;
Ajustar, y saber cuándo detenerse
Tres ajustes importan más que el resto. MinConfidence es la barrera de calidad, y 0.5 es deliberadamente permisivo; súbalo para una ingesta automatizada y bájelo para una interfaz de revisión donde un humano confirma cada resultado. MinColumnGap decide qué cuenta como límite de columna en el modo de espacios en blanco, y las tablas con ajuste apretado en informes densos pueden necesitar reducirlo desde el valor por defecto de 12 puntos. MaxRowGapFactor decide cuándo la distancia vertical termina una tabla, algo que importa para tablas con filas en blanco ocasionales
Sea honesto sobre los límites. Las tablas con líneas se extraen de forma confiable. Las tablas de espacios en blanco alineadas con limpieza se extraen bien. Las tablas con texto rotado, tablas anidadas, o celdas cuyo contenido se envuelve hasta parecer otra fila, van a necesitar revisión sin importar cómo se configuren los parámetros. Para esos casos, el modelo de texto estructurado le da la materia prima para construir un lector específico de su dominio, descrito en bloques de texto estructurado y orden de lectura
Una combinación útil: cuando un documento escaneado no tiene texto en absoluto, la detección de tablas no tiene con qué trabajar hasta que exista una capa de texto. Agregue una primero, como se describe en agregar una capa de texto con capacidad de búsqueda a PDF escaneados, y luego extraiga. Los cuadros de palabra que devuelve un proveedor de OCR son exactamente la entrada que necesita la detección por espacios en blanco
La extracción de tablas, el texto estructurado y el reflow leen todos del mismo modelo de página en Delphi, C++Builder y Lazarus; la API completa se describe en la página de PDFium Component para Delphi