Un paper de congreso de dos columnas ordenado por posición vertical regresa con una primera línea como Abstract We measure the 2 Related work Earlier studies: las palabras iniciales de la columna izquierda y las palabras iniciales de la columna derecha, pegadas porque ambas se sientan sobre la misma línea base. Nada salió mal en el parser. Una página PDF ofrece dos órdenes defendibles para su texto, la secuencia en que el content stream lo pinta y la posición de cada glifo en la página, y para muchos layouts esos dos órdenes discrepan. Un extractor que devuelve bloques posicionados en lugar de un solo string le deja ver qué orden recibió y cambiar cuando es el equivocado para la página que tiene enfrente
Qué devuelve GetStructuredText
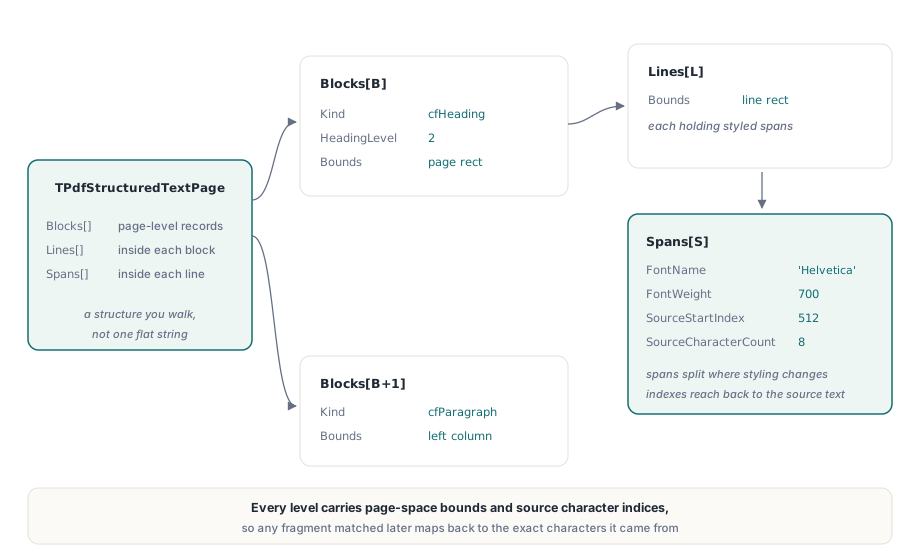
TPdf.GetStructuredText en PDFium Component devuelve una TPdfStructuredTextPage para la página actual: un arreglo de bloques, cada bloque un arreglo de líneas, cada línea un arreglo de spans estilizados. Cada nivel carga su propio Text y un rectángulo Bounds en espacio de página en puntos PDF, así que un encabezado, una sola línea o una frase en negrita se puede ubicar en la página sin una segunda búsqueda. El registro de página agrega Width, Height, CharacterCount y dos contadores de calidad descritos más abajo
El Page.Text aplanado se construye desde los bloques en lugar del stream de caracteres crudo. Las líneas dentro de un bloque se unen con un solo CRLF y los bloques se separan con una línea vacía, lo que significa que un volcado de texto plano de Page.Text ya muestra dónde trazó el extractor sus límites de bloque. Eso lo vuelve lo más rápido de imprimir cuando una página se lee extraña
Todo esto lo maneja un pequeño registro de opciones. TPdfStructuredTextOptions.Default pone ReadingOrder en roPhysicalLayout, enciende IncludeFontInfo y IncludeSemantics, y pone MaxCharacters en 1,000,000. El campo de orden de lectura es el que más cambia la forma de la salida
Cómo los dos órdenes de lectura construyen líneas y bloques
roContentOrder conserva la secuencia de dibujo del productor, mientras que roPhysicalLayout reconstruye el orden desde posiciones de glifo, y la diferencia se ve primero en cómo se forman las líneas. En orden de contenido, los caracteres se toman en el orden en que la página los dibuja. Una línea nueva empieza en un salto de línea explícito o cuando el siguiente carácter ya no se superpone verticalmente con la línea actual. Una línea se une entonces al bloque justo antes de ella solo si los dos se superponen horizontalmente por al menos una quinta parte del ancho más angosto y el hueco vertical es de cuando mucho unos dos y cuarto altos de línea; si no, abre un bloque nuevo. Los bloques se quedan en orden de dibujo
El layout físico tira la secuencia de dibujo. Cada carácter con caja conocida se ordena por el centro vertical de esa caja, arriba de la página primero, luego por su borde izquierdo. Los caracteres cuyas extensiones verticales se superponen lo bastante comparten línea, y esa prueba mira solo la altura. La distancia horizontal no juega ningún papel en ella. Cada línea se une entonces al bloque existente que mejor le quede en cualquier parte de la página por la misma regla de superposición-y-hueco, y los bloques terminados se ordenan por su borde superior, con el borde izquierdo rompiendo empates dentro de medio punto
Esa segunda regla es de donde viene el ejemplo inicial. Cuando las dos columnas de un paper comparten una retícula de líneas base, la primera línea de la columna izquierda y la primera de la derecha se superponen verticalmente, así que el layout físico las pone en una línea. El hueco en el canal es más ancho que un cuarto del tamaño de fuente, así que el extractor inserta un espacio y sigue. Cada línea del cuerpo hace lo mismo, las líneas fusionadas se superponen todas entre sí horizontalmente, y el cuerpo completo de dos columnas se vuelve un solo bloque ancho que se lee derecho a través del canal
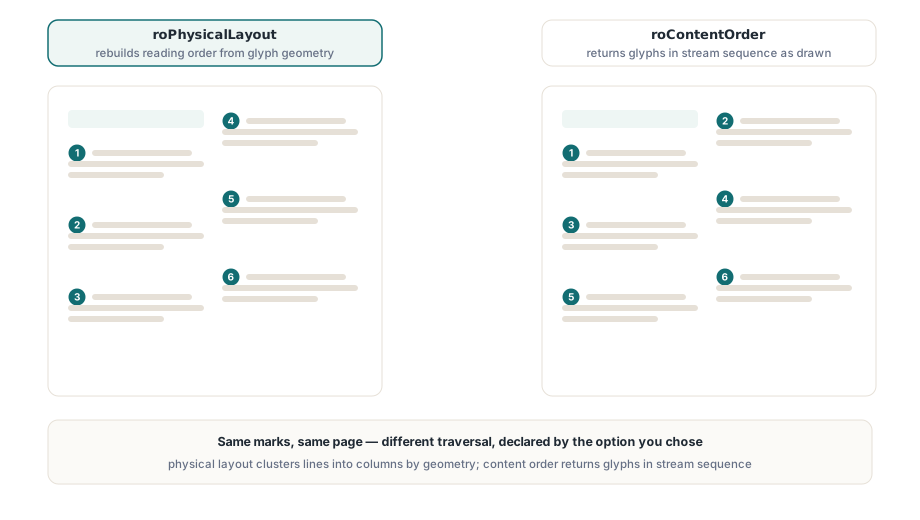
El orden de contenido maneja bien esa página siempre que el productor escribió la columna uno antes de la dos, que es lo que los procesadores de texto y los sistemas de composición normalmente hacen. Las líneas de la columna izquierda se apilan en bloques, la primera línea de la columna derecha no tiene superposición horizontal con ellas y abre un bloque fresco, y los bloques salen en el orden en que el autor los escribió. El layout físico se gana su lugar en otro tipo de página: facturas, estados de cuenta, formularios y diapositivas, donde una etiqueta y su valor se sientan en la misma línea base y leer la fila de izquierda a derecha es exactamente lo que usted quiere. También es el modo a usar cuando la secuencia de dibujo no significa nada, por ejemplo texto pintado fuente por fuente o una página armada de muchos overlays pequeños
Para una colección mixta, reparta la elección por tipo de documento. Artículos, reportes y manuales de una herramienta de autor conocida van por roContentOrder; formularios y documentos transaccionales se quedan en el default roPhysicalLayout. La rutina siguiente imprime los bloques de una página en orden de contenido, con los encabezados marcados cuando el archivo está etiquetado
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // base 1
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // productores columna por columna

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
¿Cómo detecta usted una línea que corre a través del canal?
Una línea fusionada se delata por sus spans. GetStructuredText empieza un span nuevo cada vez que el siguiente carácter no es el sucesor directo del anterior en la secuencia de caracteres original de la página, además de los cambios de estilo cubiertos abajo. Dentro de una columna, las palabras consecutivas suelen ser consecutivas en la fuente. En el canal de una línea fusionada el índice de fuente salta por cientos de caracteres, y el hueco horizontal entre los dos spans es mucho más ancho que cualquier espacio de palabra
Esas dos señales juntas forman una prueba confiable, y usted puede correrla sobre la salida por defecto antes de decidir si una página necesita orden de contenido en su lugar. La instantánea de datos de carácter que GetStructuredText lee se guarda en caché por página, ocho páginas por defecto, así que pedir la misma página una segunda vez con un ReadingOrder distinto reagrupa datos ya en memoria en lugar de extraer la página otra vez
// LineCrossesGutter es un helper que usted agrega: marca una línea que sostiene dos
// spans vecinos que están lejos en la página y no son adyacentes en la
// secuencia de caracteres fuente
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // bloques de texto alternativo
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // un cuarto de las líneas cruzando un hueco se ve como columnas, no una fila de formulario
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Dieciocho puntos son un cuarto de pulgada, cómodamente más ancho que un espacio de palabra en texto corrido y más angosto que la mayoría de los canales. El umbral de uno de cada cuatro mantiene una factura con unas cuantas filas de etiqueta-y-monto en layout físico mientras que un cuerpo genuino de dos columnas, donde casi cada línea cruza, cambia de orden. Si el productor escribió la página fila por fila a través de ambas columnas, los índices de fuente se quedan contiguos, la prueba nunca se dispara, y ningún orden le separará las columnas; esa página necesita el modo de columnas de la API de contenido legible, descrito en leer dos columnas con un encabezado que las abarca
¿Qué cambia IncludeSemantics, y qué deja tranquilo?
IncludeSemantics etiqueta bloques; no los reordena. Con la opción encendida, GetStructuredText lee el contenido legible de la página y le da a cada bloque el tipo del fragmento con el que se superpone por el área mayor. Los tipos disponibles son cfParagraph, cfHeading con un HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther para cualquier otra etiqueta, y cfPlain cuando nada coincidió. Cada bloque también recoge un Language y un StructElementIndex que lo ata a un elemento del árbol de estructura
El campo Source dice de dónde vino la etiqueta: rosStructure cuando la página tiene un árbol de estructura utilizable en el sentido de ISO 32000-1 §14.7, rosHeuristic cuando los tipos se infirieron. Page.Source da la misma respuesta para la página como un todo. Un encabezado reportado con rosStructure es un encabezado porque el autor lo etiquetó; uno reportado con rosHeuristic es una conjetura educada, y un pipeline de indexación que pondera títulos debería tratarlos distinto. El orden de los bloques, en ambos casos, sigue viniendo de ReadingOrder. La pasada semántica usa los defaults de contenido legible, así que una configuración de columnas aplicada mediante ReadableContentOptions no llega a GetStructuredText
Las figuras reciben una regla extra. En una página etiquetada, un elemento Figure o texto alternativo que no se emparejó con ningún bloque de texto se anexa como bloque propio, sosteniendo la descripción alternativa como su texto. Semejante bloque tiene una sola línea y un solo span con SourceStartIndex en -1, porque ningún glifo de la página lo produjo. El código que mapea spans de vuelta a caracteres tiene que saltarse ese valor, que es por eso que la prueba del canal de arriba lo revisa. Las comprobaciones del árbol de estructura mismas están cubiertas en validación del árbol de estructura PDF/UA
Spans, límites y el camino de vuelta a los caracteres
Cada TPdfStructuredTextSpan carga su texto, sus límites, FontName, FontSize, FontWeight y Angle, más SourceStartIndex y SourceCharacterCount. Con IncludeFontInfo encendido, un span termina donde cualquiera de los cuatro valores de estilo cambie, así que una oración con tres palabras en negrita en medio llega como tres spans y el énfasis se puede reconstruir desde FontWeight en lugar de adivinarse por nombres de fuente. Con IncludeFontInfo apagado, los campos de estilo se quedan vacíos y los spans solo se parten donde la secuencia fuente se interrumpe
El ángulo importa en páginas con sellos. Una marca de agua diagonal de DRAFT vive en el mismo espacio de coordenadas que el texto del cuerpo, y en layout físico sus letras pueden aterrizar sobre líneas del cuerpo que cruzan verticalmente. Los spans con Angle distinto de cero son fáciles de descartar antes de unir texto para indexar
Los dos campos de fuente son lo que convierte un acierto de búsqueda en algo que usted puede dibujar. Indexan la secuencia de caracteres de la página, así que una frase encontrada en un bloque se convierte directo en cajas de carácter para un resaltado, usando el enfoque de selección visual de líneas de texto con cajas de carácter. Cuando la forma refluida o HTML de la página es el objetivo, los mismos bloques alimentan el modelo de reflow y su exportación HTML
Un presupuesto de caracteres y dos contadores de calidad
MaxCharacters rechaza una página de plano cuando sostiene más caracteres de los permitidos. GetStructuredText revisa el conteo antes de asignar cualquier arreglo de trabajo, y una página sobredimensionada lanza EPdfError con el mensaje Structured text character budget exceeded; nunca se devuelve una página parcial. El valor debe ser positivo. La instantánea de caracteres por página que el método lee tiene su propio techo por defecto de 1,000,000 caracteres y 100,000 objetos de texto, reportado como Text snapshot budget exceeded, así que poner MaxCharacters por encima del millón no deja pasar una página mayor
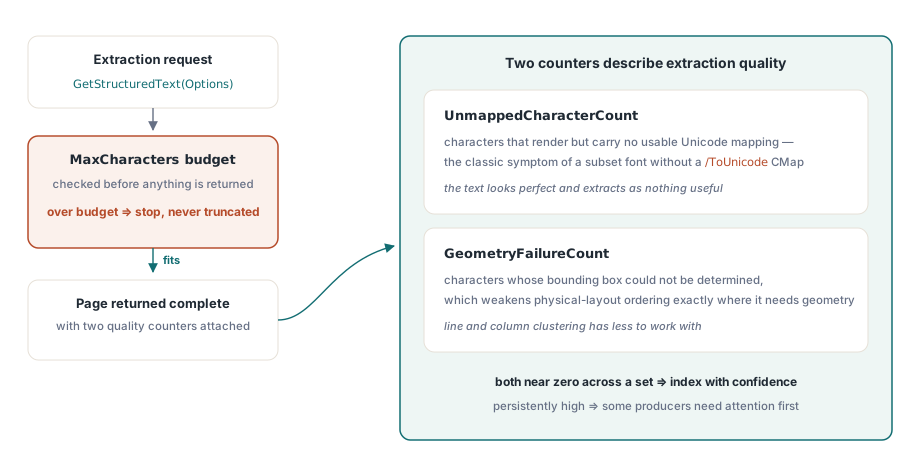
UnmappedCharacterCount cuenta los caracteres para los que PDFium no pudo producir valor Unicode alguno. Esos caracteres aparecen como U+FFFD en cada campo Text. La causa usual es una fuente subset con codificación personalizada y sin CMap /ToUnicode, el caso que ISO 32000-1 §9.10.2 describe, donde el texto se renderiza correctamente y no se puede extraer de forma confiable. El contador mide solo mapeos faltantes: un glifo cuya entrada /ToUnicode nombra el punto de código equivocado cuenta como mapeado, así que una página de basura de aspecto plausible igual puede reportar cero
GeometryFailureCount cuenta los caracteres sin caja utilizable, excluidos los saltos de línea. En orden de contenido esos caracteres simplemente siguen a sus vecinos. En layout físico no tienen posición por la que ordenarse, así que se colocan después de cada carácter posicionado y terminan pegados a la última línea de la página. Una página con conteo de geometría distinto de cero y fragmentos raros en su última línea está mostrando exactamente eso
// LogRejected y LogQuality son sus propias rutinas de registro
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // límite de ingesta para este pipeline
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // presupuesto de caracteres o de instantánea
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Para una página que usted solo necesita como string, extraer texto de documentos PDF cubre las llamadas más simples, y leer y escribir contenido marcado BDC y MCID baja una capa por debajo del árbol de estructura. El modelo de página estructurada, el lector de contenido legible y la exportación de reflow se envían todos en el componente Delphi y Lazarus descrito en la página del producto PDFium Component