Un PDF cortado a media descarga puede negarse a abrir incluso cuando casi todas las páginas llegaron, mientras que un manual de 2000 páginas salta a la página 1500 al instante. Ambos casos se siguen de la estructura de archivos PDF, tal como la escribe HotPDF Delphi Component: un encabezado, un cuerpo de objetos numerados, una tabla de referencias cruzadas (xref) de offsets de bytes, y un tráiler, los dos últimos guardados al final
ISO 32000-2 §7.5.1 describe la misma anatomía de cuatro partes para cada PDF, desde un recibo de una página hasta un archivo escaneado. Las partes siempre se sientan en el mismo orden a lo largo del archivo, y se conectan en una cadena fija: el tráiler nombra el catálogo y dice dónde empieza la tabla de referencias cruzadas, la tabla dice dónde empieza cada objeto, y los objetos se apuntan entre sí por número. Los extractos de abajo vienen de un archivo Hello World de 610 bytes cuyos offsets se comprobaron byte por byte; el archivo completo, anotado palabra clave por palabra clave, está en cómo se ve un PDF por dentro, y lo que un visor hace con estas partes en el camino hacia píxeles está en cómo funciona un PDF cuando un lector lo abre
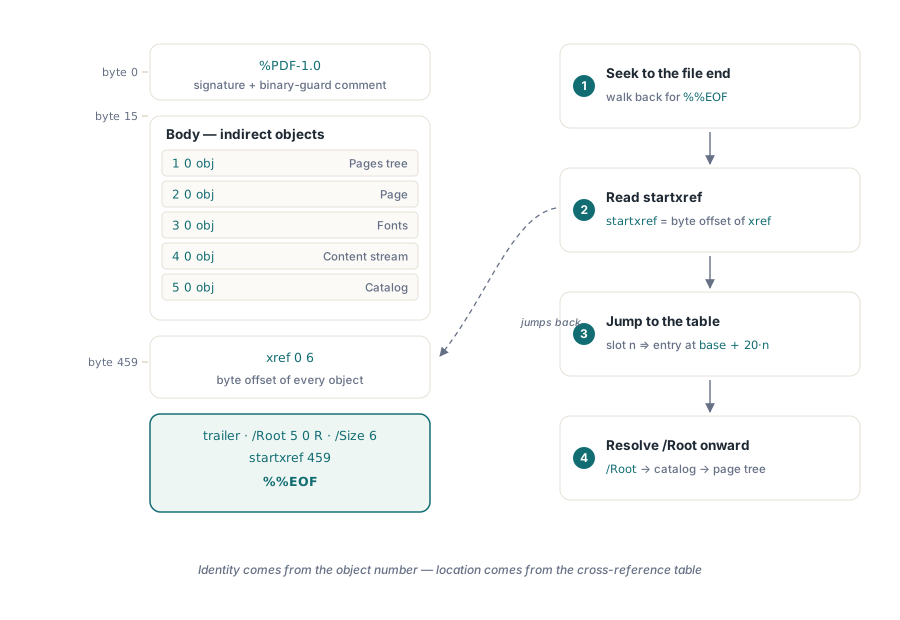
El encabezado son dos líneas, y la segunda importa
La primera línea, como %PDF-1.7, es un comentario en lo que respecta a la sintaxis, pero los lectores la tratan como la firma del archivo y de ahí sacan la versión; el manejo de versiones es flexible en la práctica, así que tome el número como una pista de qué características esperar. La segunda línea es la que la gente borra por accidente y luego pasa una tarde depurando. Su carga es de al menos cuatro bytes por encima del ASCII 127 (ISO 32000-1 §7.5.2), ahí para que cualquier cosa que mueva el archivo en modo texto lo reconozca como binario y deje de reescribir finales de línea. Los streams comprimidos contienen bytes que por coincidencia coinciden con un retorno de carro o un salto de línea; reescríbalos y la longitud del stream registrada en el diccionario ya no coincide con los bytes en disco. Todo writer serio todavía emite el comentario porque el fallo que previene es silencioso y total
El cuerpo: objetos numerados y los ocho tipos de objetos PDF
El cuerpo es una secuencia plana de objetos indirectos, cada uno envuelto como N G obj ... endobj con un número de objeto y un número de generación. Lo que convierte esa lista plana en la estructura interna de PDF es el token de referencia N G R: 2 0 R significa "objeto 2, generación 0, dondequiera que viva en el archivo". Cualquier valor también puede escribirse en el lugar como objeto directo. En el extracto, el diccionario /Resources de la página es directo, mientras que la fuente que nombra es indirecta, así que cien páginas podrían compartir el objeto 4 en lugar de cargar cien copias:
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>          % el catálogo apunta al árbol de páginas
endobj
...
3 0 obj
<< /Type /Page
   /Parent 2 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 4 0 R >> >>   % diccionario directo, fuente indirecta
   /Contents 5 0 R
>>
endobj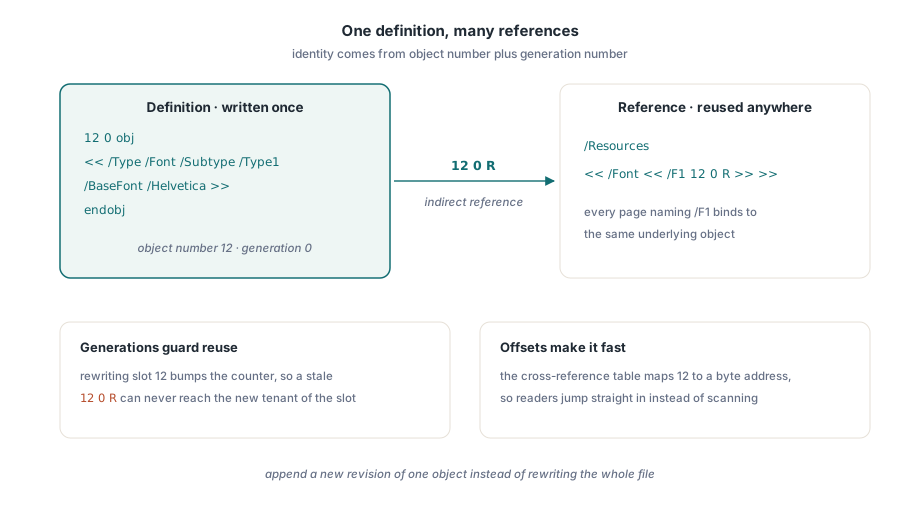
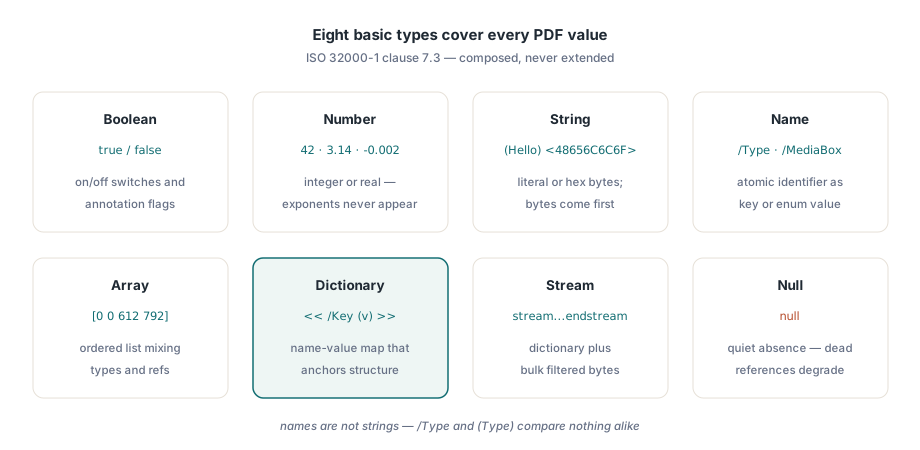
ISO 32000-1 §7.3 mantiene el vocabulario corto: cada valor en un PDF es uno de ocho tipos básicos. Los booleanos y los números son los escalares, y PDF no tiene notación de exponente, así que 1e6 nunca aparece en un archivo conforme. Las cadenas guardan bytes, escritas como (Hello, World!) o en hex como <48656C6C6F>. Los nombres como /Type o /Helvetica se comparan byte por byte, así que escribir (Helvetica) donde /BaseFont espera un nombre es un error de tipo aunque los caracteres coincidan. Los arreglos guardan cualquier cosa en orden, como el MediaBox. Los diccionarios mapean nombres a valores y cargan la mayor parte de la estructura. Un stream es un diccionario más bytes crudos, hogar del contenido de página, las fuentes y las imágenes. El octavo tipo es null, y una referencia a un objeto que no existe se resuelve a él en lugar de lanzar un error, lo que deja que un archivo dañado se degrade en vez de fallar por completo
El número de generación existe para la reutilización. Cuando una edición borra un objeto, su número va a la lista libre, y si una edición posterior reutiliza el número, la generación sube en uno, así que un 12 0 R vencido no puede resolverse en silencio al nuevo 12 1 obj. Casi todos los objetos que se encuentra son generación 0. La resolución arranca en el catálogo, el objeto 1 del extracto, cuya entrada /Pages lleva al árbol de páginas; los nodos interiores coleccionan páginas en /Kids, mantienen un /Count, y pueden pasar atributos como /MediaBox hacia abajo a sus descendientes. Por qué ese árbol, y no el orden físico de los objetos, decide el orden de páginas está cubierto en árboles de páginas PDF y orden de páginas
¿Cómo localiza un objeto la tabla de referencias cruzadas?
La tabla de referencias cruzadas convierte un número de objeto en un offset de bytes por aritmética, que es cómo un manual de 2000 páginas abre en la página 1500 sin parsear las páginas anteriores. ISO 32000-1 §7.5.4 fija cada entrada en exactamente veinte bytes: un offset de diez dígitos contado desde el inicio del archivo, un espacio, una generación de cinco dígitos, un espacio, una letra de tipo, y un fin de línea de dos bytes, que con LF es un espacio más el salto de línea. Como las filas son uniformes, un lector indexa directo a la fila del objeto n. La línea 0 6 es un encabezado de subsección, y la entrada 0 siempre es libre con generación 65535, encabezando la lista enlazada de números de objeto libres. Todos los demás offsets deben caer en el primer dígito del encabezado N G obj correspondiente, como en el archivo de 610 bytes:
xref
0 6                  % 6 entradas, empezando en el objeto 0
0000000000 65535 f   % entrada 0: cabeza de la lista libre
0000000019 00000 n   % el objeto 1 (catálogo) empieza en el byte 19
0000000068 00000 n   % el objeto 2 (árbol de páginas) empieza en el byte 68
0000000125 00000 n   % el objeto 3 (página) empieza en el byte 125
0000000263 00000 n   % el objeto 4 (fuente) empieza en el byte 263
0000000333 00000 n   % el objeto 5 (stream de contenido) empieza en el byte 333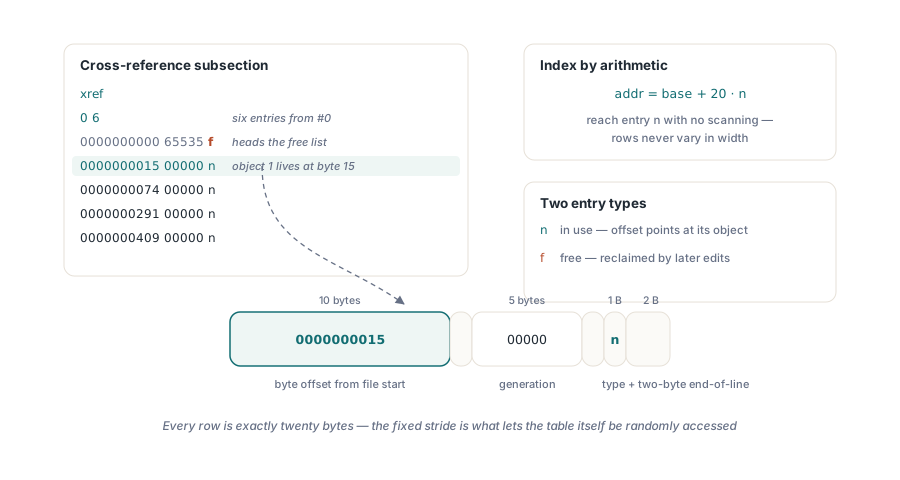
¿Por qué un PDF truncado falla al abrir?
Un PDF truncado falla porque las dos partes que atan todo, la tabla de referencias cruzadas y el tráiler, son los últimos bytes escritos. El diccionario tráiler lleva /Root, el catálogo, y /Size, el número de entradas de la xref, uno más que el número de objeto más alto porque el slot cero guarda la entrada libre. Debajo, startxref da el offset de bytes de la palabra clave xref y %%EOF cierra el archivo:
trailer
<< /Size 6 /Root 1 0 R >>   % conteo de entradas, catálogo del documento
startxref
427                          % offset de bytes de la palabra clave xref
%%EOF
Pierda los últimos pocos cientos de bytes y el archivo tiene objetos pero no mapa hacia ellos. Los lectores estrictos se detienen ahí; los tolerantes escanean el archivo completo buscando encabezados N G obj y reconstruyen la tabla, la ruta lenta que la xref existe para evitar, y un mapa reconstruido todavía puede perder objetos o tomar la copia equivocada de uno editado. Una transferencia en modo texto hace un daño más silencioso, porque reescribir finales de línea desplaza cada objeto. Nosotros convertimos el archivo de 610 bytes a finales CRLF y corrimos qpdf --check (qpdf 12.3.2): reportó "file is damaged" y "xref not found" en el offset 427, y reconstruyó la tabla escaneando antes de revisar nada
¿Tabla de referencias cruzadas clásica o stream de referencias cruzadas?
Desde PDF 1.5, la xref puede ser también un stream de referencias cruzadas (ISO 32000-1 §7.5.8): un objeto indirecto de /Type /XRef cuyas filas binarias reemplazan la tabla de texto y cuyo diccionario de stream absorbe las entradas del tráiler, así que la palabra clave trailer desaparece y startxref apunta a ese objeto. Los tipos de fila se vuelven números (0 libre, 1 en un offset de bytes, 2 dentro de un object stream), /W da el ancho en bytes de cada columna, y HotPDF comprime las filas con Flate y el predictor PNG Up. HotPDF escribe la forma de stream cuando Version es pdf15 o posterior, así que el ejemplo lo fija explícitamente, y UseObjectStreams se construye sobre el mismo switch. Dejamos UseXRefStream apagado para archivos que deben abrir en herramientas de la era PDF 1.4, que no pueden parsear un stream de xref para nada, y lo activamos para documentos grandes donde un índice compacto rinde. Solo la cola del archivo cambia:
uses
  System.SysUtils, HPDFDoc;

procedure SaveWithXRef(const FileName: string; AsStream: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.FileName := FileName;
    PDF.Version := pdf17;            // los streams de xref necesitan PDF 1.5 o posterior
    PDF.UseXRefStream := AsStream;   // False por defecto: tabla de texto más tráiler
    PDF.BeginDoc;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Same page, different index');
    PDF.EndDoc;
  finally
    PDF.Free;
  end;
end;

// SaveWithXRef('table.pdf', False);
//   Cola esperada: xref, 0 N, filas de veinte bytes,
//   trailer << /Size /Root /Info /ID >>, startxref, %%EOF
// SaveWithXRef('stream.pdf', True);
//   Cola esperada: N 0 obj << /Type /XRef /Size /Root /Info /ID /W ...
//   /Filter /FlateDecode >> stream ... endstream endobj, startxref, %%EOF
Las actualizaciones incrementales agregan una segunda xref en lugar de reescribir
Un PDF puede editarse sin tocar ningún byte que ya esté en disco. Los objetos cambiados y nuevos se agregan al final, seguidos por una sección de xref que lista solo esos y un tráiler cuya entrada /Prev guarda el offset de la tabla anterior. Un lector sigue startxref a la sección más nueva, recorre la cadena /Prev hacia atrás, y deja que la entrada más nueva de cada número de objeto gane. La edición de abajo agrega una anotación de nota al archivo de 610 bytes: el objeto de página 3 se reescribe con un arreglo /Annots bajo el mismo número, y el objeto 6 es nuevo. Sin los comentarios y con finales LF los offsets son exactos, y qpdf --check pasó sobre el resultado sin errores:
% ... los 610 bytes originales, sin cambios ...
3 0 obj                          % reemplaza la página 3, mismo número de objeto
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Resources << /Font << /F1 4 0 R >> >> /Contents 5 0 R /Annots [6 0 R] >>
endobj
6 0 obj                          % la nueva anotación
<< /Type /Annot /Subtype /Text /Rect [72 650 92 670] /Contents (Checked) >>
endobj
xref                             % dos subsecciones de una entrada
3 1
0000000610 00000 n
6 1
0000000752 00000 n
trailer
<< /Size 7 /Root 1 0 R /Prev 427 >>
startxref
843
%%EOF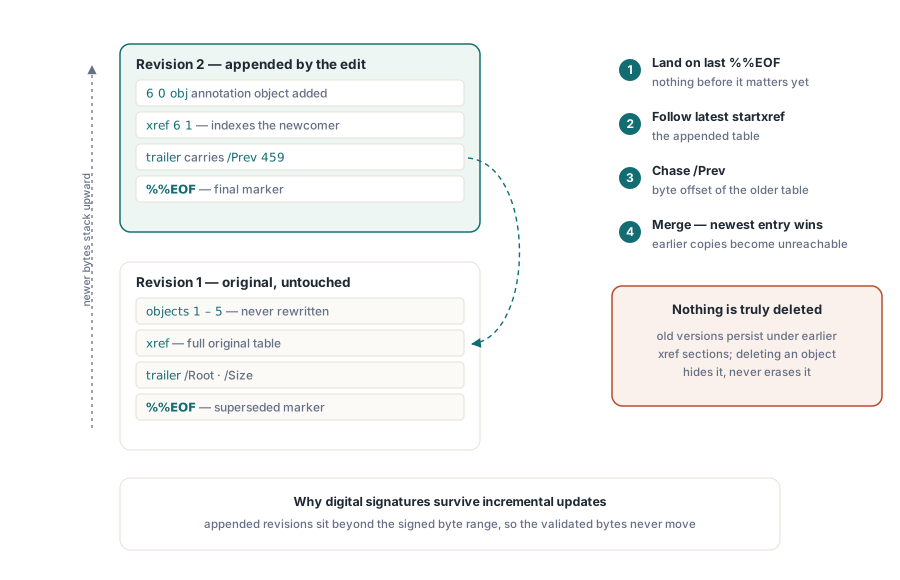
Agregar al final es lo que mantiene verificables los PDFs firmados: una firma cubre un rango de bytes, y una actualización incremental nunca mueve esos bytes. También es por eso que un PDF carga historia recuperable, ya que la vieja página 3 sigue sentada en el byte 125, inalcanzable pero presente. Los archivos revisados muchas veces crecen una cadena /Prev larga; qpdf revised.pdf flat.pdf re-serializa los objetos alcanzables bajo una sola xref y suelta las revisiones viejas, lo que en el archivo de arriba dejó una tabla de referencias cruzadas y ningún /Prev, al precio de cualquier firma sobre los bytes originales. En HotPDF, una revisión incremental se ve así:
procedure ReviseInPlace(const Original, Revised: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.BeginIncrementalUpdate(Original);   // mantiene los bytes originales al pie de la letra
    PDF.SetLoadedTitle('Quarterly report, revised');
    PDF.SetLoadedAuthor('Finance');
    PDF.SaveIncrementalUpdate(Revised);      // objetos cambiados, nueva xref, tráiler con /Prev
  finally
    PDF.Free;
  end;
end;
La composición de cuatro partes también da un orden de triage rápido para un PDF que se porta mal: revise que el archivo termine en %%EOF con un startxref plausible, confirme que uno o dos offsets de xref caen en un encabezado N G obj, luego siga /Root hacia el catálogo y el árbol de páginas. El HotPDF Delphi Component para Delphi y C++Builder escribe tablas de referencias cruzadas clásicas o streams de referencias cruzadas a pedido, y agrega revisiones incrementales que dejan intactos los bytes anteriores, y las firmas sobre ellos