Abra el mismo PDF de factura en Windows y en un teléfono, y los saltos de línea, las fuentes y el logo caen en lugares idénticos. Un archivo PDF es un conjunto de objetos numerados más un índice de offsets de bytes, y un lector como el motor PDFium dentro de PDFium Component lo abre desde el final: startxref, tabla de referencias cruzadas, catálogo, árbol de páginas, content streams, luego píxeles
Entonces, ¿qué es un archivo PDF, y por qué se ve igual en todas partes? Los documentos Word y RTF guardan texto y estilos y dejan el layout a la máquina que los abra, así que una fuente ausente o un driver de impresora distinto recompone las páginas. PDF guarda en cambio el resultado terminado. Cada glifo y cada línea tiene una posición absoluta en un espacio de coordenadas medido en puntos, los programas de fuente viajan dentro del archivo, y las imágenes cargan sus propios datos de color y filtros de compresión. Nada se compone al momento de visualizar, que es por lo que cualquier renderizador conforme en cualquier sistema operativo pinta la misma página. El formato empezó como PDF 1.0 con Acrobat en 1993, construido sobre el modelo de imagen PostScript, y cada revisión agregó parte de la maquinaria descrita abajo:
- PDF 1.1 a 1.4 trajo cifrado, formularios interactivos, firmas digitales con estructura lógica y transparencia
- PDF 1.5 agregó object streams y streams de referencias cruzadas; PDF 1.6 agregó cifrado AES
- PDF 1.7 se volvió ISO 32000-1:2008, y PDF 2.0 se volvió ISO 32000-2:2017, revisada en 2020
- PDF/A (ISO 19005), PDF/X (ISO 15930) y PDF/UA (ISO 14289) restringen esa base para archivado, producción de impresión y accesibilidad
¿Qué pasa cuando un lector abre un archivo PDF?
Abrir un PDF es una cadena de búsquedas que arranca en los últimos bytes del archivo y termina en un bitmap. Casi cada eslabón de esa cadena es un diccionario, uno de los tipos básicos de objeto en ISO 32000-1 §7.3, y los diccionarios se apuntan entre sí con referencias indirectas como 7 0 R (objeto 7, generación 0). El archivo por tanto se comporta como un grafo de objetos en lugar de una secuencia de páginas. El encabezado, el cuerpo, la tabla de referencias cruzadas y el trailer se presentan en la visión general de la estructura de archivos PDF, y un PDF mínimo anotado línea por línea muestra cómo se ven obj, endobj y stream en un editor de texto. Este es el orden que todo lector sigue
- Salte al final del archivo y lea el offset de bytes escrito después de la palabra clave
startxref - Cargue los datos de referencias cruzadas en ese offset, que mapean cada número de objeto a una posición en el archivo
- Lea el trailer y siga
/Roothasta el catálogo del documento - Siga la entrada
/Pagesdel catálogo bajando por el árbol de páginas hasta el objeto de página solicitado - Decodifique el content stream de la página e interprete sus operadores en orden
- Resuelva las fuentes, las imágenes y los form XObjects que esos operadores nombran a través de
/Resources - Rasterice rutas, contornos de glifos e imágenes en píxeles a la resolución del dispositivo
Paso uno: startxref y la tabla de referencias cruzadas
Un lector nunca escanea un PDF desde el inicio. Un archivo bien formado termina con la palabra clave startxref, un número decimal como 48211, y %%EOF, y ese número es el offset de bytes de los datos de referencias cruzadas. Una búsqueda hacia atrás ingenua de xref se detiene dentro de startxref, así que busque la palabra clave completa. La tabla clásica usa entradas de ancho fijo (§7.5.4), lo que le permite a un lector saltar a la entrada de cualquier número de objeto sin parsear las demás; la disposición en bytes de cada entrada está cubierta en la visión general de la estructura. El trailer después de la tabla nombra /Size, /Root, y opcionalmente /Encrypt, /ID y /Prev
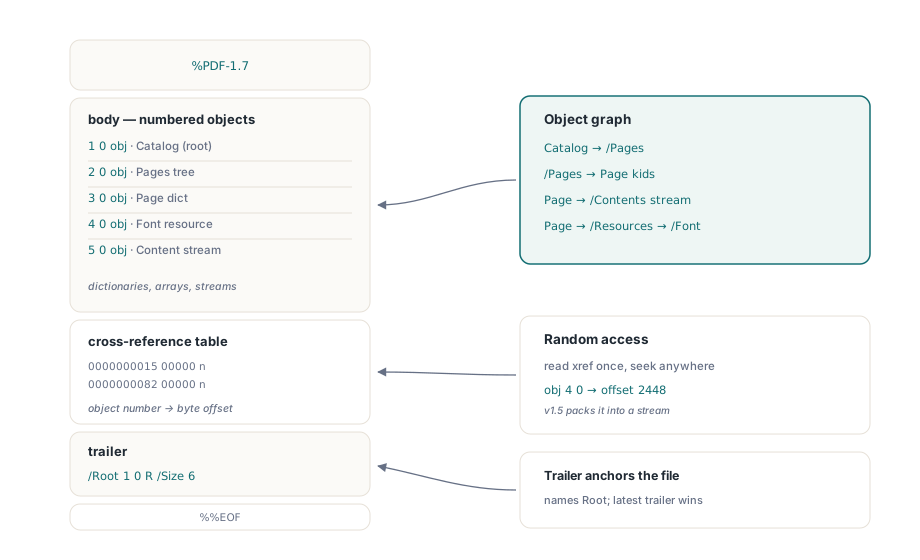
Cada entrada es una posición absoluta de bytes, así que cualquier cosa que desplace bytes, como un editor que reescribe finales de línea, deja el índice apuntando a lugares equivocados. Los lectores con una pasada de reparación lo reconstruyen escaneando palabras clave obj; los lectores sin ella rechazan el archivo, razón por la cual un PDF dañado puede abrir en un visor y fallar en otro. Lo que se sienta en el offset de startxref le dice en qué caso está: la palabra clave xref para una tabla clásica, un encabezado N 0 obj para un stream de referencias cruzadas de PDF 1.5, y cualquier otra cosa para un offset vencido. El helper de abajo es código suyo, construido sobre streams RTL simples
uses
  System.SysUtils, System.Classes;

// Su propio helper: Offset es el número escrito después de startxref.
// Clasifica lo que el lector encontrará en esa posición
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
Un stream de referencias cruzadas (§7.5.8) es un objeto comprimido con /Type /XRef, un array /W que da el ancho en bytes de cada columna, y filas binarias que apuntan ya sea a un offset de bytes o dentro de un object stream (§7.5.7). Las claves del trailer se mudan a su diccionario, así que el archivo no tiene palabra clave trailer para nada. HotPDF escribe esta forma cuando UseXRefStream está puesto en THotPDF. Para archivos que salen de su control, como adjuntos de correo o subidas a una imprenta, la tabla clásica sigue siendo la elección más segura porque los lectores anteriores a PDF 1.5 todavía la parsean. PDF/A-1 resuelve la pregunta para el archivado: ISO 19005-1 se construye sobre PDF 1.4, y su §6.1.4 establece que los streams de referencias cruzadas no se deben usar, así que HotPDF escribe una tabla clásica siempre que un perfil PDF/A-1 esté activo
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
De /Root a la página correcta: catálogo y árbol de páginas
El /Root del trailer apunta al catálogo del documento, y el /Pages del catálogo apunta a la raíz del árbol de páginas. Cada nodo /Pages intermedio lleva un /Count de las páginas hoja debajo de él, así que un lector que busca la página 5000 va restando conteos mientras desciende y se salta subárboles enteros sin abrirlos. ISO 32000-1 §7.7.3 no exige un árbol balanceado; un solo array /Kids con 10000 entradas es legal, solo más lento de buscar. El código que lee solo la hoja cae en una trampa. /Resources, /MediaBox, /CropBox y /Rotate son heredables (§7.7.3.4), así que una página sin /MediaBox propio sigue siendo válida porque el valor vive en un ancestro
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
El media box fija el espacio de coordenadas para todo lo dibujado en la página: origen en la esquina inferior izquierda, Y corriendo hacia arriba, una unidad igual a 1/72 de pulgada a menos que un /UserUnit de PDF 1.6 lo escale. PDFium Component hace toda la descida cuando usted pide una página por número. TPdf.PageMetrics devuelve el tamaño de página en puntos con las cajas heredadas ya resueltas, más la rotación de la página, así que el listado de abajo reporta tamaños correctos incluso para archivos cuyas páginas hoja no cargan caja propia
uses
  System.SysUtils, PDFium;

// Imprime el conteo de páginas y el tamaño de cada página en puntos
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // parsea los datos de xref, el trailer y el catálogo
    if not Pdf.Active then        // una carga fallida deja Active = False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // base 1; carga la página a través del árbol
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
¿Cómo dibuja un PDF una página en pantalla?
El contenido visible de una página es un pequeño programa: operadores postfix en uno o más content streams, interpretados en orden después de que el lector corre el decodificador nombrado en /Filter, casi siempre /FlateDecode. BT abre un objeto de texto, Tf selecciona un recurso de fuente y tamaño, Td mueve la posición del texto, Tj pinta una cadena, y ET cierra el objeto. Las rutas se construyen con m, l, c y re, y luego se rellenan con f o se trazan con S. El estado de gráficos (§8.4) guarda lo que esos operadores leen implícitamente, como la matriz de transformación, los colores y la ruta de recorte. q empuja una copia y Q la saca, así que una transformación puesta dentro del par no puede filtrarse al contenido posterior
q
1 0 0 1 72 700 cm     % mueve el origen a (72, 700)
BT
  /F1 12 Tf           % recurso de fuente F1 a 12 puntos
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % color de trazo, acotado por q/Q
0 -6 m 140 -6 l S
Q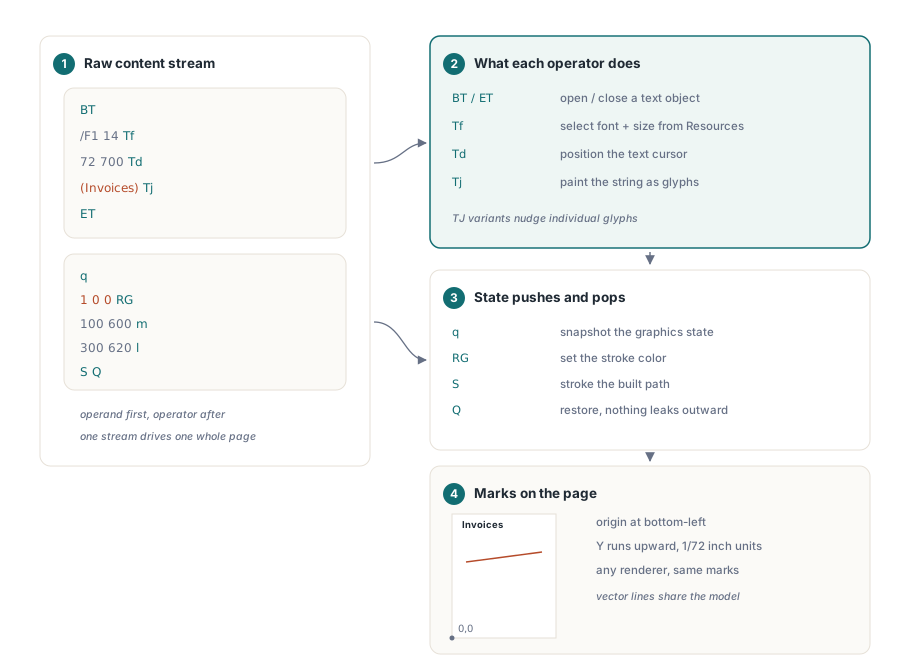
Nombres como /F1 son claves en el /Resources de la página. Un diccionario de fuente lleva a través de su font descriptor (§9.8) al programa de fuente incrustado, y una imagen se pinta con un solo Do una vez que sus datos JPEG o Flate se decodifican. La rasterización viene al final. El renderizador aplica la matriz de transformación a cada ruta y contorno de glifo, mapea puntos a píxeles del dispositivo, y rellena el resultado con anti-aliasing. Como la página sigue siendo datos vectoriales en ese punto, hacer zoom a 400 por ciento vuelve a correr el content stream a una escala mayor en lugar de estirar un bitmap. La resolución objetivo la elige quien llama: 96 o 150 píxeles por pulgada para pantalla, 300 o más para impresión. En PDFium Component esa etapa es TPdf.RenderPage, que toma el tamaño de salida en píxeles
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// Renderiza la página 1 de FileName a Dpi píxeles por pulgada y la guarda como BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // base 1
    // PageWidth y PageHeight están en puntos (1/72 de pulgada)
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // la forma función devuelve un bitmap nuevo
    end;
  finally
    Pdf.Free;
  end;
end;
¿Por qué copiar y pegar devuelve basura cuando la página se ve bien?
Copiar y pegar falla cuando el archivo registra qué glifo dibujar pero no qué carácter representa. Renderizar necesita solo las formas de glifo del programa de fuente incrustado. Extraer necesita Unicode, que viene de una codificación estándar o de un CMap /ToUnicode en el diccionario de fuente (§9.10.3). Una fuente compuesta con /Encoding /Identity-H escribe IDs de glifo crudos en el content stream, y sin un mapa ToUnicode esos IDs no tienen relación definida con ningún carácter. La pantalla se ve perfecta mientras el portapapeles se llena de símbolos. Las fuentes subset hacen esto más probable, ya que guardan solo los glifos que el documento usa y son fáciles de detectar por el prefijo de seis letras en nombres como /BaseFont /AAAAAA+ArialMT (§9.6.4). La guía de manejo de fuentes PDF cubre fuentes CJK y extracción rota en profundidad
Actualizaciones incrementales y el rango de bytes de la firma
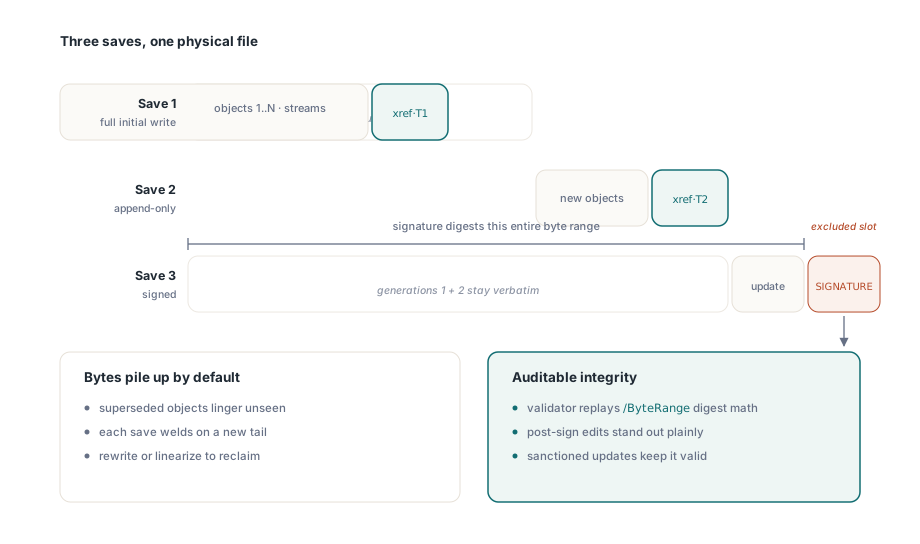
Las firmas dependen de la forma de solo-agregar en que se editan los PDFs: una actualización incremental (§7.5.6) agrega objetos y una nueva sección de referencias cruzadas después del último %%EOF, y la visión general de la estructura explica la cadena /Prev y por qué el contenido borrado sobrevive en revisiones anteriores. El /ByteRange de un diccionario de firma, escrito como [0 a b c], hashea todo excepto la cadena hex /Contents que contiene la firma CMS, así que la revisión firmada termina en el byte b + c y un validador la reconstruye truncando el archivo ahí. Las revisiones posteriores caen después de ese punto, mientras que una reescritura completa, un linearizador o una pasada de optimización mueve bytes que el firmante hasheó e invalida todas las firmas existentes de golpe
Cuando una aplicación Delphi o Lazarus necesita todo este pipeline, desde parsear los datos de referencias cruzadas y recorrer el árbol de páginas hasta renderizar y extraer texto, el PDFium Component para Delphi y Lazarus lo envuelve en el componente de documento TPdf usado en los listados de arriba y el control visor TPdfView para presentación en pantalla