El objeto número 1 no es la página 1. Ese solo hecho hace tropezar más código de procesamiento de PDF que cualquier otra parte del formato, y la razón solo aparece cuando usted deja de mirar lo que un visor renderiza y empieza a mirar el grafo de objetos que el visor realmente lee
Un archivo PDF es una colección de objetos indirectos numerados. Cada uno lleva un número de objeto y un número de generación, y otros objetos le apuntan con una referencia escrita como N G R — 3 0 R significa la versión actual del objeto 3. Las páginas son objetos como cualquier otro, pero dónde se sientan en el archivo y qué números cargan no dicen nada sobre el orden de visualización. El orden viene del árbol /Pages. Si escanea los objetos numéricamente, ensamblará las páginas en la secuencia equivocada para una porción considerable de los archivos reales
El árbol también es donde vive un montón de comportamiento menos obvio. Su forma decide qué tan rápido un visor puede saltar a la página 8,214, sus nodos interiores le pasan silenciosamente el tamaño de página y las fuentes a las hojas debajo de ellos, y los totales de /Count que vuelven rápida toda la estructura no los impone nadie. Vamos por los tres, empezando por el orden mismo
El árbol de páginas decide el orden
Todo PDF tiene un catálogo de documento (ISO 32000-2 §7.7.2), y la entrada /Pages del catálogo apunta al nodo raíz del árbol de páginas. Esa raíz es un diccionario con /Type /Pages, un arreglo /Kids de referencias indirectas, y un /Count que da el número de páginas hoja debajo de él. El orden de visualización es un recorrido en profundidad, de izquierda a derecha, de ese árbol. Esa es toda la regla
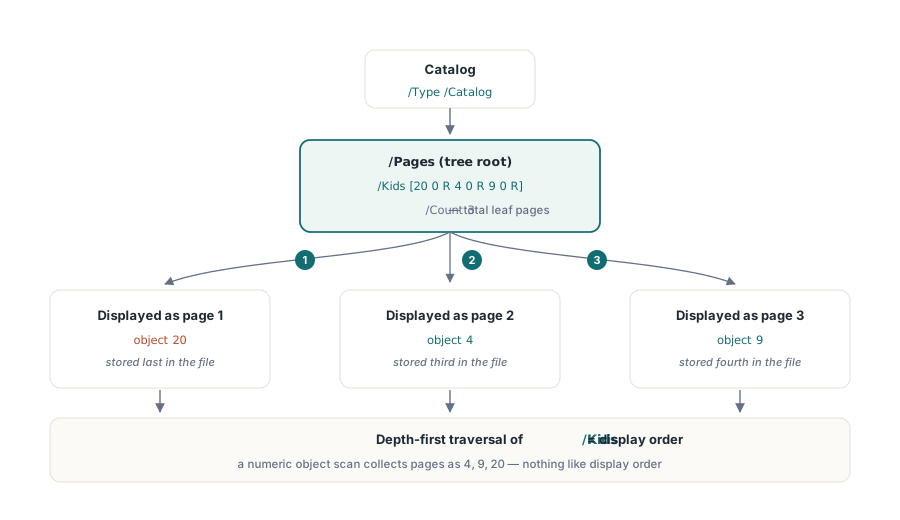
Un archivo mínimo de tres páginas lo hace concreto:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% El objeto 4 se guarda tercero en el archivo pero es la página 2 en orden de visualización
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% El objeto 9 se guarda cuarto pero es la página 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% El objeto 20 se guarda al final pero es la página 1; Kids[0] decide, no el número de objeto
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
El arreglo /Kids lee [20 0 R 4 0 R 9 0 R], así que el objeto 20 es la página 1, el objeto 4 es la página 2 y el objeto 9 es la página 3. El código que itera los objetos en orden numérico y recolecta todo lo que tiene /Type /Page se equivoca con este archivo. Peor aún, la salida sigue viéndose plausible: número de páginas correcto, contenido reconocible en cada página, secuencia equivocada
Los generadores producen distribuciones así por razones ordinarias. Una librería que reserva los números de objeto de todas las páginas por adelantado los numera en orden de creación, y luego escribe los bytes en el orden que le convenga a su serializador. Una herramienta de fusión renumera los objetos de cada documento fuente para evitar colisiones, así que los objetos de página terminan dispersos por la tabla de objetos combinada mientras el nuevo arreglo /Kids raíz guarda la secuencia correcta. Y las actualizaciones incrementales agregan objetos nuevos al final del archivo con números frescos, así que una página añadida en una revisión vive cerca del final del stream de bytes incluso cuando pertenece a la posición 1
Ese último caso es el que muerde. Un corpus de pruebas producido por una sola herramienta puede pasar completamente, y luego los archivos de un flujo de trabajo de fusión, o los documentos que pasaron por unas cuantas revisiones, salen barajados. Los arreglos heurísticos no se sostienen, porque el fallo depende del generador y del historial de ediciones del archivo. El arreglo real es corto: empiece en el catálogo, resuelva /Pages, recorra /Kids recursivamente y emita las hojas en el orden en que las encuentra. Nuestro caso de estudio de depuración del orden de páginas sigue exactamente este síntoma desde un diagnóstico equivocado hasta su causa raíz, con el código de recorrido recursivo y los pasos de qpdf para verificar el resultado
El fan-out es una decisión de rendimiento
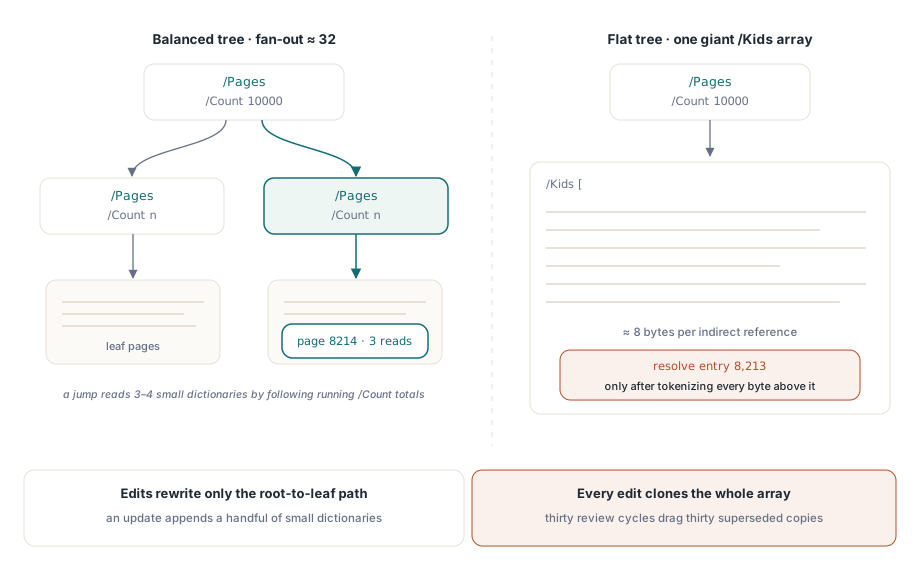
La especificación permite dos formas. Los generadores simples emiten un árbol plano, un nodo /Pages raíz cuyo /Kids no contiene nada más que hojas /Page. Nada obliga a un escritor a anidar, y un documento de 10,000 páginas con 10,000 referencias hoja en un solo arreglo cumple. Sin embargo, el PDF Reference recomienda un árbol equilibrado para documentos grandes, y los generadores principales siguen ese consejo con un fan-out modesto — típicamente unas pocas decenas de hijos por nodo intermedio, donde cada nodo intermedio tiene su propio /Kids y su propio /Count
La razón es lo que un visor tiene que leer antes de poder mostrar algo. Tome un salto directo a la página 8,214 de ese archivo de 10,000 páginas. Con un árbol plano el visor tiene que parsear primero la raíz, y la raíz es un solo arreglo enorme: a unos ocho bytes por referencia indirecta, un objeto de 80 KB que debe tokenizarse de punta a punta antes de que la entrada 8,213 se resuelva. Con un árbol equilibrado de fan-out 32, el mismo salto lee la raíz, compara los totales acumulados de /Count para elegir el hijo correcto, y desciende. Tres o cuatro diccionarios pequeños, de unos cuantos cientos de bytes cada uno. Ese acceso aleatorio O(log n) es lo que el árbol fue diseñado para proveer, y es la razón completa de que /Count exista en los nodos interiores — un lector puede saltarse un subárbol entero sin abrir un solo objeto dentro de él
La forma del árbol también fija el costo de editar. Una actualización incremental que inserta una página debe reescribir cada nodo cuyo /Kids o /Count cambió, es decir, la ruta desde el padre de la hoja nueva hasta la raíz. En un árbol equilibrado esa ruta es un puñado de diccionarios pequeños agregados al archivo. En un árbol plano la "ruta" es el arreglo raíz gigante, duplicado por completo en cada revisión. Un contrato que pasa por treinta ciclos de revisión y anotación puede terminar arrastrando treinta copias superadas del mismo arreglo de 80 KB en su stream de bytes
Para el código de procesamiento, el anidamiento tiene una consecuencia más contundente. No puede asumir que el primer nivel de /Kids contiene páginas, así que cada hijo tiene que revisarse: /Type /Pages significa recurrir, /Type /Page significa hoja. El código que se detiene en el primer nivel funciona con cada archivo plano que encuentra, y luego suelta subárboles enteros en silencio la primera vez que un generador decide anidar
Los nodos interiores llevan atributos heredados
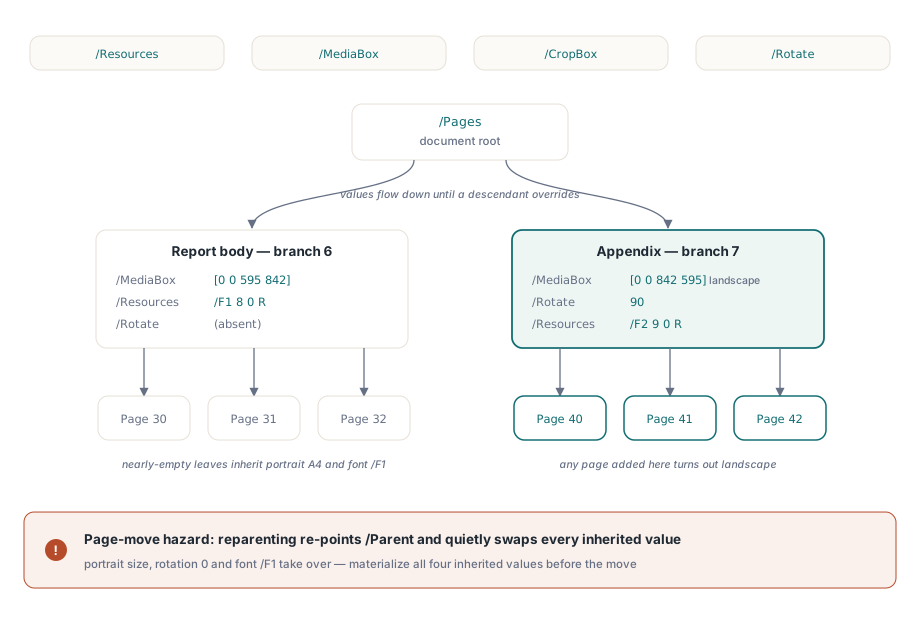
Los nodos intermedios hacen más que enrutar búsquedas. Cuatro atributos de página son heredables (ISO 32000-2 §7.7.3.4): /Resources, /MediaBox, /CropBox y /Rotate. Cualquiera de ellos puede sentarse en un nodo /Pages, donde aplica a cada hoja debajo a menos que un descendiente lo anule. Un escritor que produce un reporte con un apéndice apaisado puede expresar ese layout en el árbol mismo:
5 0 obj   % raíz del documento
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % cuerpo del reporte: A4 vertical, fuente del cuerpo
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % apéndice: A4 apaisado, rotado, con su propia fuente
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % página del apéndice: hereda tamaño, rotación, fuentes
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Los objetos 40 a 42 están casi vacíos. El tamaño de página, la rotación y los recursos de fuente llegan todos desde el nodo 7, lo que mantiene el archivo compacto y automantenible: agregue una cuarta página bajo el nodo del apéndice y sale apaisada sin que nadie la toque
También significa que las propiedades de una página no están todas en la página. El objeto 40 no tiene clave /MediaBox, y eso es perfectamente legal — un lector que trate la clave faltante como entrada malformada rechazará archivos válidos. La búsqueda tiene que subir por la cadena de /Parent hasta encontrar la entrada o llegar a la raíz. Esa caminata necesita un guardia contra ciclos. Un archivo corrupto puede cargar una referencia /Parent que apunte de vuelta a un nodo ya visitado, y sin un conjunto de objetos visitados la búsqueda gira para siempre
El mismo mecanismo crea el clásico peligro de mover páginas. Digamos que una herramienta mueve el objeto 40 al cuerpo del reporte editando los dos arreglos /Kids y redirigiendo /Parent al nodo 6. El movimiento es estructuralmente válido, y sin embargo el objeto 40 ahora hereda el /MediaBox vertical, ninguna rotación y la fuente /F1 — mientras su content stream todavía selecciona /F2, que ya no se resuelve. La página se encoge, pierde la rotación y pierde su texto en una sola edición. El código de reordenamiento que se sostiene escribe los valores resueltos de los cuatro atributos heredables sobre el diccionario de la página antes de re-emparentarla. Si usted alguna vez arrastró una página en un editor y la vio cambiar de tamaño u orientación, este es el mecanismo que presenció
Aplanado: legal, común, ocasionalmente costoso
Muchas herramientas van en sentido contrario. Los escritores mínimos emiten un árbol de un solo nivel porque es simple, y muchas utilidades de fusión y división reconstruyen cualquier árbol que leen en un solo arreglo /Kids plano, ya que la salida equilibrada es trabajo extra y la salida plana siempre conforma. Una reconstrucción correcta tiene que resolver la herencia al mismo tiempo. Cada atributo que una hoja estaba heredando debe copiarse sobre la hoja, o elevarse a la nueva raíz si es uniforme en todo el documento; sáltese ese paso y la salida cambia la geometría exactamente como el caso de mover páginas
Para documentos típicos, aplanar es inofensivo. Duele a gran escala, de las dos formas ya descritas: el array raíz se convierte en un objeto grande que cada apertura y cada salto de página debe analizar por completo, y cada edición estructural lo reescribe entero. Lo que aplanar no destruye es la compartición mediante referencias indirectas: un árbol plano en el que las 10,000 páginas apuntan al mismo objeto diccionario /Resources sigue estando deduplicado. Lo único que se pierde es la opción de omitir la entrada en la página y dejar que un ancestro la proporcione
Cuando /Count miente
/Count es pura contabilidad. Debe ser igual al número de páginas hoja en el subárbol del nodo, y nada en el formato de archivo lo impone. Dos patrones de corrupción explican la mayoría de los recuentos mentirosos que se ven en la práctica
El primero es el recuento obsoleto que deja una actualización incremental. Un editor inserta una página, reescribe el padre inmediato con un nuevo /Kids y un /Count actualizado, añade ambos al archivo, y nunca toca a los ancestros:
% Revisión original
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Revisión añadida: se insertó una página en la rama intermedia.
% El objeto 14 queda reemplazado; el objeto 12 nunca se reescribe
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
El árbol ahora contiene diez hojas, pero la raíz sigue diciendo nueve. Un visor que confía en la raíz muestra nueve en su contador de páginas. Uno que usa los recuentos interiores para buscar binariamente un salto de página calcula el índice equivocado para cada página posterior al punto de inserción. Un recorrido completo encuentra diez. Tres respuestas distintas, un archivo
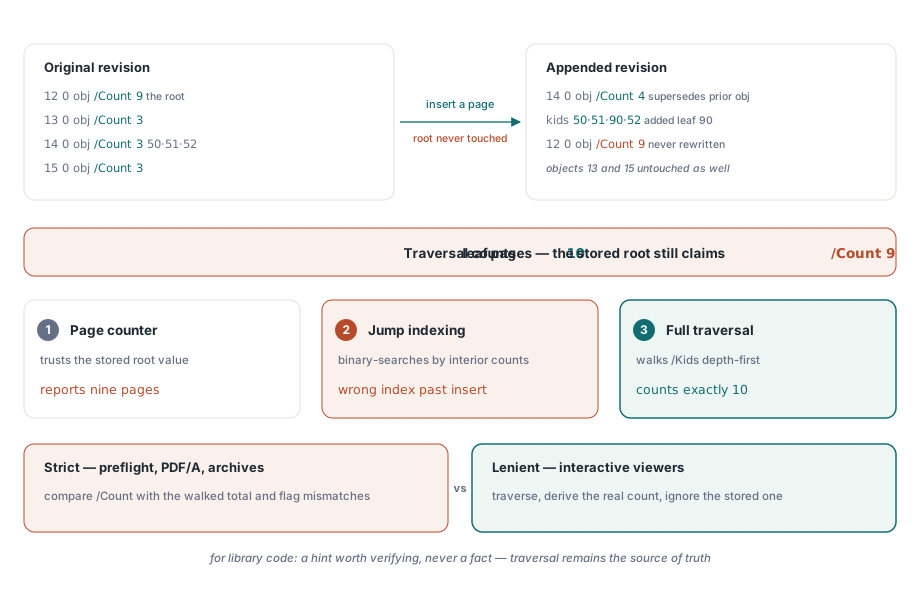
Hay una forma más silenciosa de que el mismo archivo lo muerda. El código que lee el recuento de la raíz, empieza a recorrer el árbol, y se detiene una vez que recolectó esa cantidad de páginas jamás verá la página diez. Sin excepción, sin advertencia, solo un documento que queda una página corto. Usar /Count como límite de ciclo o como revisión de límites es el error; la caminata tiene que correr hasta que el árbol se agote, diga lo que diga el número almacenado
El segundo patrón es el recuento que nunca podría ser correcto: negativo, cero en un nodo con contenido, o absurdamente enorme. Estos provienen de fuzzing, de daños durante la transmisión y, ocasionalmente, de errores aritméticos en los editores. Son peligrosos específicamente para el código que confía en /Count para reservar memoria: dimensionar un array a partir de un /Count de -3 provoca, en el mejor de los casos, un error de rango, y hacerlo a partir de un /Count de dos mil millones es una asignación que provoca denegación de servicio. El valor es una entrada no confiable, como cualquier otro número del archivo
Los parsers se dividen en dos bandos frente a todo esto. Los consumidores estrictos — herramientas de preflight, validadores PDF/A, pipelines de archivo — comparan /Count contra el resultado del recorrido y rechazan o marcan el archivo. Los visores interactivos son casi universalmente tolerantes: recorren, derivan el recuento real e ignoran silenciosamente el almacenado, que es exactamente por qué un archivo con recuento obsoleto puede circular por años sin quejas hasta que se topa con un parser más estricto dentro de algún flujo de trabajo automatizado. Para código de librería creemos que el punto medio es el predeterminado correcto. Use /Count como pista para la preasignación, y para saltarse subárboles una vez verificado, y deje que el recorrido siga siendo la fuente de verdad
En producción estos fallos rara vez se anuncian como problemas de árbol. Se presentan como páginas barajadas, una página faltante al final de una fusión, o una página que cambia de tamaño u orientación después de un reordenamiento. El caso de estudio de depuración traza uno de estos reportes de vuelta a través del árbol. Para la anatomía del archivo que rodea todo esto (objetos, datos de referencia cruzada, trailers), la visión general de la estructura de archivos PDF es el lugar para empezar
El HotPDF Delphi Component se encarga de todo esto internamente: recorre árboles anidados de cualquier profundidad, resuelve los atributos heredados cuando las páginas se copian o se mueven, y verifica /Count contra el recuento real de hojas en lugar de confiar en él, de modo que los índices de página en su API siempre significan páginas lógicas