El síntoma clásico parece un off-by-one: una rutina de copia de páginas pide la página 1 de un documento de tres páginas y consistentemente obtiene la página 2. La lógica de indexación revisa bien. La llamada usa un índice lógico basado en 0, la aritmética es correcta, las condiciones límite están bien. Sin embargo, siempre sale la página equivocada
La causa no está en el código de copia en absoluto. Está en cómo el cargador construye su arreglo de páginas, y es una de las trampas más fáciles de caer en el parseo de PDF
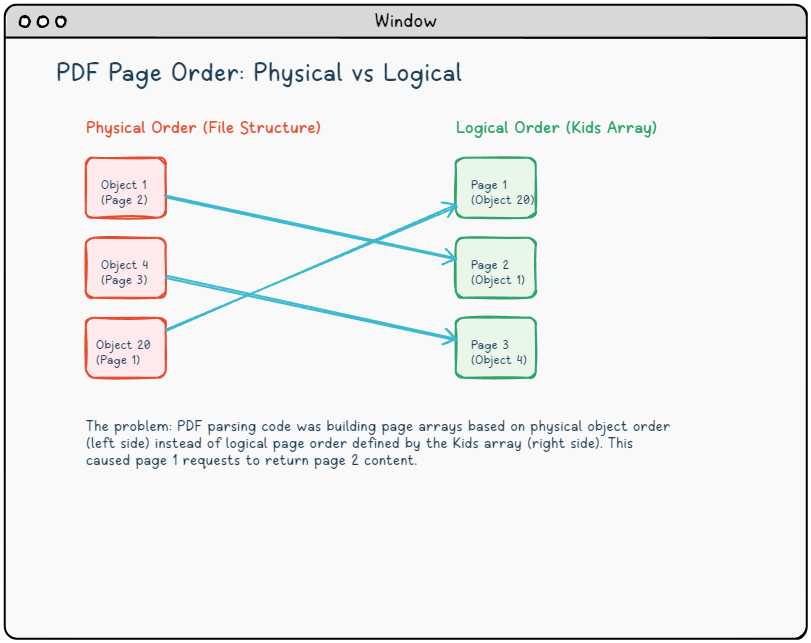
Dos ordenamientos, una fuente de confusión
Un archivo PDF es una colección de objetos indirectos, cada uno identificado por un número de objeto. La estructura del archivo no impone ninguna obligación de que esos números reflejen el orden de lectura. El objeto 1 puede contener la página 2; el objeto 20 puede contener la página 1. Lo que realmente define el orden de lectura es el árbol de páginas: una jerarquía de diccionarios /Pages cuyos arreglos /Kids enumeran las referencias de página en la secuencia en que un visor debería mostrarlas (ISO 32000-1 §7.7.3)
Este es un árbol de páginas que expone la trampa:
{ Raíz del árbol Pages, objeto 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { página lógica 1 }
         1 0 R    { página lógica 2 }
         4 0 R]   { página lógica 3 }
>>
endobj
Resultó que el archivo enumeraba el objeto 1 y el objeto 4 antes que el objeto 20 en el flujo de bytes. Cualquier analizador (parser) que iterara a través de objetos indirectos en el orden del archivo y los estampara en un PageArr a medida que encontraba diccionarios de tipo página, terminaría con el objeto 1 en el índice 0, el objeto 4 en el índice 1 y el objeto 20 en el índice 2. La página lógica 1 se encuentra en PageArr[2]. Solicitar el índice de página 0 obtiene la página lógica 2
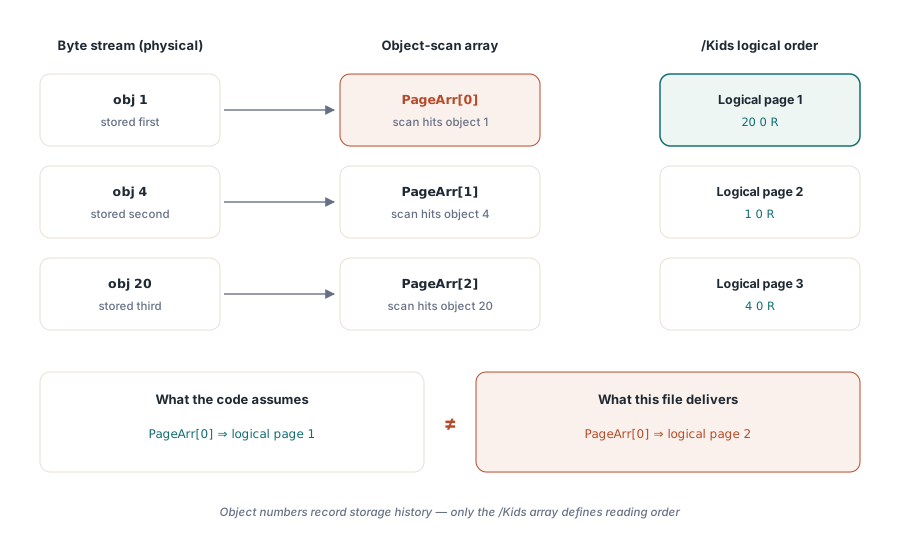
Confirmando la hipótesis
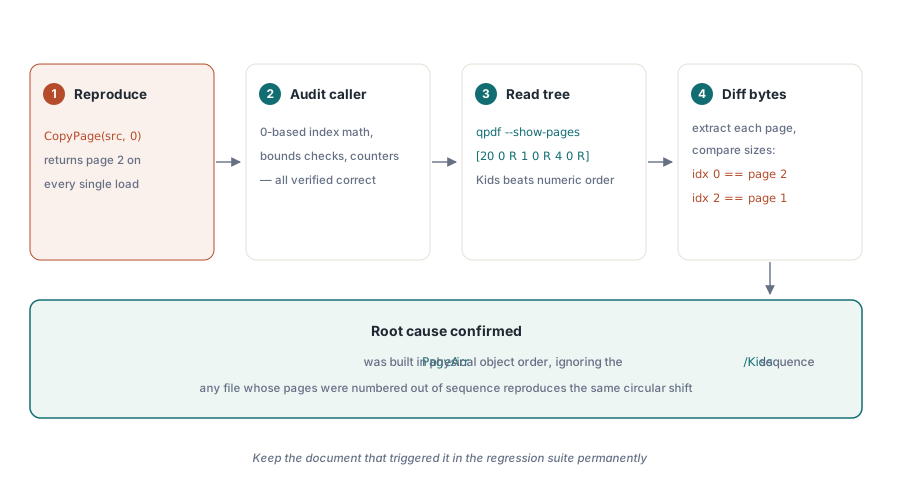
Antes de cambiar cualquier código, pruebe la falta de coincidencia en lugar de asumirla. La herramienta de línea de comandos qpdf hace que esto sea sencillo:
{ shell }
qpdf --show-pages input.pdf
{ La salida revela el orden de Kids: 20 0 R, después 1 0 R, después 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Muestra el diccionario Pages con /Kids en orden de lectura }
Extraer cada página individualmente y comparar los tamaños de archivo confirma el mapeo: lo que un PageArr[0] de escaneo de objetos produce es el contenido perteneciente a la página lógica 2, y PageArr[2] contiene la página lógica 1. El desplazamiento circular es la prueba irrefutable. También explica por qué el síntoma aparece en muchos documentos de origen diferentes: cualquier PDF en el que los objetos de página tengan números de objeto más bajos que una página lógica anterior lo desencadena
Hay una razón sencilla por la que los PDF terminan en este estado. Una actualización incremental conserva los números de objeto de los objetos que cambia, pero todo lo que agrega —una página de portada insertada al frente, por ejemplo— recibe un número nuevo por encima de todo lo que ya está en el archivo, mientras que su referencia va al inicio del arreglo Kids. Las herramientas que combinan o reorganizan documentos renumeran los objetos en el orden que les conviene. Algunos generadores simplemente escriben las páginas en un orden conveniente para la transmisión de contenido en lugar de la secuencia lógica de las páginas. El formato PDF no les exige a ninguno que haga otra cosa
El enfoque correcto: seguir el arreglo Kids
Construya la lista de páginas recorriendo la cadena /Kids desde la raíz del catálogo, no escaneando objetos indirectos. El recorrido tiene que ser recursivo, porque un documento grande suele repartir sus páginas entre nodos /Pages intermedios, y debe protegerse contra un árbol mal formado que apunte de vuelta a uno de sus propios ancestros. En el boceto de abajo, TPdfDict y TPdfArray representan los tipos de diccionario y arreglo que use su parser:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // un ciclo o un árbol patológicamente profundo
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // sigue la referencia indirecta
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // nodo intermedio
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // hoja: siguiente página en orden de visualización
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Uso: empezar desde la entrada /Pages del catálogo
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Dos detalles son deliberados. Una hoja sin entrada /Type sigue tratándose como página, porque algunos escritores la omiten y los visores abren esos archivos de todos modos. Y la comparación final de /Count no cuesta nada pero atrapa árboles truncados o editados a mano antes de que un llamador indexe en ellos
Si usted carga documentos con HotPDF, este orden ya queda resuelto cuando el documento se carga: los índices de página siguen el orden de visualización del árbol de páginas, incluidos los nodos /Pages anidados, así que el índice 0 siempre es la primera página que muestra un visor. El recorrido de arriba importa cuando su propio código parsea la estructura PDF directamente
Copiar por índice lógico con CopyPageFromDocument
Como HotPDF resuelve el orden de páginas al momento de cargar, los índices de páginas lógicas significan lo que los llamadores esperan. La función de mayor nivel CopyPageFromDocument toma un índice lógico basado en 0 y copia la página correcta en el documento de destino:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Copia la página lógica 0 (la primera que ve el usuario) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Como el índice es un índice de orden de visualización, CopyPageFromDocument se comporta correctamente incluso con documentos donde el orden físico y el lógico difieren. Para operaciones por lotes, InsertPagesFromDocument acepta un arreglo de índices lógicos y los copia en una sola pasada
Lo que esto revela sobre el análisis de PDF
La especificación PDF es explícita: el orden lógico de las páginas está definido por el arreglo /Kids del árbol de páginas, no por números de objeto ni desplazamientos de bytes (ISO 32000-1 §7.7.3.2). Cualquier analizador que use un ordenamiento diferente como atajo producirá resultados correctos en la mayoría de los documentos que procesa, porque la mayoría de los generadores escriben las páginas en el orden natural y asignan números de objeto secuenciales. El error se oculta hasta que alguien carga un PDF que fue editado de forma incremental, reorganizado por otra herramienta o generado por un software que eligió una disposición diferente
Hacer pruebas únicamente con archivos PDF autogenerados omite por completo esta clase de problema. El manejo del orden de páginas necesita un corpus de pruebas de documentos de fuentes variadas: guardados incrementales, documentos escaneados con páginas de portada insertadas, archivos PDF producidos por herramientas que linealizan u optimizan el gráfico de objetos de manera diferente. Cualquier documento cuyo orden físico y lógico difieran merece un lugar permanente en ese corpus
La página de HotPDF Delphi Component cubre toda la API para operaciones de página, incluyendo CopyPageFromDocument, InsertPagesFromDocument y MovePage