Ein Vertrag, der aus einer Textverarbeitung mit nicht angehaktem Kästchen „tagged PDF“ exportiert wurde, sieht auf dem Bildschirm trotzdem strukturiert aus: ein 24-Punkt-Fetttitel, nummerierte Klauseln, ein liniierter Gebührenplan. In reflow-fähiges HTML konvertiert kommt der Gebührenplan als ordentliche <table> zurück, während der Titel ein <p> mit exakt demselben Stand wie eine Fußnote ist. Diese Ausgabe ist korrekt. ISO 32000-1 §14.8 gibt einer PDF genau einen Ort, um zu sagen „dieser Textlauf ist eine Überschrift“, den Strukturbaum, und eine ungetaggte Datei hat keinen. Schriftgröße und Fettdruck sind Satzentscheidungen, und ein Konverter, der jede große fette Zeile in ein <h1> verwandelt, macht auch Pull-Quotes, Tabellensummen und den Firmennamen im Briefkopf zu Überschriften
Die Frage, die man jeder PDF-nach-HTML-Pipeline stellen sollte, lautet also, woher jede Überschrift, jeder Listeneintrag und jede Tabelle in ihrer Ausgabe stammt, und wie weit jedem davon ein Telefon-Layout, ein Screenreader oder ein Suchindexer vertrauen kann. Überschriften und Tabellen geben unterschiedliche Antworten. Der Export-Schritt fügt eigene Entscheidungen über Zeilenumbrüche, Zeichenkodierung und Speicher hinzu
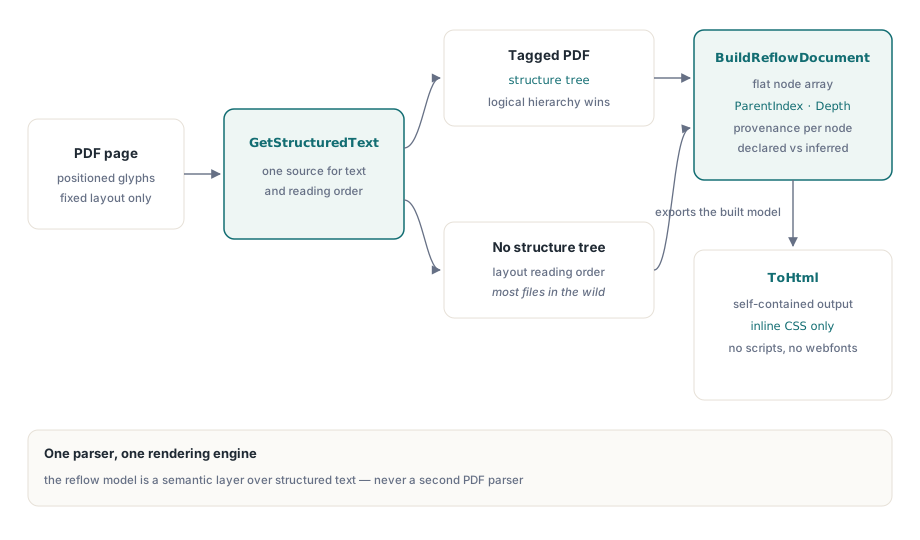
Woher Überschriften und Listen kommen
PDFium Component baut das Reflow-Modell mit TPdf.BuildReflowDocument, und diese Methode nimmt jedes Wort, jeden Block und jeden semantischen Hinweis aus GetStructuredText, derselben strukturierten Textebene, die in strukturierte Textblöcke und Lesereihenfolge beschrieben wird. Es gibt keinen zweiten Parser und keinen zweiten Textextraktor dahinter. Für jede Seite im angeforderten Bereich sammelt sie Blöcke in physischer Layoutreihenfolge. GetStructuredText hat bereits jeden Block gegen die getaggten Inhalte der Seite über überlappende Fläche gematcht, und BuildReflowDocument kopiert die gefundene Rolle auf den Block: H bis H6 werden Überschriften mit ihrer Ebene, LI, Lbl und LBody werden Listeneinträge, Figure wird eine Figur, deren Text die Alternativbeschreibung ist, und Caption wird eine Beschriftung
Zwei Konsequenzen folgen, und beide lassen sich leicht beobachten. Die Blockreihenfolge folgt stets dem Seitenlayout, sogar in einer getaggten Datei, also entscheiden die Tags, was ein Block ist, und die Geometrie entscheidet, wohin er gehört. Und auf einer Seite ohne Tags ist jeder Block ein Absatz. Überschriften und Listen werden nie aus der Schriftgröße geraten
Jeder Knoten trägt ein Source-Feld vom Typ TPdfReadingOrderSource: rosStructure, wenn die Rolle aus dem Strukturbaum kam, rosHeuristic, wenn sie allein aus dem Layout kam. Das exportierte HTML wiederholt das als data-source="structure" oder data-source="inferred" auf jedem Element, und das dokumentweite TPdfReflowDocument.Source ist nur dann rosStructure, wenn jede Seite im Bereich getaggt war. Tabellen sind immer rosHeuristic, denn sie kommen aus geometrischer Erkennung und nicht aus Table-Tags. Wenn ein nachgelagerter Schritt Überschriften als Navigationslandmarken behandelt, prüfen Sie dieses Feld zuerst; ein getaggtes Dokument gibt Ihnen Landmarken, die der Autor gewählt hat
Ein flaches Knoten-Array statt eines Objektbaums
TPdfReflowDocument.Nodes ist ein in Pre-Order abgeflachter Baum: ein dynamisches Array von TPdfReflowNode-Records, von denen jeder ein ParentIndex und eine Depth hält. Seitenknoten sitzen auf Tiefe 0 mit einem Parent-Index von -1. Absätze, Überschriften, Figuren, Beschriftungen, Listen und Tabellen hängen auf Tiefe 1 an der Seite, Listeneinträge sitzen auf Tiefe 2 unter ihrer Liste, und Tabellenzellen erreichen auf Tiefe 3 eine Zeile. Aufeinanderfolgende Listeneinträge teilen sich einen Listenknoten; jeder andere Block oder eine Tabelle dazwischen beginnt eine neue Liste
Das flache Layout ist eine Portabilitätsentscheidung. Ein rekursiver Record, der ein dynamisches Array von sich selbst enthält, kompiliert unter Delphi, C++Builder und Free Pascal, aber die drei behandeln rekursive managed Types jenseits einer Package- oder DLL-Grenze unterschiedlich. Ein flaches Array aus schlichten Records verhält sich in allen dreien gleich, und es lässt sich mit einer einzigen for-Schleife und ohne Rekursion streamen
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // alle Seiten, Tabellen an, CSS an
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // an einem Tabellenknoten halten RowSpan/ColumnSpan die Zeilen- und Spaltenanzahl der Tabelle
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
Auf dem ungetaggten Vertrag aus der Einleitung druckt diese Schleife überhaupt keine H-Zeilen und eine Tabellenzeile pro erkanntem Gebührenplan. Läuft sie auf einer getaggten Kopie desselben Dokuments, erscheinen die Überschriften mit True daneben. FirstPage und LastPage in den Optionen defaulten auf 0, was die erste und letzte Seite des Dokuments bedeutet; ein Bereich außerhalb der Seitenanzahl wirft eine EPdfError, bevor eine Seite gelesen wird
Warum erscheint Tabellentext nicht doppelt?
Die Tabellenerkennung läuft auf jeder Seite, nachdem der strukturierte Text gesammelt wurde, was bedeutet, dass die Wörter in einer Tabelle doppelt existieren: einmal als Textblöcke, einmal als Zellen. Beide auszugeben bedeutet, dass in jedem HTML auf jede Tabelle ihr eigener Inhalt erneut als lose Absätze folgt, was genau das ist, was ein naives „Tabellen zum Text hinzufügen“-Merge produziert
Das Modell löst das geometrisch. Ein Textblock, dessen Begrenzungsbox mindestens zur Hälfte innerhalb der Grenzen einer erkannten Tabelle liegt, wird verworfen, und der Tabellenknoten tritt an seine Stelle. Tabellen werden dann nach vertikaler Position mit den übrigen Blöcken verzahnt (höher auf der Seite zuerst, mit Links-nach-rechts als Tie-Breaker, wenn die Oberkanten innerhalb eines halben Punkts liegen), also landet eine Tabelle zwischen dem Absatz über ihr und dem Absatz unter ihr, statt ans Ende der Seite angehängt zu werden
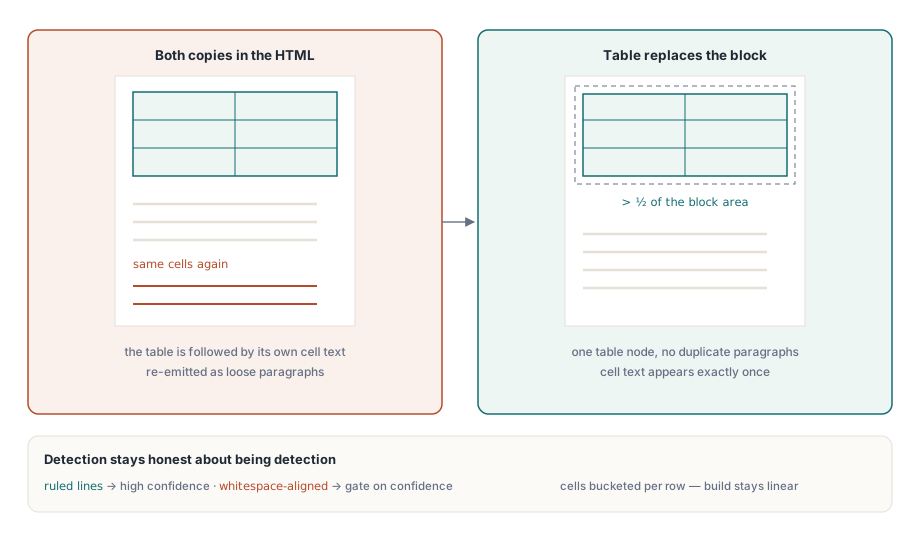
Der Halbflächen-Schwellwert hat eine sichtbare Kante. Ein Block, der über die Tabellengrenze hinwegreicht und größtenteils außerhalb sitzt, überlebt intakt, also kann eine Textzeile gelegentlich sowohl in der letzten Tabellenzeile als auch im folgenden Absatz erscheinen. Das ist die richtige Seite, auf der man sich irrt. Ein Schwellwert niedrig genug, um jeden überlappenden Block zu entfernen, würde auch Fließtext löschen, der nur eine Tabellenbegrenzungsbox berührt, und eine doppelt vorhandene Zeile ist weit leichter zu bemerken und zu verzeihen als ein fehlender Satz
Erkannte Tabellen tragen außerdem eine Confidence, und die beiden Erkennungsstrategien landen in verschiedenen Bändern. Eine aus Linien gefundene Tabelle scoret zwischen 0,88 und 1.0, je nachdem, wie viele ihrer Zellen Text halten. Eine rein aus Whitespace-Ausrichtung abgeleitete Tabelle scoret zwischen 0,58 und 0,88. Die Confidence des Tabellenknotens hält diesen Wert, jeder Zellknoten wiederholt ihn, und das HTML schreibt ihn als data-confidence auf dem <table>-Element. Tabellen unter TableOptions.MinConfidence (standardmäßig 0.5) werden nie erzeugt, und wenn eine Tabelle abgelehnt wird, bleiben ihre Wörter schlicht als gewöhnliche Absätze im Modell
Für einen Suchindex oder eine mobile Leseansicht kostet eine falsche Tabelle wenig, und eine korrekt erkannte ist eine große Verbesserung, also lassen Sie die Defaults. Für eine Archiv-Konvertierung, wo ein erfundenes Raster um einen zweispaltigen Adressblock schlimmer ist als kein Raster, beschränken Sie die Erkennung auf Linientabellen:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // nur Linientabellen
Options.TableOptions.MinConfidence := 0.9;            // auch spärliche Linienraster verwerfen
Options.TableOptions.MaxTables := 200;                // dokumentweiter Deckel
Options.TableOptions.MaxCells := 50000;               // dokumentweiter Deckel

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
Innerhalb eines Reflow-Builds werden MaxTables und MaxCells über den ganzen Seitenbereich gezählt, nicht pro Seite, also braucht ein 300-Seiten-Statement mit einer Linientabelle auf jeder Seite ein MaxTables von mindestens 300, sonst stoppt der Build mit einer EPdfError an der ersten Tabelle über dem Limit. Die Defaults sind 1000 Tabellen und 100000 Zellen
Für die Erkennungsseite selbst, inklusive dünner gefüllter Rechtecke, die als Rahmen gezeichnet werden, und Fortsetzung über Seiten hinweg, siehe Tabellenerkennung und -extraktion
HTML exportieren, das nichts weiter braucht
TPdfReflowDocument.ToHtml durchläuft das bereits gebaute Modell und fasst PDFium nie wieder an, also liefert das Exportieren desselben Modells zweimal denselben String. Mit gesetztem FullDocument (dem Default) ist das Ergebnis eine komplette Seite: Doctype, <meta charset="utf-8">, ein Viewport-Meta-Tag, ein aus dem Title-Eintrag des Dokuments übernommenes <title> (oder „PDF document“, wenn das leer ist), und ein lang-Attribut aus der Sprache des Dokuments. Mit ausgeschaltetem FullDocument bekommen Sie ein einzelnes <div class="pdf-reflow">-Fragment zum Einsetzen in Ihre eigene Vorlage
Das optionale Stylesheet aus IncludeCss ist ein Inline-<style>-Block: eine 72rem-Lesespalte, jede PDF-Seite als weiße Karte, wenn IncludePageSections an ist, zusammengefallene Tabellenrahmen und eine Media Query unter 40rem, die das Karten-Padding entfernt und Tabellentext schrumpfen lässt. Kein Skript, kein Webfont und keine externe URL, was die Datei in eine E-Mail, einen CHM-artigen Help-Viewer oder ein sandboxed Browser-Control setzen lässt. Überschriften-Ebenen außerhalb 1 bis 6 werden als h2 geschrieben, Header-Zellen werden th, und Zellen mit einem RowSpan oder ColumnSpan über 1 bekommen rowspan und colspan. IncludeGeometry einzuschalten fügt data-left, data-top, data-right und data-bottom in PDF-Punkten hinzu, was praktisch ist, um einen Suchtreffer zurück auf der gerenderten Seite hervorzuheben
PreserveLineBreaks verdient eine bewusste Entscheidung. Ein Zeilenumbruch innerhalb eines PDF-Absatzes wurde für eine feste Spaltenbreite gemacht; ihn auf einem 360-Pixel-Bildschirm zu behalten bedeutet, dass jede Zeile doppelt umbricht, das Zackenmuster, das Reflow gerade beseitigen soll. Für Fließtext lassen Sie es aus (der Default). Für Dokumente, in denen der Umbruch Bedeutung trägt, etwa Adressen, Verse oder Code-Listings, schalten Sie es ein, und es schreibt <br> statt eines Leerzeichens
Bei einem langen Dokument verdoppelt es den Speicherpeak, die ganze Seite als ein WString zu bauen und dann zu kodieren. WriteHtml streamt dasselbe Markup stattdessen in einen TPdfReportWriter und schreibt ASCII mit jedem Nicht-ASCII-Zeichen als numerische Character Reference, sodass die Bytes gültig sind, egal wie die empfangende Seite die Kodierung errät:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // Der Seitenzustand wird danach wiederhergestellt

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // Ausgabe-Byte-Deckel, 64 MiB Maximum
  Limits.MaxItems := Options.MaxNodes;       // ein Item pro Knoten, 1048576 Maximum

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // der Stream bleibt in Aufrufer-Eigentum
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml prüft mehr als ToHtml. Es verweigert ein Modell mit mehr Knoten als Options.MaxNodes, erzwingt Options.MaxCharacters auf dem Text, den es schreibt, begrenzt die Verschachtelung auf das MaxDepth-Argument (standardmäßig 64) und verifiziert, dass jeder ParentIndex auf einen früheren Knoten zeigt. Diese letzte Prüfung zählt, wenn Ihr Code Nodes vor dem Export filtert oder umschreibt: Ein bearbeitetes Array mit einem vorwärtsgerichteten Parent-Index wirft eine EPdfReportLimit, statt Markup mit unverpaarten Tags zu produzieren
Budgets, Abbruch und die aktuelle Seite
Eine PDF ist nicht vertrauenswürdige Eingabe, und eine fehlerhafte oder feindliche Datei kann tausende Seiten winzigen Texts deklarieren. BuildReflowDocument prüft die Zeichen-, Knoten-, Tabellen- und Zellen-Budgets, bevor ein Knoten hinzukommt, also stoppt eine Datei, die sie übersteigt, mit einer EPdfError und einer Meldung, die das Budget benennt („Reflow node budget exceeded“ zum Beispiel), während der Speicherverbrauch noch begrenzt ist. Sowohl MaxCharacters als auch MaxNodes müssen positiv sein; die Defaults sind 10.000.000 Zeichen und 1.000.000 Knoten
Das optionale IPdfCancellationToken wird vor jeder Seite, zwischen Blöcken, vor jeder Tabelle und vor jeder Tabellenzeile geprüft. Übergeben Sie das Token einer TPdfCancellationTokenSource, die Ihrem Formular gehört, rufen Sie aus dem Button-Handler Cancel auf, und der Build wirft an der nächsten dieser Stationen eine EPdfOperationCancelled. Fangen Sie sie getrennt von EPdfError, damit das Abbrechen durch einen Benutzer nicht als kaputte Datei geloggt wird. Mit welcher Exception der Build auch endet, nichts Teilhaftes wird zurückgegeben; passiert das Scheitern später innerhalb von WriteHtml, hält die Zieldatei eine abgeschnittene Seite, also löschen Sie sie in Ihrem eigenen Exception-Handler
Der Seitenzustand ist das Detail, von dem GUI-Code abhängt. Der Build besucht jede Seite im Bereich, indem er PageNumber verschiebt, und ein try/finally stellt die Seite des Aufrufers bei Erfolg, bei einem Budget-Fehlschlag und bei einem Abbruch gleichermaßen zurück. Ein Viewer, der einen Export startet, während der Benutzer Seite 340 liest, ist beim Zurückkehren des Exports immer noch auf Seite 340
Wo Reflow passt
Reflow-Ausgabe funktioniert gut als Eingabe für Suchindexierung, zugängliche Leseansichten, Telefondarstellung und Inhaltsmigration in ein CMS. Sie lässt absichtlich absolute Positionierung, exakte Fonts, Vektorgrafik und Seitengeometrie fallen, abgesehen von den optionalen data-*-Koordinaten. Wenn ein Job verlangt, dass die Seite identisch aussieht, rendern Sie sie; wenn er verlangt, dass die Wörter woanders lesbar sind, reflowen Sie sie
Weil Überschriften und Listen nur aus Tags kommen, folgt die Qualität des HTML der Qualität des Taggings stromaufwärts. Dokumente, die die Prüfungen in PDF/UA-Strukturbaum-Validierung bestehen, produzieren Modelle mit echter Überschriften-Hierarchie, und derselbe getaggte Inhalt treibt die Lesefunktionen in einen zugänglichen Reader bauen
Reflow, strukturierter Text, Tabellenextraktion und Rendering laufen alle gegen dasselbe TPdf-Objekt in Delphi, C++Builder und Lazarus; Options-Records, Exceptions und der Report-Writer sind auf der PDFium-Component-Produktseite für Delphi dokumentiert