Ein zweispaltiger Konferenzpapier-Aufsatz, nach vertikaler Position sortiert, kommt mit einer ersten Zeile wie Abstract We measure the 2 Related work Earlier studies zurück: den Anfangswörtern der linken Spalte und den Anfangswörtern der rechten Spalte, zusammengeklebt, weil beide auf derselben Grundlinie sitzen. Im Parser ist nichts schiefgegangen. Eine PDF-Seite bietet zwei vertretbare Ordnungen für ihren Text an, die Sequenz, in der der Content-Stream sie zeichnet, und die Position jedes Glyphs auf der Seite, und bei vielen Layouts widersprechen sich diese beiden Ordnungen. Ein Extraktor, der positionierte Blöcke statt eines Strings zurückgibt, lässt Sie sehen, welche Ordnung Sie bekommen haben, und umschalten, wenn es die falsche für die Seite vor Ihnen ist
Was GetStructuredText zurückgibt
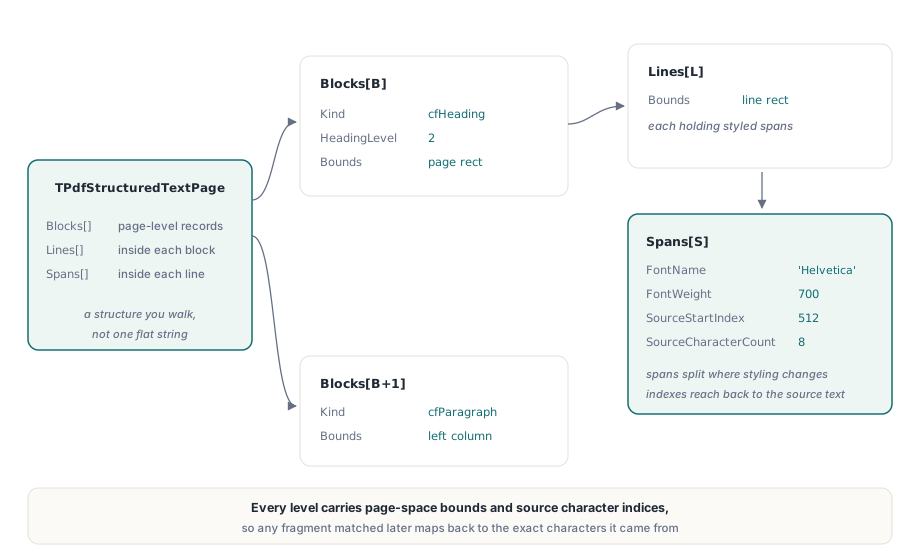
TPdf.GetStructuredText in PDFium Component gibt eine TPdfStructuredTextPage für die aktuelle Seite zurück: ein Array von Blöcken, jeder Block ein Array von Zeilen, jede Zeile ein Array von gestylten Spans. Jede Ebene trägt ihren eigenen Text und ein Bounds-Rechteck im Seitenraum in PDF-Punkten, sodass sich eine Überschrift, eine einzelne Zeile oder eine fette Phrase ohne zweite Nachschlage auf der Seite lokalisieren lässt. Der Seiten-Record ergänzt Width, Height, CharacterCount und zwei weiter unten beschriebene Qualitätszähler
Der abgeflachte Page.Text wird aus den Blöcken gebaut statt aus dem rohen Zeichenstrom. Zeilen innerhalb eines Blocks werden mit einem einzelnen CRLF verbunden und Blöcke durch eine Leerzeile getrennt, was bedeutet, dass ein Plain-Text-Dump von Page.Text bereits zeigt, wo der Extraktor seine Blockgrenzen gezogen hat. Das macht ihn zur schnellsten Sache zum Ausgeben, wenn eine Seite seltsam liest
Das Ganze wird von einem kleinen Options-Record angetrieben. TPdfStructuredTextOptions.Default setzt ReadingOrder auf roPhysicalLayout, schaltet IncludeFontInfo und IncludeSemantics ein und setzt MaxCharacters auf 1.000.000. Das Reading-Order-Feld ist das, das die Form der Ausgabe am stärksten verändert
Wie die beiden Lesereihenfolgen Zeilen und Blöcke bauen
roContentOrder behält die Zeichnsequenz des Erzeugers, während roPhysicalLayout die Ordnung aus Glyphpositionen neu baut, und der Unterschied zeigt sich zuerst darin, wie Zeilen gebildet werden. In Content Order werden Zeichen in der Reihenfolge genommen, in der die Seite sie zeichnet. Eine neue Zeile beginnt an einem expliziten Zeilenumbruch oder wenn das nächste Zeichen die aktuelle Zeile nicht mehr vertikal überlappt. Eine Zeile schließt sich dann dem Block direkt vor ihr nur an, wenn sich die beiden horizontal um mindestens ein Fünftel der schmaleren Breite überlappen und der vertikale Abstand nicht mehr als etwa zweieinviertel Zeilenhöhen beträgt; sonst öffnet sie einen neuen Block. Blöcke bleiben in Zeichnreihenfolge
Physical Layout wirft die Zeichnsequenz weg. Jedes Zeichen mit bekannter Box wird nach der vertikalen Mitte dieser Box sortiert, Oberkante der Seite zuerst, dann nach seiner linken Kante. Zeichen, deren vertikale Ausdehnungen sich ausreichend überlappen, teilen eine Zeile, und dieser Test sieht nur auf die Höhe. Der horizontale Abstand spielt keine Rolle. Jede Zeile schließt sich dann dem vorhandenen Block, der nach derselben Überlapp-und-Abstands-Regel am besten passt, und die fertigen Blöcke werden nach ihrer Oberkante sortiert, wobei die linke Kante Gleichstände innerhalb eines halben Punkts bricht
Diese zweite Regel ist der Ursprung des Eingangsbeispiels. Teilen die beiden Spalten eines Aufsatzes ein Grundlinienraster, überlappen die erste Zeile der linken Spalte und die erste Zeile der rechten Spalte vertikal, also setzt physical layout sie auf eine Zeile. Die Lücke am Bundsteg ist breiter als ein Viertel der Schriftgröße, also fügt der Extraktor ein Leerzeichen ein und macht weiter. Jede Zeile des Fließtexts macht dasselbe, die verschmolzenen Zeilen überlappen einander alle horizontal, und der ganze zweispaltige Fließtext wird zu einem einzigen breiten Block, der quer über den Bundsteg liest
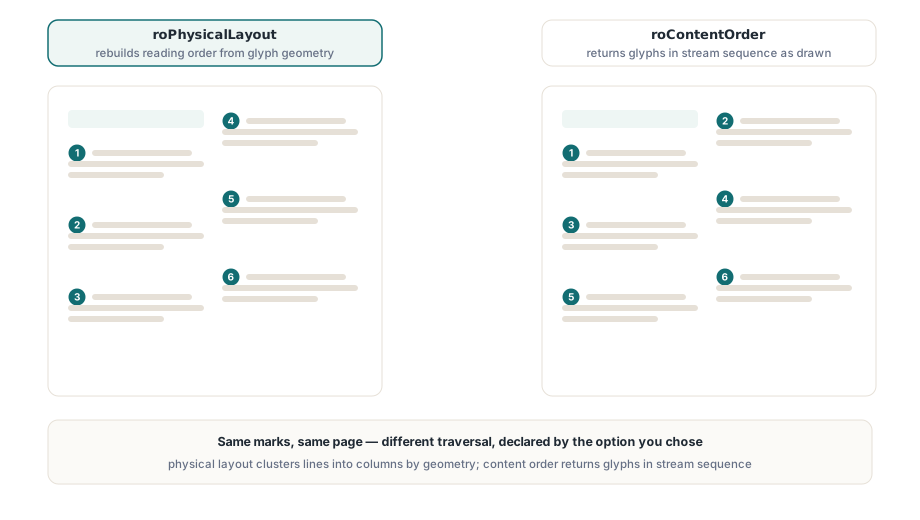
Content Order kommt mit dieser Seite gut zurecht, wann immer der Erzeuger Spalte eins vor Spalte zwei geschrieben hat, was Textverarbeitungen und Satzsysteme normalerweise tun. Die Zeilen der linken Spalte stapeln sich zu Blöcken, die erste Zeile der rechten Spalte hat keine horizontale Überlappung mit ihnen und öffnet einen frischen Block, und die Blöcke kommen in der Reihenfolge heraus, in der der Autor sie schrieb. Physical Layout verdient seinen Platz auf einer anderen Art Seite: Rechnungen, Kontoauszüge, Formulare und Folien, wo ein Label und sein Wert auf derselben Grundlinie sitzen und die Zeile von links nach rechts zu lesen genau das ist, was man will. Es ist auch der Modus, wenn die Zeichnsequenz bedeutungslos ist, etwa bei Text, der Schrift für Schrift gemalt wird, oder einer Seite, die aus vielen kleinen Overlays zusammengesetzt ist
Für eine gemischte Sammlung teilen Sie die Wahl nach Dokumenttyp auf. Artikel, Berichte und Handbücher aus einem bekannten Autorenwerkzeug laufen über roContentOrder; Formulare und Transaktionsdokumente bleiben auf dem roPhysicalLayout-Default. Die folgende Routine gibt die Blöcke einer Seite in Content Order aus, mit markierten Überschriften, wenn die Datei getaggt ist
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // 1-basiert
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // Erzeuger, die spaltenweise schreiben

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
Wie erkennt man eine Zeile, die über den Bundsteg läuft?
Eine verschmolzene Zeile verrät sich über ihre Spans. GetStructuredText beginnt einen neuen Span, wann immer das nächste Zeichen nicht der direkte Nachfolger des vorherigen in der ursprünglichen Zeichenfolge der Seite ist, zusätzlich zu den unten behandelten Stilwechseln. Innerhalb einer Spalte sind aufeinanderfolgende Wörter gewöhnlich auch in der Quelle aufeinanderfolgend. Am Bundsteg einer verschmolzenen Zeile springt der Quellindex um hunderte Zeichen, und die horizontale Lücke zwischen den beiden Spans ist weit breiter als jeder Wortzwischenraum
Diese beiden Signale zusammen ergeben einen zuverlässigen Test, und Sie können ihn auf der Default-Ausgabe fahren, bevor Sie entscheiden, ob eine Seite stattdessen Content Order braucht. Der Snapshot der Zeichendaten, den GetStructuredText liest, wird pro Seite gecacht, standardmäßig acht Seiten, also regruppiert die zweite Anfrage derselben Seite mit anderem ReadingOrder Daten, die bereits im Speicher sind, statt die Seite erneut zu extrahieren
// LineCrossesGutter ist ein Helfer, den Sie selbst hinzufügen: Er markiert eine Zeile mit zwei
// benachbarten Spans, die auf der Seite weit auseinanderliegen und in der
// Quellzeichenfolge nicht benachbart sind
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // Alternativtext-Blöcke
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // ein Viertel der Zeilen, die eine Lücke kreuzen, sieht nach Spalten aus, nicht nach einer Formularzeile
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Achtzehn Punkte sind ein viertel Inch, bequem breiter als ein Wortzwischenraum im Fließtext und schmaler als die meisten Bundstege. Die Ein-von-vier-Schwelle lässt eine Rechnung mit ein paar Label-und-Betrag-Zeilen auf physical layout bleiben, während ein echter zweispaltiger Fließtext, in dem fast jede Zeile kreuzt, umschaltet. Hat der Erzeuger die Seite zeilenweise über beide Spalten hinweg geschrieben, bleiben die Quellindizes lückenlos, der Test greift nie, und keine der beiden Ordnungen trennt die Spalten für Sie; diese Seite braucht den Spaltenmodus der Readable-Content-API, beschrieben in zwei Spalten mit übergreifender Überschrift lesen
Was ändert IncludeSemantics, und was lässt es unangetastet?
IncludeSemantics etikettiert Blöcke; es ordnet sie nicht um. Mit eingeschalteter Option liest GetStructuredText den lesbaren Inhalt der Seite und gibt jedem Block die Art des Fragments, das es nach Fläche am größten überlappt. Die verfügbaren Arten sind cfParagraph, cfHeading mit einem HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther für jedes andere Tag, und cfPlain, wenn nichts passte. Jeder Block erhält zusätzlich ein Language und einen StructElementIndex, der ihn an ein Element des Strukturbaums bindet
Das Feld Source sagt, woher das Etikett kam: rosStructure, wenn die Seite einen brauchbaren Strukturbaum im Sinne von ISO 32000-1 §14.7 hat, rosHeuristic, wenn die Arten erschlossen wurden. Page.Source gibt dieselbe Antwort für die Seite als Ganzes. Eine mit rosStructure gemeldete Überschrift ist eine Überschrift, weil der Autor sie taggte; eine mit rosHeuristic gemeldete ist eine gebildete Vermutung, und eine Indexierungs-Pipeline, die Titel gewichtet, sollte beide unterschiedlich behandeln. Die Blockreihenfolge kommt in beiden Fällen weiterhin aus ReadingOrder. Der semantische Durchlauf nutzt die Readable-Content-Defaults, also erreicht eine über ReadableContentOptions gesetzte Spalteneinstellung GetStructuredText nicht
Figuren bekommen eine Extra-Regel. Auf einer getaggten Seite wird ein Figure-Element oder Alternativtext, der zu keinem Textblock passte, als eigener Block angehängt, der die alternative Beschreibung als seinen Text hält. Ein solcher Block hat eine einzelne Zeile und einen einzelnen Span mit auf -1 gesetztem SourceStartIndex, weil kein Glyph auf der Seite ihn erzeugt hat. Code, der Spans zu Zeichen zurückführt, muss diesen Wert überspringen, weshalb der Bundsteg-Test oben danach sucht. Die Strukturbaum-Prüfungen selbst behandelt PDF/UA-Strukturbaum-Validierung
Spans, Grenzen und der Weg zurück zu den Zeichen
Jeder TPdfStructuredTextSpan trägt seinen Text, seine Grenzen, FontName, FontSize, FontWeight und Angle, plus SourceStartIndex und SourceCharacterCount. Bei eingeschaltetem IncludeFontInfo endet ein Span, wo immer sich einer der vier Stilwerte ändert, also kommt ein Satz mit drei fetten Wörtern in der Mitte als drei Spans an, und Hervorhebung lässt sich aus FontWeight wieder aufbauen, statt aus Schriftnamen zu raten. Bei ausgeschaltetem IncludeFontInfo bleiben die Stilfelder leer, und Spans brechen nur, wo die Quellfolge unterbrochen ist
Der Winkel zählt auf Seiten mit Stempeln. Ein diagonales DRAFT-Wasserzeichen lebt im selben Koordinatenraum wie der Fließtext, und in physical layout können seine Buchstaben auf Fließtextzeilen landen, die sie vertikal kreuzen. Spans mit von null verschiedenem Angle lassen sich leicht verwerfen, bevor Sie Text für die Indexierung zusammenführen
Die beiden Quellfelder sind das, was aus einem Suchtreffer etwas macht, das man zeichnen kann. Sie indizieren die Zeichenfolge der Seite, also wandelt sich eine in einem Block gefundene Phrase direkt in Character Boxes für ein Highlight um, mit dem Ansatz aus visueller Textzeilenauswahl mit Character Boxes. Ist die umgebrochene oder HTML-Form der Seite das Ziel, speisen dieselben Blöcke das Reflow-Modell und seinen HTML-Export
Ein Zeichenbudget und zwei Qualitätszähler
MaxCharacters weist eine Seite rundherum ab, wenn sie mehr Zeichen enthält als erlaubt. GetStructuredText prüft die Zahl, bevor es irgendwelche Arbeitsarrays alloziert, und eine überdimensionierte Seite wirft EPdfError mit der Meldung Structured text character budget exceeded; eine teilweise Seite wird nie zurückgegeben. Der Wert muss positiv sein. Der zeichenweise Snapshot pro Seite, den die Methode liest, hat seine eigene Default-Decke von 1.000.000 Zeichen und 100.000 Textobjekten, gemeldet als Text snapshot budget exceeded, also lässt das Setzen von MaxCharacters über eine Million keine größere Seite durch
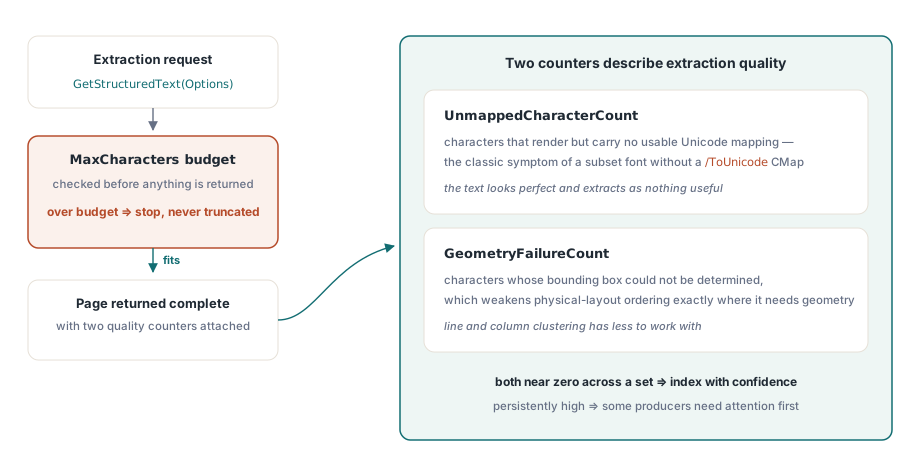
UnmappedCharacterCount zählt Zeichen, für die PDFium überhaupt keinen Unicode-Wert erzeugen konnte. Diese Zeichen erscheinen als U+FFFD in jedem Text-Feld. Die übliche Ursache ist eine Subset-Schriftart mit eigener Kodierung und ohne /ToUnicode-CMap, der Fall, den ISO 32000-1 §9.10.2 beschreibt, wo Text korrekt rendert und sich nicht zuverlässig extrahieren lässt. Der Zähler misst nur fehlende Zuordnungen: Ein Glyph, dessen /ToUnicode-Eintrag den falschen Codepoint nennt, zählt als zugeordnet, also kann eine Seite plausibel aussehenden Datenmüll weiterhin null melden
GeometryFailureCount zählt Zeichen ohne brauchbare Box, Zeilenumbrüche ausgenommen. In Content Order folgen solche Zeichen schlicht ihren Nachbarn. In physical layout haben sie keine Position, nach der sie sortiert werden könnten, also werden sie hinter jedes positionierte Zeichen gesetzt und hängen am Ende an der untersten Zeile der Seite. Eine Seite mit von null verschiedenem Geometry-Zähler und seltsamen Fragmenten auf ihrer letzten Zeile zeigt genau das
// LogRejected und LogQuality sind Ihre eigenen Logging-Routinen
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // Aufnahmelimit für diese Pipeline
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // Zeichen- oder Snapshot-Budget
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Für eine Seite, die Sie nur als String brauchen, behandelt Extrahieren von Text aus PDF-Dokumenten die einfacheren Aufrufe, und Lesen und Schreiben von BDC- und MCID-Marked-Content geht eine Ebene unter den Strukturbaum. Das strukturierte Seitenmodell, der Readable-Content-Reader und der Reflow-Export kommen alle mit der Delphi- und Lazarus-Komponente, die auf der PDFium Component-Produktseite beschrieben ist