Ein blinder Benutzer öffnet einen Quartalsbericht in Ihrem glänzend neuen Delphi-Viewer, schaltet NVDA ein und hört zuerst die Seitenfußzeile, dann eine Zahlenspalte, dann den Titel, den jeder sehende Leser zuerst gelesen hätte. Oder hört gar nichts. Die Seite sieht auf dem Bildschirm perfekt aus, und genau darin liegt die Falle: Rendering und Lesen sind verschiedene Probleme, die von verschiedenem Code gelöst werden. Die Reihenfolge, in der ein PDF seine Glyphen zeichnet, muss nicht mit der Reihenfolge übereinstimmen, in der ein Mensch sie hören sollte, weshalb ein Viewer, der nur auf Rendering-Aufrufen aufbaut, ein tadelloses Bild und eine unbrauchbare Vorleseausgabe produziert. Die PDFium-Komponente, der VCL/LCL-Wrapper um die PDFium-Engine für Delphi, C++Builder und Lazarus, führt deshalb einen eigenen Satz an Lese-APIs mit sich. Die Zeichen-APIs können keine Lesereihenfolge rekonstruieren, die ihnen nie mitgegeben wurde
Ein barrierefreier Reader steht und fällt mit drei Dingen. Er muss eine Reihenfolge extrahieren, die ein Screenreader sprechen kann, einen sichtbaren Wort-Cursor auf dem halten, was die Stimme gerade sagt, und einräumen, wenn ein Dokument nie getaggt wurde, statt zu raten und so zu tun, als ob. Für jedes davon gibt es eine klar zuständige API und einen Fehler, der zuschlägt, wenn man das Detail auslässt
Die Lesereihenfolge lebt im Strukturbaum, nicht in der Zeichnungsreihenfolge
ISO 32000-1 §14.8 definiert die logische Struktur als Baum aus Elementen, der über dem Seiteninhalt liegt. PDF/UA (ISO 14289-1) geht weiter und macht diesen Baum zur Pflicht: Jedes echte Inhaltselement muss in Lesereihenfolge über ihn erreichbar sein, und Seiten-Artefakte müssen als solche markiert und übersprungen werden. Ein korrekt getaggter Bericht weiß, dass „Quartalsergebnisse“ eine Überschrift der Ebene zwei ist und dass das Summenraster eine Tabelle mit Kopfzellen ist. Ein ungetaggter Bericht ist ein Haufen positionierter Glyphenläufe, die zufällig wie ein Dokument aussehen
ReadablePageContent durchläuft diese Struktur, wenn sie vorhanden ist, und liefert Fragmente zurück, die mit einer semantischen Kind-Kennzeichnung versehen sind, mit Werten wie cfHeading und cfParagraph, sodass die UI „Überschrift“ sagen kann, bevor die Wörter kommen, statt eine fette Zeile als normalen Fließtext vorzulesen. Ohne nutzbaren Baum fällt derselbe Aufruf auf eine heuristische Layoutanalyse zurück: Spalten erkennen, Grundlinien clustern, von links nach rechts und von oben nach unten ordnen. Dieser Fallback ist für ein einspaltiges Memo in Ordnung und wackelig für einen Newsletter, ein mehrspaltiges Formular, alles mit Seitenleiste oder Zitatkasten. Entscheidend ist, zu wissen, welches Ergebnis man erhalten hat, und die API sagt es unverblümt. Der Record TPdfReadableContent trägt ein Source-Feld, das auf rosStructure steht, wenn die Reihenfolge aus dem getaggten Baum stammt, oder auf rosHeuristic, wenn sie aus der Geometrie erschlossen wurde. Zeigen Sie eine geratene Reihenfolge, als wäre sie verifiziert, haben Sie die Barrierefreiheits-Version eines Erfolgs-Badges an einem Build ausgeliefert, den niemand je ausgeführt hat
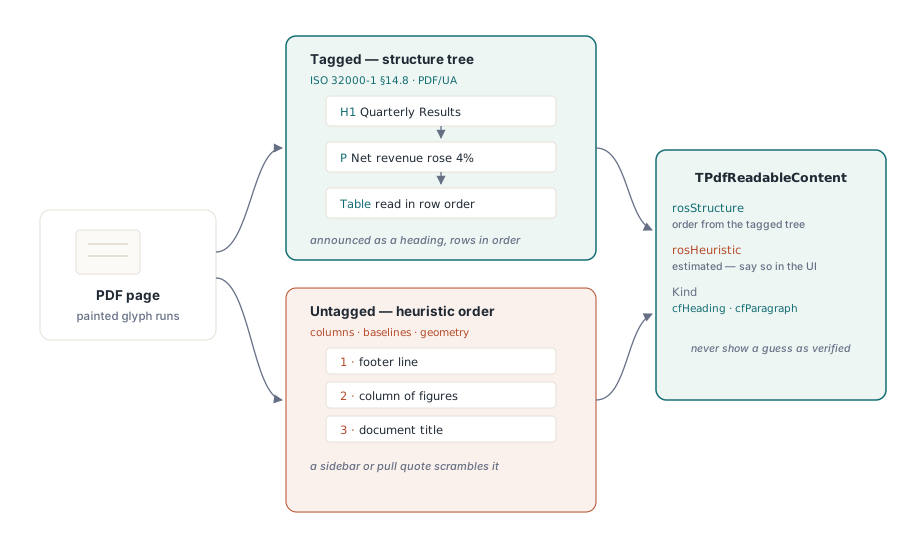
Der günstige Griff beim Öffnen besteht darin, IsTagged zu lesen und ValidatePdfUa einmal aufzurufen und die Antwort dann zwischenzuspeichern. Eine fehlgeschlagene PDF/UA-Prüfung ist kein Grund, die Datei abzuweisen. Sie ist ein Grund, „geschätzte Lesereihenfolge“ in die Statusleiste zu schreiben, damit der Support bei einer Kundenbeschwerde über verstümmelte Vorleseausgabe bereits weiß, ob er es mit einem Tagging-Problem der Datei oder mit einem Bug in Ihrem Code zu tun hat
Von der Seite zur Sprach-Warteschlange mit ReadingUnits
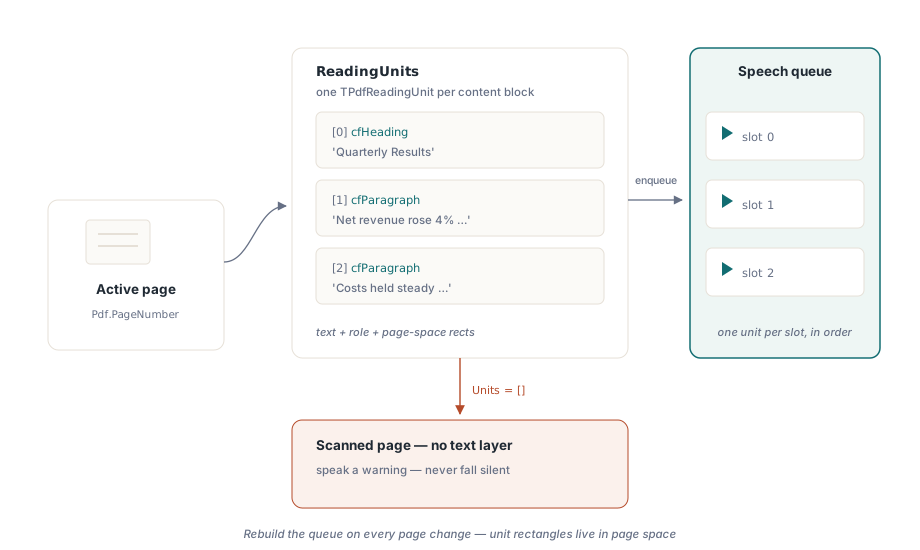
Für die Sprachausgabe erledigt ReadingUnits die Schwerstarbeit. Es liefert ein Array aus TPdfReadingUnit-Records für die aktive Seite, von denen jeder den vorzulesenden Text, seine semantische Rolle und die Rechtecke hält, die ihn auf der Seite verorten. Ein dokumentweiter Gefährte, DocumentReadingUnits, existiert, wenn Sie durchgehendes Lesen über Seitengrenzen hinweg wollen. Eine Einheit passt direkt in einen Slot einer Sprach-Warteschlange:
procedure TReaderForm.QueuePageSpeech(PageNumber: Integer);
var
  Units: TPdfReadingUnits;
  i: Integer;
begin
  Pdf.PageNumber := PageNumber;   // ReadingUnits arbeitet auf der aktiven Seite
  Units := Pdf.ReadingUnits;
  FSpeechQueue.Clear;
  for i := Low(Units) to High(Units) do
    FSpeechQueue.Add(Units[i]);  // Text + Semantik + Hervorhebungsrechtecke
  FCurrentPage := PageNumber;
  SpeakNextUnit;
end;
Zwei Dinge in dieser Schleife geraten leicht falsch. Halten Sie die Warteschlange pro Seite und bauen Sie sie bei jeder Navigation des Benutzers neu auf, denn Leseeinheiten tragen seitenbezogene Rechtecke; eine von Seite drei übrig gebliebene Warteschlange malt ihre Hervorhebungen auf Seite vier. Und behandeln Sie ein leeres Units-Array auf einer Seite, die erkennbar Inhalt hat, als Ihren Nur-Bild-Detektor. Eine gescannte Seite besteht aus Pixeln ohne Textebene darunter, und die richtige Antwort ist, eine Warnung vorzulesen („diese Seite hat keinen extrahierbaren Text“), statt stumm zu fallen, sodass der Hörer es nicht von einem Aufhänger unterscheiden kann
Ein Wort-Cursor, der der Stimme folgt
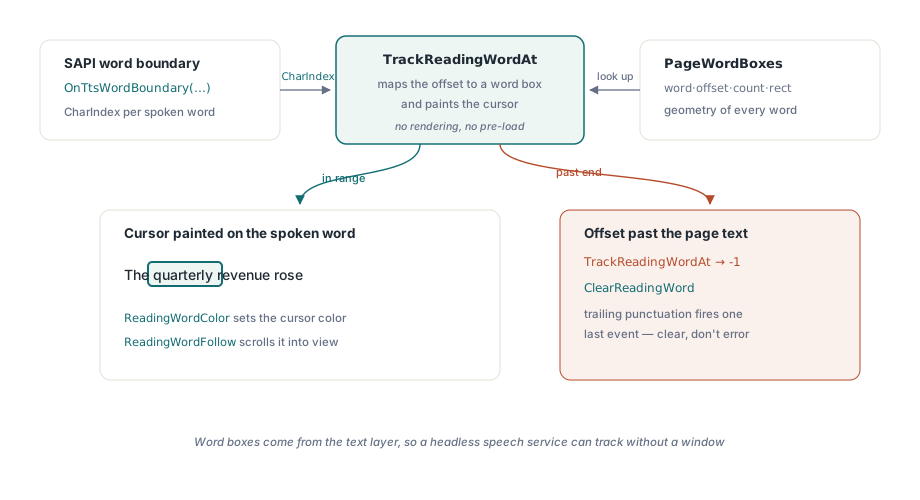
Ganze Absätze auf einmal hervorzuheben wirkt träge für einen sehbehinderten Benutzer, der die Wörter mit den Augen verfolgt, während sie vorgelesen werden. Hervorhebung auf Wortebene, der Karaoke-Effekt, braucht zwei Dinge: die Geometrie jedes Wortes und eine Möglichkeit, die Fortschrittsmeldungen der TTS-Engine auf diese Geometrie abzubilden. PageWordBoxes liefert die Geometrie als TPdfWordBox-Records, jeder mit dem Worttext, seinem Zeichen-Offset, seiner Zeichenanzahl und einem seitenbezogenen Rechteck. TrackReadingWordAt liefert die Abbildung. Übergeben Sie ihm die Zeichenposition, die das Wortgrenz-Ereignis von SAPI bereits meldet, und es löst diesen Offset zu einem Index im Wortfeld-Array auf und zeichnet den Cursor in einem einzigen Aufruf auf das passende Wort
procedure TReaderForm.PrepareKaraoke(PageNumber: Integer);
begin
  // Die Wortfelder der Ansicht stammen von der Seite, die die Ansicht anzeigt.
  // Pdf.PageNumber allein zu setzen würde die Ansicht nicht bewegen
  PdfView.PageNumber := PageNumber;
  FWordBoxes := PdfView.PageWordBoxes;
end;

procedure TReaderForm.OnTtsWordBoundary(Sender: TObject; CharIndex: Integer);
var
  WordIdx: Integer;
begin
  // TrackReadingWordAt bildet den Offset ab UND zeichnet den Wort-Cursor
  WordIdx := PdfView.TrackReadingWordAt(FCurrentPage, CharIndex);
  if WordIdx < 0 then
    PdfView.ClearReadingWord;  // die Grenze lief über den Seitentext hinaus
end;
Der Vertrag ist in einem Punkt großzügig und in einem anderen unerbittlich. Der großzügige Teil: TrackReadingWordAt hält seinen eigenen Wortfeld-Cache für die Seite, die es verfolgt, es gibt also nichts vorzuladen, und es findet gar kein Rendering statt, weil die Wortfelder aus der Textebene stammen. Ein Headless-Sprachdienst ohne sichtbares Fenster kann Positionen dennoch verfolgen. Der unerbittliche Teil: Der Zeichenindex muss in den Text zeigen, den die Komponente extrahiert hat, nicht in irgendeinen bereinigten String, den Sie selbst gebaut haben. Wenn CharIndex über das Ende des Seitentexts hinausläuft, gibt die Funktion -1 zurück, statt eine Exception auszulösen, was ständig passiert, wenn eine TTS-Engine ein letztes Grenz-Ereignis für abschließende Satzzeichen feuert. Lesen Sie -1 als „Cursor löschen“, nie als Fehler
Auf der Anzeigeseite setzt ReadingWordColor die Cursorfarbe. Das voreingestellte Bernstein hält auf den meisten Seitenhintergründen stand, aber testen Sie es unter jedem Anzeigefilter, den Ihr Viewer anbietet. Ein Bernstein-Cursor kann unter Farbinversion vollständig verschwinden, und Inversion parallel zur Sprachausgabe ist genau die Weise, wie ein sehbehinderter Benutzer arbeitet, weshalb die eine Kombination, die Sie am dringendsten richtig machen müssen, die ist, die eine schnelle Demo nie ausprobiert. Setzen Sie ReadingWordFollow auf True, und die Ansicht scrollt das gesprochene Wort von selbst in Sicht, worauf Sie bei einer gezoomten Seite, die über Bildschirme hinausreicht, nicht verzichten können. Beachten Sie eine Geltungsbereichs-Regel: SetReadingWord zeichnet nur auf der aktiven TPdfView-Seite. Entscheiden Sie vorab, ob manuelles Scrollen die Sprachausgabe pausiert oder das Folgeverhalten es übersteuert, denn wer sich für keins von beidem entscheidet, lässt die Stimme weiterlesen, während der Cursor irgendwo außerhalb des Bildschirms sitzt
Die Dokumente, die Ihren Reader brechen
Eine Handvoll Eingabeformen bringen eine naive Implementierung zuverlässig genug zu Fall, dass sie als dauerhafte Proben in die Regressionssuite gehören und nicht als einmalige Bugs, die man behebt und vergisst
- Ungetaggte, aber textreiche Dateien. Die heuristische Reihenfolge ist für einen linearen Bericht meist richtig und in dem Moment falsch, in dem eine Seitenleiste oder ein Zitatkasten auftaucht. Kennzeichnen Sie die Reihenfolge als geschätzt, sowohl in der UI als auch im Diagnoselog, damit der Fehlschlag später lesbar ist
- Reine Bildscans. Überhaupt keine Textebene. Fangen Sie sie über leere Leseeinheiten und verweisen Sie den Benutzer auf einen vorgelagerten OCR-Schritt, statt den Reader eine leere Seite vorlesen zu lassen
- Kombinierende Zeichen und gemischte Schriften. Unicode-Kombinationszeichen fallen nicht immer eins-zu-eins zu visuellen Wörtern zusammen, sodass die Anzahl der Wortfelder von dem abweichen kann, was Ihr eigener Tokenizer erwartet. Indizieren Sie das Wortfeld-Array nicht mit Offsets, die Sie durch selbst berechnetes Aufteilen des Texts gewonnen haben; verwenden Sie nur die Indizes, die
TrackReadingWordAtzurückgibt
Testen Sie wie ein Prüfer, nicht wie eine Demo
„Es hat meine Beispieldatei vorgelesen“ beweist nichts. Ein Bestehen, das Sie verteidigen können, führt drei Dateien durch den fertigen Build mit laufendem NVDA: eine als getaggt bekannte Datei, bei der Überschriften als Überschriften angesagt und eine Tabelle in Zeilenreihenfolge gelesen wird; eine als ungetaggt bekannte Datei, bei der der Indikator für die geschätzte Reihenfolge sichtbar ist; und einen Scan, bei dem die Warnung ohne Text tatsächlich ausgesprochen wird. Jede davon übt einen Pfad, den der Happy Case auslässt
Bestätigen Sie von dort, dass der Wort-Cursor bei doppelter und bei halber Sprechrate eingerastet bleibt und dass das Scrollen von ReadingWordFollow nicht mit dem Scrollen des Benutzers ringt. Lassen Sie dann die Sprachausgabe laufen, während Sie jeden Farbfilter durchschalten, und beobachten Sie, dass der Cursor nie verschwindet. Der Artikel zu Low-Vision-Farbfiltern in Delphi mit PDFium behandelt diesen Rendering-Pfad im Detail, und die Vertiefung zur Wort-für-Wort-TTS-Hervorhebung in Delphi-Viewern nimmt das TTS-Timing auseinander
Die oben verwendeten APIs für Leseeinheiten und Wortfelder werden mit PDFium Component für Delphi und C++Builder (VCL) sowie Lazarus/FPC (LCL) ausgeliefert. Die Produktseite verlinkt die vollständige API-Referenz, einschließlich der Record-Layouts für Leseeinheiten und Wortfelder hinter diesen Beispielen