Eine Vorlesefunktion hat neben der Stimme eine weitere sichtbare Aufgabe: Während jedes Wort gesprochen wird, muss dieses Wort auf der Seite aufleuchten und im Blickfeld bleiben. Dafür benötigen Sie die Bounding Box jedes Wortes, indiziert auf den gleichen Zeichenstrom (Character Stream), aus dem die Sprach-Engine vorliest. Haben Sie die Boxen, verfehlen aber die Indizierung, driftet die Hervorhebung ein oder zwei Wörter hinter dem Ton her; haben Sie die Indizierung, handhaben aber den Seitenstatus falsch, landet die Hervorhebung auf der völlig falschen Seite. Der Sprachteil davon, der Synthesizer selbst, geht selten kaputt. SAPI meldet Wortgrenzen auf das Zeichen genau. Was kaputtgeht, ist die dünne Zuordnungsschicht zwischen einem Zeichen-Offset im Sprachpuffer und einem Rechteck auf der gerenderten Seite
Die PDFium Component liefert diese Zuordnung für Delphi, C++Builder und Lazarus mit, wobei Wortboxen seit Version 1.53 und der Tracking-Cursor seit v1.56 verfügbar sind. Die API-Oberfläche ist absichtlich schmal gehalten: ein Aufruf, der die Wortboxen für eine Seite zurückgibt, ein Tracker, der einen Zeichen-Offset in eine gezeichnete Hervorhebung verwandelt, und ein paar Eigenschaften für Farbe und Auto-Scroll. So schmal sie auch ist, die Reihenfolge, in der Sie Dinge aufrufen, entscheidet darüber, ob die Funktion funktioniert, und die meisten der folgenden Fehler resultieren daraus, dass die richtigen Funktionen in der falschen Reihenfolge aufgerufen wurden
Zeichen sind keine Wörter, und TTS-Engines sprechen in Zeichen
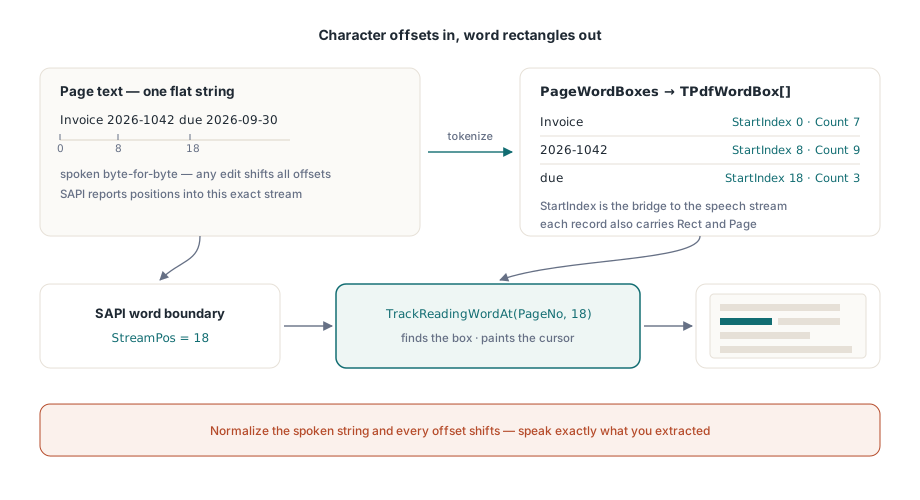
Eine Sprach-Engine verarbeitet einen flachen String und meldet den Fortschritt als Zeichenpositionen innerhalb dieses Strings. Eine PDF-Seite verfügt über Glyphen, die im Seitenraum platziert sind, wo ein „Wort“ eine heuristische Gruppierung von Glyphenläufen ist. Die beiden Koordinatensysteme haben nichts gemeinsam, es sei denn, der Text, den Sie dem Synthesizer übergeben, ist Byte für Byte der Text, aus dem die Wortboxen berechnet wurden. Das ist Regel Nummer eins, und sie ist unnachgiebig. Wenn Sie vor dem Vorlesen Leerzeichen normalisieren, weiche Trennzeichen entfernen oder den extrahierten Text auf andere Weise „aufräumen“, ist jeder nachgelagerte Offset unbemerkt falsch. Lassen Sie genau das vorlesen, was Sie extrahiert haben, oder pflegen Sie eine explizite Offset-Zuordnungstabelle. Es gibt keine dritte Option, die bei echten Dokumenten funktioniert
Die Neuzuordnungstabelle ist kein hypothetischer Randfall. In dem Moment, in dem Ihre Benutzeroberfläche eine gesprochene Seitenankündigung („Seite fünf“) einfügt oder eine Abkürzung für den Synthesizer ausschreibt, weicht der gesprochene String vom extrahierten ab. Protokollieren Sie die Position und Länge jeder Einfügung und ziehen Sie dann die kumulierte Anpassung vor jedem Tracking-Aufruf ab. Es sind vielleicht zwanzig Zeilen Buchführung, und es ist der Unterschied zwischen einer Hervorhebung, die die nächste Funktionsanfrage überlebt, und einer, die beim ersten Mal kaputtgeht, wenn jemand nach vorgelesenen Überschriften fragt
Was eine Wortbox Ihnen liefert
Jeder TPdfWordBox-Datensatz enthält den Text des Wortes, seinen StartIndex und die Zeichenanzahl (Count) innerhalb des Seitentextes, ein Seitenraum-Rechteck (Rect) und die 1-basierte Seitennummer (Page). Das Feld StartIndex ist die Brücke zwischen den beiden Koordinatensystemen: Es ist derselbe Offset, den SAPI beim Vorlesen zurückgibt. PageWordBoxes gibt das vollständige Array für die aktive Seite zurück:
procedure TReaderForm.PreparePage(PageNo: Integer);
begin
  PdfView.PageNumber := PageNo;   // Die Wortboxen der Ansicht verfolgen ihre angezeigte Seite

  FWords := PdfView.PageWordBoxes;
  FPageText := BuildSpeechText(FWords);   // Word.Text der Reihe nach verketten

  if Length(FWords) = 0 then
    HandleImageOnlyPage(PageNo);          // ein Scan ohne Textebene
end;
Der Kommentar zur Reihenfolge ist von tragender Bedeutung. Das PageWordBoxes des Viewers zerlegt die Textebene der aktuell vom View angezeigten Seite in Token; navigieren Sie also zuerst im View und extrahieren Sie danach; es ist kein Rendern erforderlich, nur ein geöffnetes Dokument. (Die Dokumentkomponente TPdf stellt für den Headless-Betrieb ein eigenes PageWordBoxes zur Verfügung, das an Pdf.PageNumber gebunden ist. Die beiden Seitennummern sind unabhängig voneinander, was eine eigene Falle darstellt.) Ein leeres Ergebnis auf einer Seite, die sichtbar Inhalt trägt, bedeutet, dass es sich um einen reinen Bildscan handelt. Leiten Sie dies an eine OCR weiter oder kündigen Sie es zumindest an („Seite 4 enthält keinen lesbaren Text“), anstatt die Stimme ohne Erklärung verstummen zu lassen
SAPI-Wortgrenzen mit dem Tracker verdrahten
TrackReadingWordAt im Viewer ist das Scharnier der gesamten Funktion. Geben Sie ihm eine Seitennummer und einen Zeichenindex; es findet die Wortbox, die dieses Zeichen enthält, malt den Lesecursor darauf und gibt den Wortindex zurück, oder −1, wenn der Index zwischen Wörtern fällt. SAPIs Wortgrenzen-Benachrichtigung liefert exakt die Zeichenposition, die es haben will:
procedure TReaderForm.OnSpeechWordBoundary(StreamPos: Integer);
var
  WordIdx: Integer;
begin
  // Bildet das Offset auf eine Wortbox ab und verschiebt die Hervorhebung in einem Aufruf
  WordIdx := PdfView.TrackReadingWordAt(FPageNo, StreamPos);
  if WordIdx < 0 then
    Exit;                     // Grenze lag außerhalb jedes Wortes: letzte Hervorhebung beibehalten
end;
Zwei defensive Details machen sich hier bezahlt. Erstens hält TrackReadingWordAt einen eigenen Wortbox-Cache für die verfolgte Seite bereit, der bei Seitenwechseln automatisch neu erstellt wird, sodass die Kosten pro Grenze flach bleiben, egal wie schnell die Grenzen eintreffen. Zweitens prüft es die Grenzen nicht großzügig. Ein Index bei oder über der Zeichenanzahl der Seite hinaus gibt −1 zurück, anstatt auf das letzte Wort zu klammern. Behandeln Sie −1 als „vorherige Hervorhebung beibehalten“, niemals als Fehler, denn Satzzeichen und Leerzeichen zwischen Wörtern erzeugen legitimerweise Grenzen, die zu keinem Wort gehören. Jedes −1 zu protokollieren, wird Sie überfluten. Zählen Sie sie stattdessen pro Seite und schauen Sie sich jede Seite genau an, auf der die Quote sprunghaft ansteigt, da dies normalerweise auf eine Diskrepanz bei der Textnormalisierung (zurück bei Regel 1) hinweist
Der Cursor selbst: Farbe, Folgen und Aufräumen
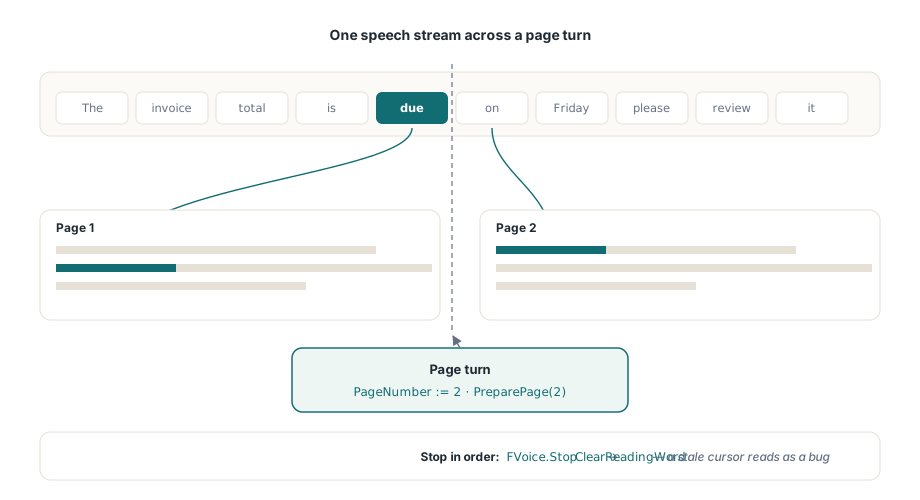
SetReadingWord malt die Hervorhebung direkt, wenn Sie die Wortbox selbst halten, ReadingWordColor formatiert sie, und ReadingWordFollow := True scrollt den View gerade weit genug, damit das gesprochene Wort sichtbar bleibt. Diese letzte Eigenschaft hat ihren Platz verdient. Ein handgestricktes „zentriere das aktuelle Wort“-Scrollen lässt die Seite bei jedem Zeilenumbruch ruckeln, und bewegungsempfindliche Leser schalten die gesamte Funktion innerhalb einer Minute ab. Die Hervorhebung wird nur auf der Seite gerendert, die im aktiven TPdfView gerade angezeigt wird, daher muss beim Lesen über mehrere Seiten PageNumber im Takt mit der Sprache weitersetzt und der Vorbereitungsschritt für die neue Seite erneut ausgeführt werden, bevor ihr erstes Grenzereignis eintrifft. Lässt man das weg, zeigen die ersten Hervorhebungen auf jeder Seite auf veraltete Koordinaten
procedure TReaderForm.StopReading;
begin
  FVoice.Stop;                // SAPI-Wiedergabe zuerst anhalten
  PdfView.ClearReadingWord;   // dann die Hervorhebung entfernen; ein veralteter Cursor sieht wie ein Bug aus
end;
Symmetrie beim Herunterfahren hält die Hervorhebung sauber. Jeder Pfad für Pause, Stopp und Seitenumbruch muss in ClearReadingWord enden. Lassen Sie es weg, und ein bernsteinfarbenes Rechteck bleibt auf einer gestoppten Seite liegen und sieht exakt wie ein Fehler aus – genau das, was jeder Tester als Bug melden wird, obwohl eigentlich nichts kaputt ist
Die Sprechgeschwindigkeit beansprucht diese Pipeline stärker als die Dokumentgröße. Bei 300 Wörtern pro Minute treffen die Grenzereignisse alle 200 ms ein, und bei den schnellsten SAPI-Raten kommen sie schneller, als das Auge bequem verfolgen kann. Die richtige Antwort darauf ist das Zusammenfassen (Coalesce), nicht das Einreihen (Queue). Wenn eine neue Grenze eintrifft, während ein Update der Hervorhebung noch aussteht, verwerfen Sie das alte und zeichnen Sie das neueste. Ein Cursor, der der Reihe nach jedes Wort besucht, aber eine halbe Sekunde hinterherhinkt, fühlt sich fehlerhaft an; einer, der gelegentlich ein Wort überspringt, aber synchron mit der Stimme bleibt, hingegen nicht
Grenzfälle, die Demos von echten Produkten unterscheiden
Einige Dokumentkategorien legen die Schwachstellen offen. Kombinierende Zeichen (Combining Characters) sind die subtilsten: Unicode-Sequenzen wie ein Basisbuchstabe plus ein kombinierendes diakritisches Zeichen können mehr Zeichenindizes belegen, als das visuelle Wort vermuten lässt, sodass jede Offset-Arithmetik, die von einem Index pro Glyphe ausgeht, langsam abdriftet. Das ist das stärkste Argument dafür, das Mapping von TrackReadingWordAt übernehmen zu lassen, anstatt Wortnummern von Hand zu berechnen. Silbentrennung ist banaler, aber weitaus häufiger: Ein Wort, das über einen Zeilenumbruch getrennt wird, wird zu zwei Boxen, und wenn Sie es als einzelnes Token aussprechen, wird das Grenzereignis für seine zweite Hälfte auf die erste Box aufgelöst. Das ist normalerweise in Ordnung, aber es ist eine Entscheidung, also treffen Sie sie absichtlich, anstatt sie zufällig zu entdecken. Tagging verändert die Lesereihenfolge selbst. Wenn ein Dokument ordnungsgemäße Struktur-Tags enthält (das Gebiet von ISO 14289, PDF/UA), folgt die Wortsequenzierung der logischen Struktur; ohne diese fällt sie auf Layout-Heuristiken zurück, und eine ungetaggte zweispaltige Seite kann geradewegs über beide Spalten hinweg vorgelesen werden. Rotierte Seiten sind der letzte häufige Fall: Das Rect jedes Wortes umrahmt es im Seitenraum immer noch korrekt, aber eine auf horizontalen Fluss abgestimmte Viewport-Follow-Richtlinie scrollt beim vertikal verlaufenden Text störend; behalten Sie also mindestens ein rotiertes Dokument im Regressionsset. Zur Handhabung der Lesereihenfolge, Einheiten auf Satzebene über ReadingUnits und dem breiteren assistiven Stack siehe das Erstellen eines barrierefreien PDF-Readers in Delphi
Eine Plattformbeschränkung bestimmt die Bereitstellung. SAPI ist Windows-exklusiv. Unter Lazarus und FPC sind die Wortrahmen- und Tracking-APIs identisch, aber Linux- und macOS-Builds müssen unterschiedliche Synthesizer an dieselben Grenzereignisse anhängen; diese Konfiguration ist im Betrieb des Viewers unter Lazarus und FPC enthalten. Sobald sich die Sprachgeschwindigkeit erhöht, interagiert der Overhead der Hervorhebung auch mit Ihrem Seitencache, und das Budget-Arithmetik-Regelwerk in Rendering-Cache und Zoom-Leistung gilt auch hier
Wenn die Worthervorhebung die falsche Granularität ist
Wortweises Karaoke ist nicht immer das, was ein Leser will. Bei hohen Sprechgeschwindigkeiten wird der Wort für Wort flackernde Cursor selbst zu visuellem Rauschen, und manche Hörer folgen einem Satz bequemer als einem Stroboskop einzelner Wörter. Für diesen Fall stellt die Komponente eine gröbere Einheit bereit. ReadingUnits liefert Einheiten auf Satz- und Blockebene, jede mit ihren eigenen Hervorhebungsrechtecken, und Sie malen sie mit SetReadingHighlight statt mit SetReadingWord. Die Verdrahtung hat dieselbe Form: Ein Grenz-Offset steuert weiterhin, welche Einheit aufleuchtet, nur dass die hervorgehobene Einheit einen Satzteil oder eine Zeile umspannt statt eines einzelnen Tokens. Langsamere Leser und Wiedergabe mit hoher Rate bevorzugen das in der Regel, und nichts hindert Sie daran, beide Modi hinter einer Einstellung anzubieten
Bevor Sie darauf aufbauen, lohnt es sich, die Versionsuntergrenzen festzuhalten: Wortboxen brauchen PDFium Component v1.53 oder höher, der Tracking-Cursor v1.56. Die vollständige Lese-API, die Einheiten auf Satzebene und eine funktionierende Vorlese-Demo finden Sie auf der Produktseite der PDFium Component