Das Attribut axis="rowAxis" an einem pivotField-Element liest sich wie völlig sinnvolle XML, und ein Reader, der es auf „Zeilenfeld“ mappt, lädt den Pivot mit jedem Feld auf der richtigen Achse. Läuft derselbe Teil durch einen Validator, gebaut aus dem ECMA-376-Teil-1-§18.10-Schema, failt er am ersten Attribut: ST_Axis hat exakt vier Tokens, axisRow, axisCol, axisPage und axisValues, und rowAxis ist keiner davon. Ein Pivot-Writer muss das Schema befriedigen, nicht den eigenen Reader, denn die Leute, die die Datei öffnen, benutzen Excel und ihre eigenen Parser
Pivot-Felddefinitionen sind voller Regeln wie dieser. Drei rutschen gern durch einen Roundtrip-Test: die Enumerations-Tokens, die Forderung, dass ein items-Element nie leer ist, und die abschließenden Subtotal-Einträge, die Excel hinter den Daten-Items listet. Zwei weitere sitzen auf der Leseseite, in Attributen, die Excel weglässt, weil sie ihren Schema-Default halten. Der Rest dieses Artikels geht jede Regel durch, zeigt, wie das XML aussehen muss, und zeigt die Delphi-Aufrufe, die es erzeugen
Warum ein Roundtrip ein falsches Achsen-Token nicht fangen kann
Ein Roundtrip beweist, dass Writer und Reader sich miteinander einig sind, und nichts weiter. Akzeptiert der Reader sowohl axisRow als auch rowAxis, besteht ein Writer, der das falsche emittiert, jede Speichern-dann-Laden-Prüfung, die man schreiben kann, denn der Reader repariert den Fehler auf dem Weg zurück. Der Fehler zeigt sich erst, wenn ein strengerer Consumer den Teil öffnet: ein Schema-Validator, ein aus der XSD generierter Parser oder Excel, das beschließt, der Teil brauche Reparatur
HotXLS trennt die beiden Seiten mit Absicht. Der XLSX-Writer emittiert nur die vier ST_Axis-Tokens, während der Pivot-Reader zusätzlich die englisch anmutenden Schreibweisen rowAxis, colAxis, pageAxis und dataAxis auf die passende Achse mappt, sodass Dateien von Producern, die sie benutzen, mit intaktem Layout weiterladen. Die Ausgabe wird am Schema gemessen; die Eingabe muss nur erkennbar sein. Umgekehrt, ein strenger Reader gepaart mit einem schlampigen Writer, würde zumindest laut in den eigenen Tests scheitern; ein nachsichtiger Reader gepaart mit einem schlampigen Writer scheitert nirgends, wo man es sehen kann
<!-- ungültig: rowAxis ist kein ST_Axis-Wert, und CT_Items darf nicht leer sein -->
<pivotField axis="rowAxis" defaultSubtotal="1"><items count="0"></items></pivotField>

<!-- gültig: ST_Axis-Token, echte Items, abschließendes Default-Subtotal -->
<pivotField axis="axisRow" defaultSubtotal="1">
  <items count="4"><item x="0"/><item x="1"/><item x="2" h="1"/><item t="default"/></items>
</pivotField>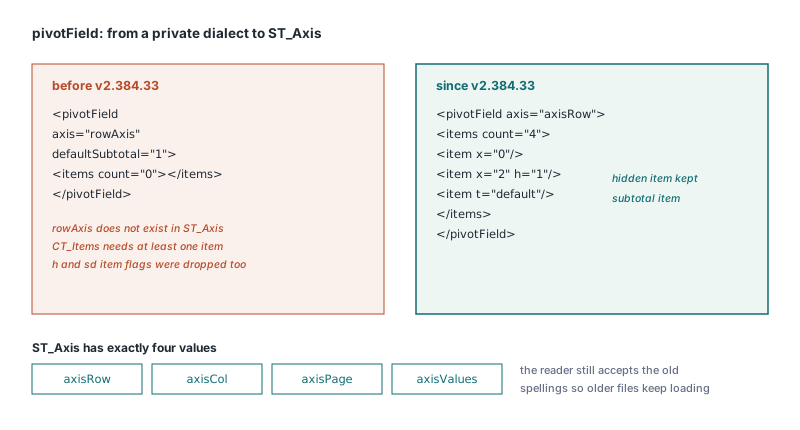
Was CT_PivotField jenseits der Achse erwartet
CT_PivotField hat drei weitere Anforderungen, die leicht verloren gehen. Ein im Wertebereich aggregiertes Feld muss das auf seiner eigenen Definition mit dataField="1" sagen, obwohl die <dataFields>-Liste es bereits referenziert. HotXLS setzt dieses Flag auf jedem Pivot-Feld, auf das ein Eintrag in DataFields zeigt, ein mit AddDataFieldByName ergänztes Feld ist also an beiden Stellen markiert
Die zweite Regel ist strukturell. CT_Items verlangt mindestens ein item-Kind, was <items count="0"></items> ungültig macht, obwohl es wohlgeformtes XML ist und überall parst. Hat ein Feld keine Items, lässt HotXLS das ganze items-Element weg. Die dritte Regel betrifft den Zustand je Item: Ein verstecktes Mitglied trägt h="1", ein Mitglied mit eingeklappten Details sd="0". Beides kommt aus TXLSPivotItem.IsHidden und TXLSPivotItem.IsDetailHidden und wird bei jedem Speichern geschrieben, ein im Code gesetzter Filter überlebt also bis nach Excel
Abschließende Subtotal-Items und die Count-Falle
Hat ein Feld Items, folgt Excel den Daten-Items mit je einem zusätzlichen item pro Subtotal-Funktion, typisiert mit ST_ItemType. Das automatische Subtotal ist <item t="default"/>; explizite Funktionen benutzen sum, countA, avg, max, min, product, count, stdDev, stdDevP, var und varP. Diese Einträge tragen keinen x-Index in den Cache, und sie zählen im count-Attribut von items mit. Ein Writer, der sie weglässt, produziert eine Items-Liste, die nicht mehr zu den Subtotal-Flags desselben Elements passt
HotXLS leitet die Kette beim Speichern aus TXLSPivotField.Subtotals ab: ein t="…"-Item pro Funktion in der Menge, in Enumerationsreihenfolge, in den Count eingerechnet, dazu das passende sumSubtotal="1"-artige Attribut am Feld. Von AddPivotTable erzeugte Felder starten mit leerer Menge, was defaultSubtotal="0" und überhaupt kein abschließendes Item schreibt. Lassen Sie die Menge bei generierten Berichten leer: Subtotal-Zeilen verändern die Höhe des Pivots und verschieben alles, was darunter steht. Ergänzen Sie Funktionen in Subtotals nur auf den Feldern, wo ein Leser die zusätzlichen Zeilen braucht
Die Benennung verdient einen zweiten Blick, bevor man eine Funktion wählt. xlpsCount mappt auf countA, das alle nicht leeren Einträge zählt, und xlpsCountNums mappt auf count, das nur Zahlen zählt. Wer in der XML "count" liest und nach xlpsCount greift, bekommt die andere Funktion
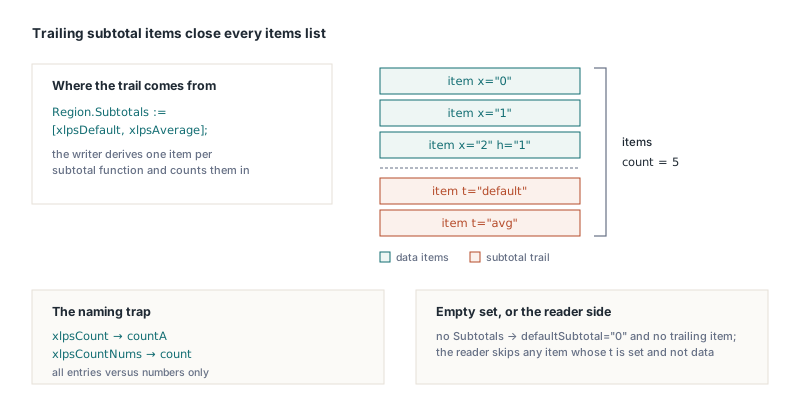
Das Programm unten baut aus einem bestehenden Datenblatt einen Pivot mit einem Zeilenfeld, einem Spaltenfeld und einem Wertfeld. Das Region-Feld bekommt das automatische Subtotal plus einen Durchschnitt, was zwei abschließende Items hinter seinen Daten-Items und dataField="1" an Revenue ergibt
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book  : TXLSXWorkbook;
  Sheet : TXLSXWorksheet;
  Pivot : TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    Sheet := Book.Sheets[1];                  // Sheets ist 1-basiert
    Pivot := Sheet.AddPivotTable('Data!$A$1:$D$800', 3, 6, 'RegionTotals');
    if Pivot = nil then
      raise Exception.Create('Bad source range or anchor');

    Region := Pivot.AddRowField('Region');    // nil, wenn es kein solches Feld gibt
    if Region <> nil then
      Region.Subtotals := [xlpsDefault, xlpsAverage];  // -> t="default", t="avg"
    Pivot.AddColumnField('Quarter');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);      // Revenue bekommt dataField="1"

    Book.SaveAs('orders-pivot.xlsx');
  finally
    Book.Free;
  end;
end;
Lesen, was Excel weglässt
Der Reader hat das Spiegelbild des Problems. Ein von Excel erzeugtes Pivot-Feld listet seine Subtotal-Einträge in items, sie als gewöhnliche Mitglieder zu laden gäbe dem Feld Phantom-Items, die auf keinen Cache-Wert zeigen. HotXLS überspringt jedes item, dessen t-Attribut vorhanden und nicht data ist, was Subtotal-, Grand-Total- und Leer-Einträge abdeckt. Die Subtotal-Funktionen kommen über die eigenen Flags des Felds und landen in Subtotals, Code, der Items abläuft, sieht also nur echte Mitglieder, und jeder CacheItemIndex verweist auf einen Cache-Wert
Die fehlenden Attribute sind die andere Hälfte. Im Schema stehen defaultSubtotal an CT_PivotField und containsString an CT_SharedItems beide auf true, und Excel lässt sie weg, wenn sie diesen Wert halten. HotXLS liest ein fehlendes defaultSubtotal als true und ergänzt xlpsDefault in Subtotals, wenn das Feld keine expliziten Subtotal-Flags trägt, so zeigt Excel selbst ein solches Feld an. Ein fehlendes containsString liest sich ebenfalls als true, ein schlichtes Text-Cache-Feld wird also als String-Daten klassifiziert. Liest man eines der Attribute als false, verliert jeder von Excel gespeicherte Pivot beim Laden seine automatischen Subtotals, und Textfelder werden zu irgendeinem anderen Typ. Ein Writer, der jedes Attribut immer ausschreibt, berührt diesen Pfad nie; nur Dateien von einem anderen Producer legen ihn offen
Eine geladene Excel-Arbeitsmappe ist hier die richtige Test-Eingabe, denn sie ist die einzige Art Datei, die diese Attribute weglässt. Die Prüfung unten öffnet eine und läuft ein Zeilenfeld durch:
var
  Book : TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Fld  : TXLSPivotField;
  I, J : Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('saved-by-excel.xlsx');
    Pivot := Book.Sheets[1].PivotTables.FindByName('PivotTable1');
    if Pivot = nil then
      Exit;
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Fld := Pivot.Fields[I];
      if Fld.Axis <> xlpfaRowField then
        Continue;
      // Ein Excel-Feld ohne Subtotal-Attribute meldet trotzdem den Default
      if xlpsDefault in Fld.Subtotals then
        Writeln(Fld.Name, ': automatic subtotal');
      // Subtotal-Einträge wurden übersprungen, jedes Item mappt also auf einen Cache-Wert
      for J := 0 to Fld.ItemCount - 1 do
        Assert(Fld.Items[J].CacheItemIndex >= 0);  // Prüfung, für eigene Tests vorgeschlagen
    end;
  finally
    Book.Free;
  end;
end;
Warum numFmtId="General" auf Cache-Feldern ungültig ist
numFmtId="General" ist ungültig, weil ST_NumFmtId eine vorzeichenlose Ganzzahl ist, so naheliegend es ist, den Namen zu borgen, den Nutzer im Dialog Zellen formatieren sehen. Ein Parser, der Attribute nach dem Schema typisiert, weist den Namen rundheraus zurück, und genau diese Fehlerklasse wird zum Reparatur-Dialog in Excel; der Artikel über die OPC- und Markup-Regeln hinter dem Excel-Reparatur-Prompt behandelt, wie diese Dialoge ausgelöst werden. HotXLS schreibt jedes cacheField mit einer numerischen numFmtId aus dem NumberFormat des Cache-Felds, also 0, das eingebaute General-Format, sofern nichts anderes gesetzt wurde
Pivot-Tables unterhalb Zeile 65535 brauchen 32-Bit-Positionen
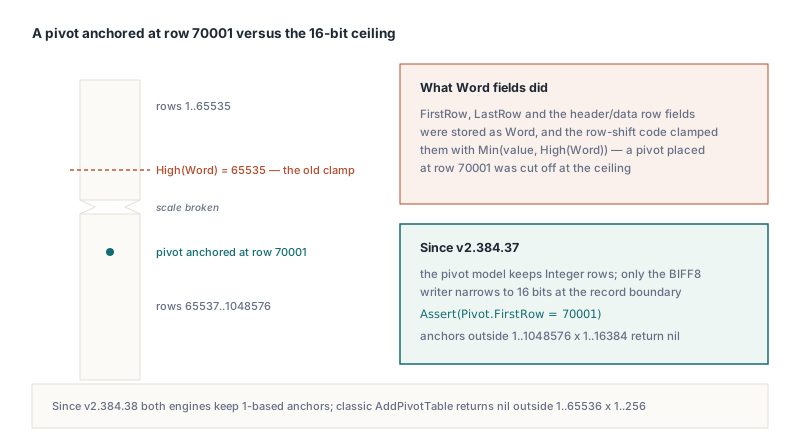
Ein von der XLS- und der XLSX-Engine geteiltes Pivot-Modell versucht sich leicht, seine Feldbreiten beim BIFF8-SxView-Record zu borgen, wo 16 Bits jede Zeile abdecken, die ein klassisches Blatt halten kann. Ein XLSX-Blatt läuft bis 1.048.576 Zeilen. Speichert man FirstRow, LastRow, FirstHeaderRow, FirstDataRow und die Spalten-Pendants als Word und klemmt sie mit Min(Value, High(Word)), wird ein Pivot, das in Zeile 70001 verankert ist, bei 65535 abgeschnitten
An TXLSPivotTable sind diese Properties Integer, und nur der BIFF8-Writer macht sie an der Record-Grenze schmaler. TXLSXWorksheet.AddPivotTable liefert nil für einen Anker außerhalb 1..1048576 mal 1..16384, und AddPivotTableCopy liefert nil, wenn die Ausdehnung der Kopie übers Raster hinausliefe
var
  Book, Check: TXLSXWorkbook;
  Pivot      : TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    // Zeile 70001 liegt jenseits des 16-Bit-Bereichs
    Pivot := Book.Sheets[1].AddPivotTable('Data!$A$1:$D$800', 70001, 1, 'LateTotals');
    if Pivot = nil then
      Exit;  // Anker außerhalb des Sheets oder unauffindbarer Quellbereich
    Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);
    Book.SaveAs('late.xlsx');
  finally
    Book.Free;
  end;

  Check := TXLSXWorkbook.Create;
  try
    Check.Open('late.xlsx');
    Pivot := Check.Sheets[1].PivotTables.FindByName('LateTotals');
    // Assert ist eine Prüfung, für eigene Tests vorgeschlagen
    Assert((Pivot <> nil) and (Pivot.FirstRow = 70001));
  finally
    Check.Free;
  end;
end;
Die klassische XLS-Engine folgt derselben 1-basierten Konvention. Die SxView- und DConRef-Records speichern nullbasierte Werte, während das Modell, wie die XLSX-Engine und Cells[Row, Col], 1-basierte Positionen hält: Der BIFF8-Reader addiert 1, der Writer subtrahiert 1 an der Record-Grenze. Das klassische AddPivotTable liefert nil für einen Anker außerhalb 1..65536 mal 1..256, verankern Sie Pivots also bei (1, 1) statt bei (0, 0). Das Record-Layout selbst wird in den BIFF8-SX-Records hinter klassischen .xls-Pivot-Tables beschrieben
Am Schema testen statt am eigenen Reader
Jede Falle oben übersteht einen Roundtrip, solange die nachsichtige Seite und die fehlerhafte Seite in derselben Bibliothek wohnen. Drei Arten von Prüfung fangen sie. Eine Schema-Validierung der erzeugten pivotTableN.xml- und pivotCacheDefinitionN.xml-Teile fängt erfundene Tokens, leere items-Elemente und benannte Format-IDs. Von Excel gespeicherte Dateien, durch den eigenen Reader geschickt, üben die Attribute aus, die Excel an ihren Defaults weglässt. Assertions, die das exakte Token im geschriebenen XML festnageln, etwa axis="axisRow", fangen einen Writer, der zu einer Schreibweise zu driften beginnt, die nur der eigene Reader versteht; auf der geparsten Achse zu behaupten kann das nicht
Über die API gebaute Pivots, einschließlich der in Bau und Aktualisierung von XLSX-Pivot-Tables mit berechneten Feldern gezeigten berechneten Felder, berechneten Items und Prozent-von-Gesamt-Layouts, kommen mit diesen Regeln heraus, ohne Zusatzcode auf Ihrer Seite. Die Arbeit, die Ihnen bleibt, ist zu wählen, welche Felder Subtotals bekommen und welche Count-Funktion Sie meinen
Die HotXLS Delphi spreadsheet component baut, liest und speichert XLS- und XLSX-Pivot-Tables aus Delphi- und C++Builder-Code, ohne Excel-Installation oder COM-Automation auf der Maschine, auf der sie läuft